
数据的表示与计算
第二章_数据的表示与计算
2.1 进制和计算
2.1.1 进位计数制
本节主要内容为:
- 其他进制怎么转换成十进制:各位基数*权重再相加即可。
- 二进制、八进制和十六进制之间相互转换:不想多说,懂得都懂。
- 十进制怎么转换成其他进制:
整数部分除 r 取余,如图所示:
 整数部分乘 r 取整,如图所示:
 想再快一点可以凭直觉拼凑。
值得注意的是各进制有不同的书写方式,如图所示:

2.1.2 定点数的编码表示
首先明确区分概念:定点数和浮点数、真值和机器数。
真值是现实中人类常用的数,机器数是需要将正负符号使用数字表示。根据小数点的位置是否固定,计算机中的数值表示分为定点表示和浮点表示。
机器内部通常会使用定点数把小数部分和整数部分分开表示。但在机器内部,并没有小数点的区分,只是人为的约定了小数点的位置以方便人们进行计算。因此,在定点数的编码和计算中,无须区分该数是小数还是整数,只需关心符号位和数值位(尾数)即可。
定点数的编码表示法主要有四种:
原码、反码、补码和移码:
原码:
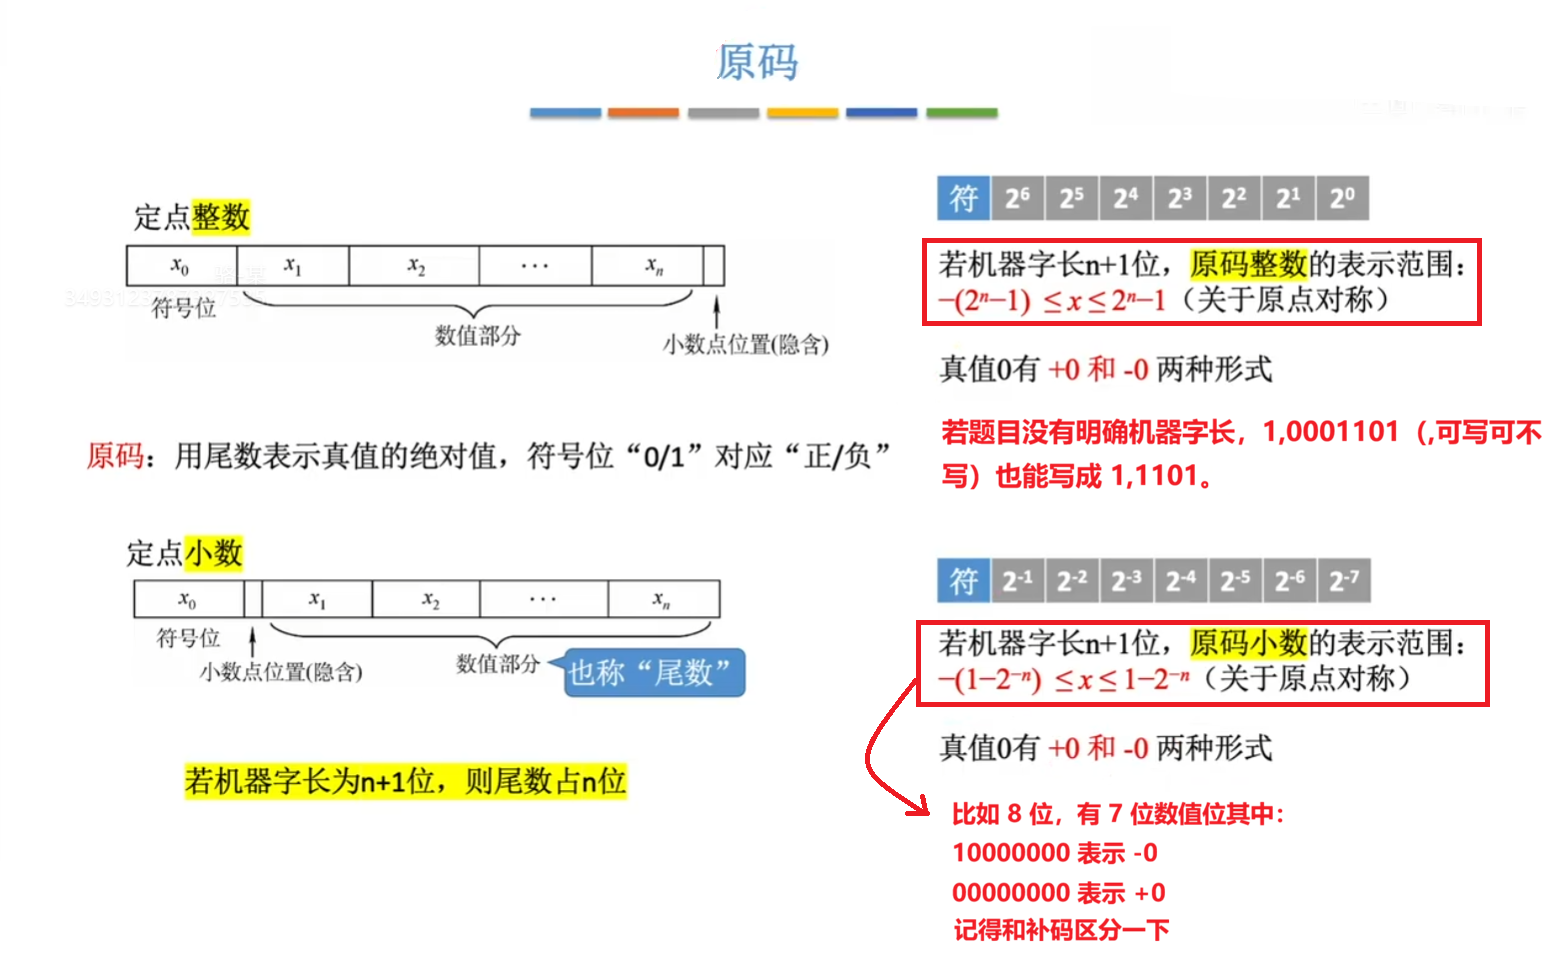 反码:
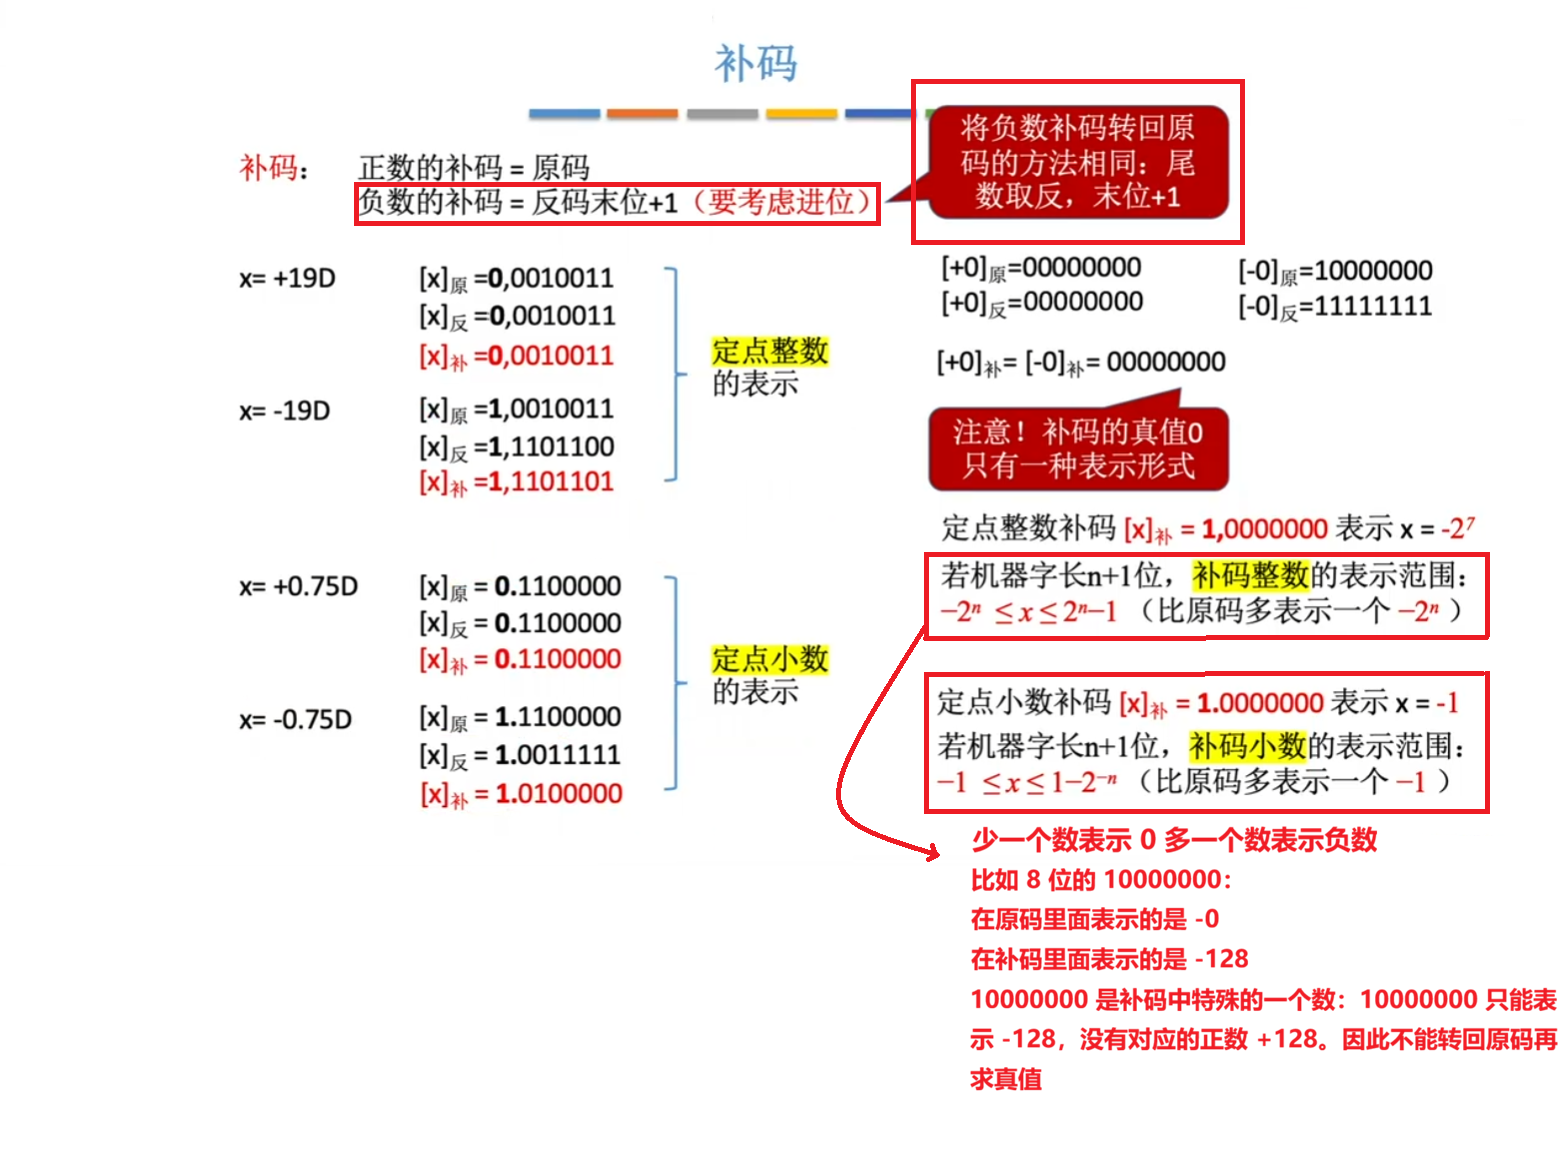
 补码:
注意:补码同一符号下的数值位对应的二进制数越大,对应的真值越大。
 移码:
注意:移码的正确计算步骤是 移码 = 真值(十进制) + 偏移量(十进制),然后直接用二进制表示(不是原码也不是转成补码,可以直接看成无符号数!)偏移量一般为 2n-1 ,此时对于同一真值,移码会刚好等于补码符号位取反!
至于移码的作用,移码主要用于表示浮点数的阶码,因为阶码需要经常进行大小比较;采用移码后,二进制数(全部位)越大,对应的真值越大。
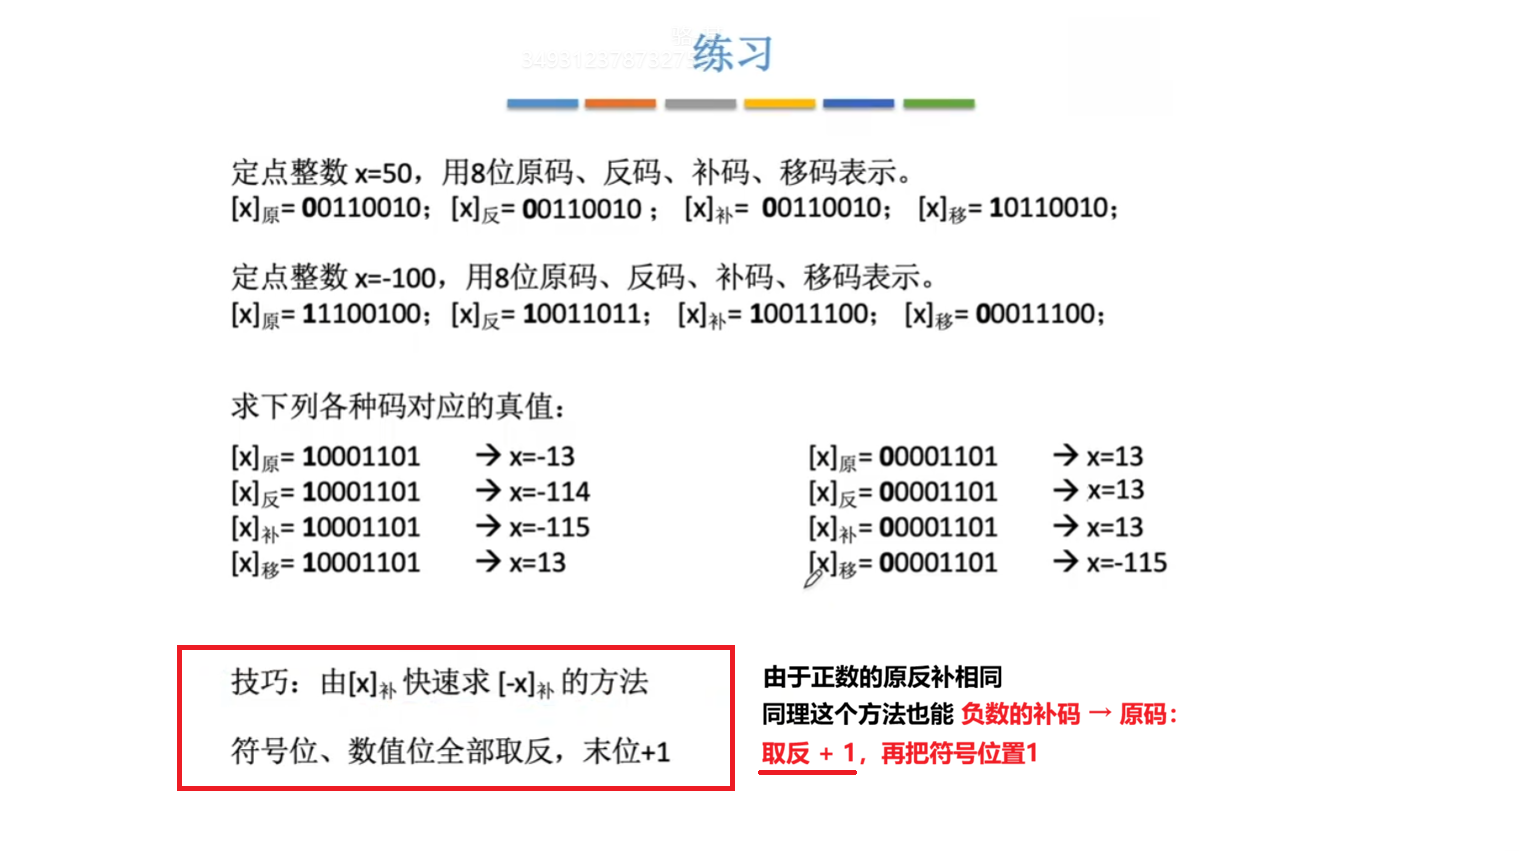
 以题目来熟悉这几个“码”,注意做题技巧:
补码的作用: 在计算机硬件的实现过程中,加法器的实现难度小于减法器的实现难度,而一个计算机的底层如果既要实现加法器又要实现减法器,会显得冗余。所以能不能只使用加法器实现加法和减法呢?
在 模运算 中,如果两个数绝对值相加等于模,那么这两个数互为对方的 补数,利用这个性质,在减去一个数的时候,只需要加上这个数的补数即可。即 原码 A − 原码 B = 原码 A + 补码 B,而补码就是这个二进制补数,模通常就是机器字长(比如 28 bit)。
如果使用数学手段严谨的证明补码为什么等于原码的补数,需要很多数论的知识,这里就不做展开,记住怎么求即可。
2.1.3 C语言中的数据类型转换
2.1.3.1 定点数类型间强制转换
考研中,定点数不用管小数,默认定点数都是顶点整数。
C语言中的定点数类型转换内部原理如图所示:
 强制转换处理过程总结如下:
| 情况 | 怎么处理 |
|---|---|
| 有符号短 → 有符号长(长度变化) | 符号扩展 |
| 无符号短 → 无符号长(长度变化) | 0 扩展 |
| 长 → 短(长度变化) | 直接保留低位 |
| 同位数,有符号 ↔ 无符号(符号变化) | 二进制位不变,只改变解释方式 |
| 短 → 长,改变符号(混合变化) | 先扩展,再按新类型解释 |
注意:有符号数是补码存储!!无符号数是普通二进制存储!!(具体运算过程文字难以简明的解释,做几个题就懂了)。
2.1.3.2 定点数类型间作运算
C语言中,不同类型定点数做运算:
- 相同位数下,有符号数按无符号数解释,再进行运算,
- 至于运算过程中的两数据类型的位数长度不同,直接查下方的表格(都不想管这个了)
举个例子如下:
先按无符号类型运算,运算结果再在赋值时转换成 unsigned int :
unsigned j = 0; //32 位全 0
j = j - 1;//考研整型常数默认为 int ,结果得 32 位全 1(这里其实溢出了)

先按无符号类型运算,运算结果再在赋值时转换成 int :
unsigned int u = ...;
int a = u + 1;
| 两种类型参与运算 | 最终按什么类型运算 | 记忆 |
|---|---|---|
char + char |
int |
都先提升 |
short + short |
int |
都先提升 |
char + int |
int |
小整数 → int |
short + int |
int |
小整数 → int |
unsigned char + int |
int |
unsigned char 先提升 |
unsigned short + int |
int |
常见32位环境下 |
unsigned int + int |
unsigned int |
重点 |
unsigned int + unsigned int |
unsigned int |
同类 |
int + long |
long |
长度更长 |
unsigned int + long |
视 long 位数而定 |
重点陷阱 |
unsigned int + unsigned long |
unsigned long |
同为无符号,长的 |
int + unsigned long |
unsigned long |
无符号长类型 |
long + unsigned long |
unsigned long |
无符号长类型 |
int + float |
float |
整数 → 浮点 |
unsigned int + float |
float |
整数 → 浮点 |
long + float |
float |
整数 → 浮点 |
float + double |
double |
float → double |
int + double |
double |
整数 → double |
2.1.3.3 涉及浮点数的强制转换
- 定点数转浮点数: 先变成真值再转浮点数,注意精度问题。
- 浮点数转定点数: 小数部分直接截断,精度可能丢失。
- double 转 float(了解):因为两者偏置值不同,阶码需要重新计算;由于 float 尾数位更少,需要截断并按舍入规则处理,因此可能发生精度丢失;数值过大时还可能发生浮点数溢出。
- float 转 double(了解):因为两者偏置值不同,阶码需要重新计算;由于 double 尾数位更多,原 float 尾数全部保留,后面补 0,因此不会发生精度丢失(对可表示的正常有限 float 值而言)。
2.2 运算方法与运算电路
2.2.1 数电基础知识
基本逻辑门电路概括如下,很简单,不用深究其数字逻辑电路细节:
注意运算优先级是:非 > 与 > 或。


多路选择器、三态门:
这是两个常见的数字逻辑电路使用部件,具体介绍如下图所示:


2.2.2 基本运算部件
2.2.2.1 一位全加器
一位全加器示意如图所示:

2.2.2.2 串行进位全加器
将 n 个一位全加器串起来,就能够得到多位串行进位全加器,如图所示:

2.2.2.3 并行进位加法器
而串行进位加法器,这种加法器的运算速度依赖于进位输出的速度,故而速度会很慢,将多个一位全加器的进位输出信息连接到一个 CLA 部件(先行逻辑进位),形成并行进位加法器,就能够大大提高处理效率。
如图所示:

2.2.2.4 ALU 与 标志位
ALU 是运算器的核心,而由于四则运算在计算机中都是通过加法进行实现,因此 加法器是 ALU 的核心,其功能如下图所示:
 考研不会考察 ALU 的组成,但 ALU 的图示是需要看懂的,ALU 通过控制信号 OP 执行不同的功能,如 ADD,SUB 等。如图所示:
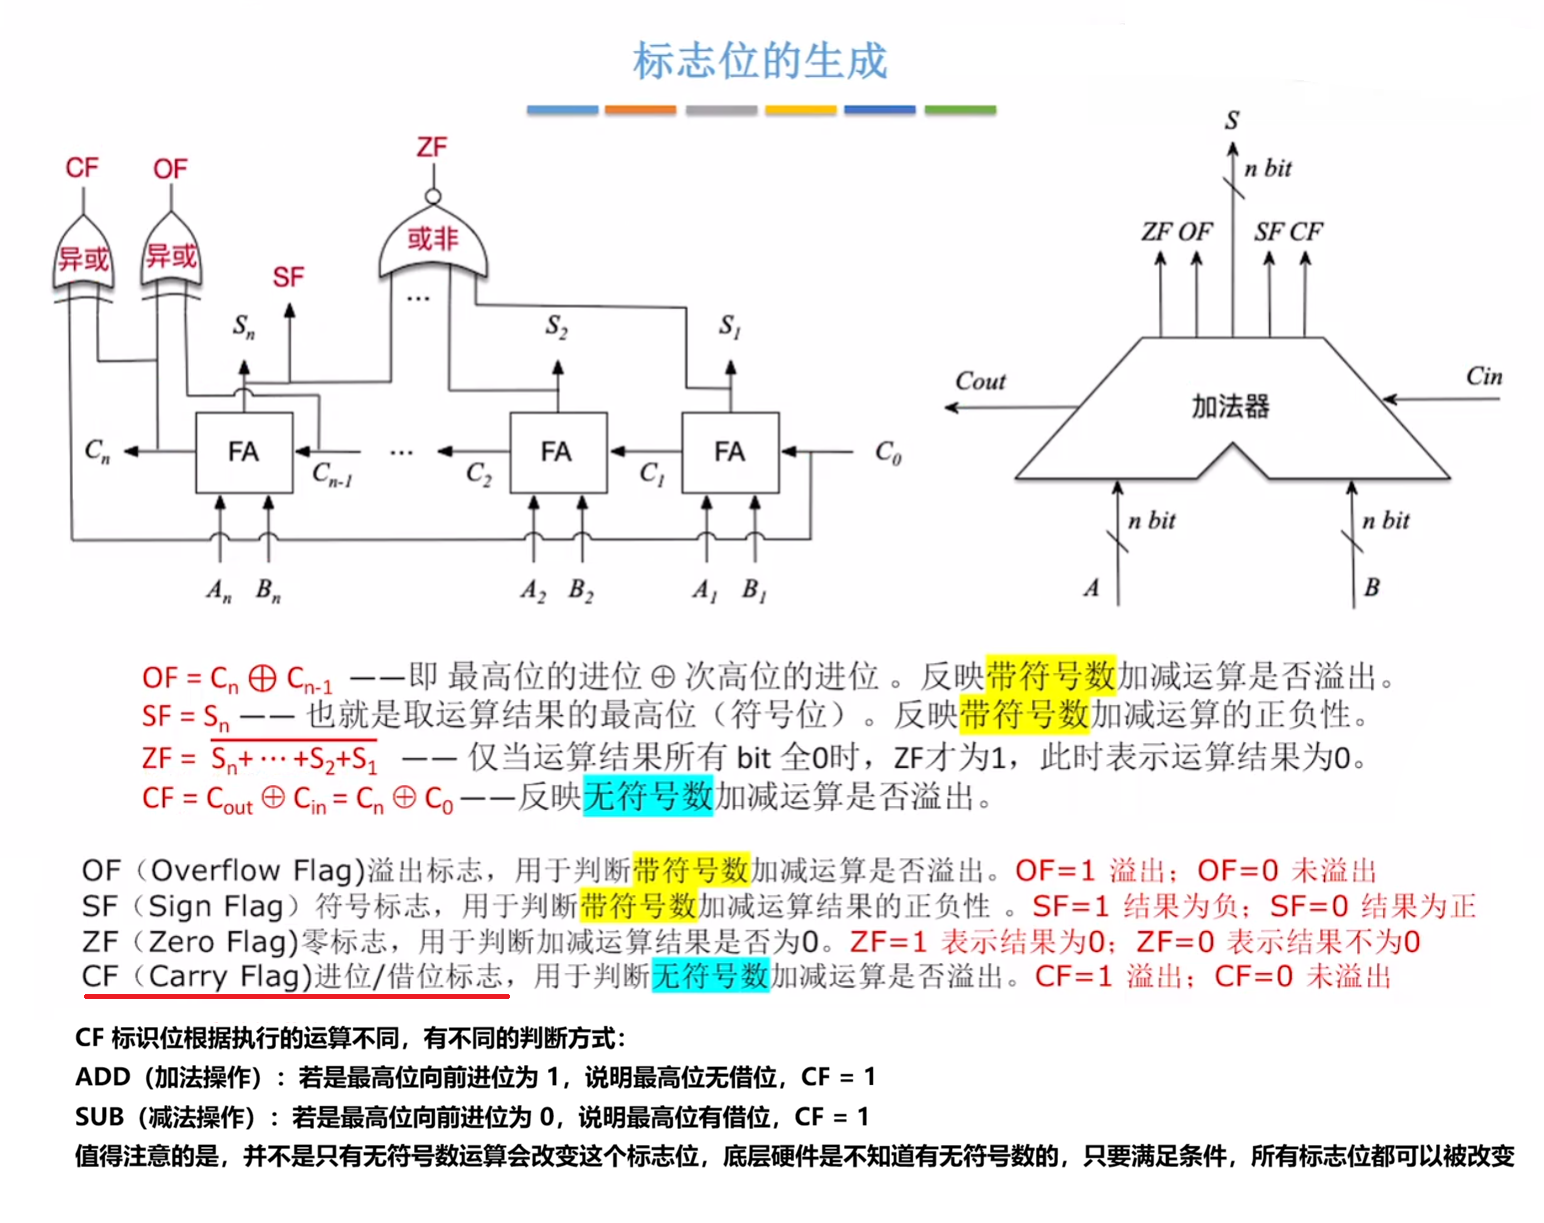
 严格来说,标志位是由 ALU 在执行运算后产生的状态信息,而不是单纯由加法器产生的。
ALU 在执行不同运算时,除了输出运算结果外,还可能根据运算结果产生相应的 标志位(Flag),用于反映本次运算的状态,例如是否发生溢出、是否产生进位等。如图所示:
2.2.3 定点数的移位运算
根据操作数类型的不同,移位运算可以分为逻辑移位和算术移位。 逻辑移位常用于处理无符号整数,算术移位常用于处理带符号整数。但是只是常用于,对于底层的计算机硬件(移位寄存器)来说,都只是二进制串,不论是带符号还是不带符号,只要收到的指令是用 SHR(逻辑右移) 或是 SAR(算术右移),CPU 就会真的执行不同硬件动作
2.2.3.1 逻辑移位
逻辑移位一般用于处理无符号整数。
过程如图所示,注意移位溢出和精度丢失的判别条件:

2.2.3.2 算术移位
算术移位一般用于处理带符号整数。
过程如图所示,注意移位溢出和精度丢失的判别条件:

2.2.4 定点数的加减运算
2.2.4.1 有符号数的加减运算
前面已经说过,对于定点数的加减运算,我们可以通过补码的方式将其全部转换成加法进行实现,求补码的方式前面也已经讲述过。总之就是:
- 有符号数原码做加减运算,变成补码之后按补码的规则做运算的到结果的补码。
- 有符号数的补码做加法运算,直接加;做减法运算,将减数连带符号位取反再加一(即将[B]补->[-B]补),再做加法。
本节重点在于硬件如何判断有符号数加减是否溢出。 显然,只有同号定点数进行相加才会出现溢出现象,而溢出又分为上溢和下溢,关于溢出的判断有三种方法,具体如下所示:
-
方法一: 两个加数为正(负),运算结果为负(正)时发生溢出。如图所示:

-
方法二: 符号位的进位和最高数值位的进位不同则发生溢出。如图所示:

-
方法三: 采用双符号位补码表示数值,若运算出来两个符号位不同则溢出。如图所示:
 注意:01 是正数溢出(00->01嘛),10 是负数溢出(11->10嘛)
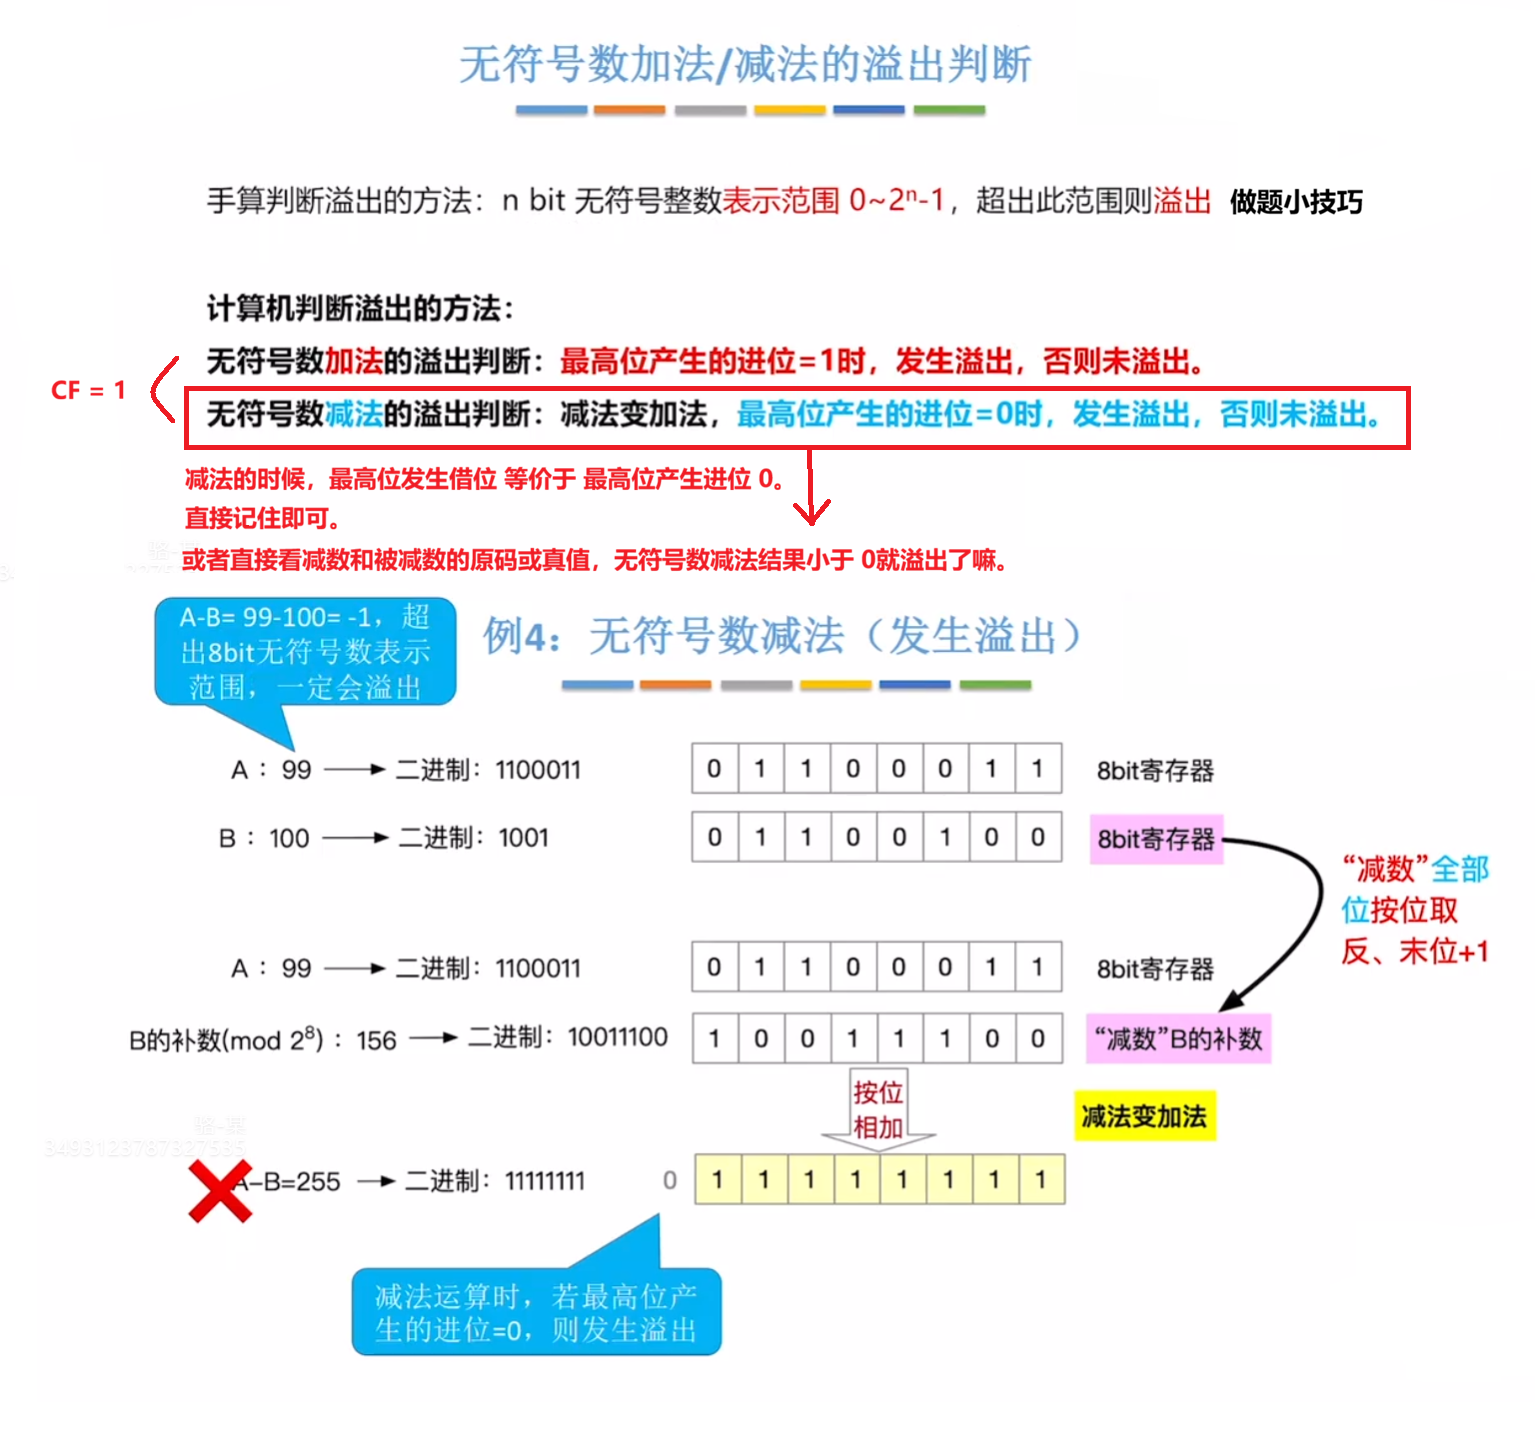
2.2.4.2 无符号数的加减运算
对于计算机底层硬件来说,无符号数加减 和 有符号数的补码的加减运算 是一样的。如图所示:
 关于 无符号数加减的溢出判断 如下图所示:
2.2.4.3 补码加减运算电路
对于补码的加减运算电路,加法直接使用一个 n bit 加法器就能够实现,显而易见不清晰的点在于 如何在实现补码的减法时,将减数全部取反再加 1,实现电路如下图所示:
 注意数据输入端并没有加 1 ,加 1 发生在加法器中,输入的只是取反结果。
而无符号数加减的实现电路当然和补码加减运算电路是一样的。
2.2.5 定点数的乘法运算
2.2.5.1 无符号整数乘法运算原理
手算二进制乘法,和十进制乘法非常类似,而在机器底层硬件中,乘法主要通过 加法器 和 移位运算 进行实现。如图所示:
 注意:在溢出判断时,其实 OF/CF 都置为 1,但是程序员通常会使用 OF 标志位做判断。
2.2.5.2 带符号整数乘法运算原理
带符号整数进行乘法运算的电路和无符号数乘法非常类似,但是注意:带符号数在计算机中通常使用补码进行存储,补码的乘法运算的数学原理较为复杂,只需要了解计算机底层硬件的工作原理即可。如下图所示:
 用一个真题来熟悉,如下图所示:

2.2.5.3 计算机实现乘法运算的三种方式
第一种: 是前面讲过的使用 ALU、移位器、寄存器、逻辑控制组成的乘法电路。 这种方式在三种方式中速度适中。
第二种:
通过阵列乘法器实现乘法运算。不必研究具体电路,知道特点即可。
这种方式在三种里面是最快的,只需要一个时钟周期。
如图所示:

第三种: 通过软件模拟(编译器生成移位 + 加法指令)。 这种方式在这三种里面是最慢的。 模拟代码如下:
/*用移位运算、加法运算等效实现32bit无符号数乘法*/
unsigned int multiply_unsigned(unsigned int x, unsigned int y) {
    unsigned int result = 0;
    for (int i = 0; i < 32; i++) {
        // 提取乘数 y 的最低位
        unsigned int bit = y & 1;
        // 如果当前位为 1, 加上被乘数 x
        if (bit) {
            result += x;
        }
        // 被乘数 x 左移一位, 乘数 y 右移一位
        x <<= 1;
        y >>= 1;
    }
    return result;
}
通过一道真题来熟悉这三种方式的区别:

2.2.6 定点数的除法运算
看后面在学有余力的情况下,再来补充电路细节。一轮复习不要死磕电路细节。
2.2.6.1 无符号整数的除法运算原理
标准手算的无符号整数的二进制除法和标准手算的十进制的除法其实是一样的(很多年不用这种标准除法了,回忆一下)。
关于无符号整数的除法运算电路如图所示:

关于商溢出的进一步探讨如下图所示:

2.2.6.2 带符号整数(补码)的除法运算原理
带符号整数(补码)的除法运算电路如下图所示:

2.3 浮点数的表示和运算
由于真值能够无限增长,只使用定点数进行表示即使是现代的 64 位机器字长的计算机也表示不够。于是采用浮点数进行表示(浮点数就像“二进制科学计数法”)。 浮点数有很多的表示标准,但是考研统一使用 IEEE 754 标准。
2.3.1 浮点数的表示_IEEE 754
在 C 语言中主要有两种类型,即 单精度浮点数(float) 和 双精度浮点数(double),当然还有其他类型,不过考研不用管。如下图所示:
 关于单精度浮点数,其具体格式如下图所示:
 关于双精度浮点数,其具体格式如下图所示:

用几个例题来进行关于浮点数转化的熟悉,真值与浮点数互相转化非常重要!


2.3.2 几种特殊的浮点数
IEEE 规定,当阶码不全为 0 或者 1 的时候,这个时候的浮点数为规格化表示。阶码全为 0 和 1 的情况一般被用作表示特殊浮点数,如下图所示:
 简单总结来说:
-
全 0 阶码 + 全 0 尾数:+0 / -0 符号位 S 决定其正负,通常情况下,+0 和 -0 在数值上是等效的。
-
全 1 阶码 + 全 0 尾数:+Infinity / -Infinity 符号位 S 决定其正负。+Infinity 在数值上大于所有有限数,-Infinity 则小于所有有限数。 引入无穷大的目的是,使程序在溢出等异常情况下仍能继续执行。
-
全 1 阶码 + 非 0 尾数:NaN(Not a Number) 表示一个没有定义的数,称为非数。
-
全 0 阶码 + 非 0 尾数:非规格化数 非规格化数的特点是:阶码为全 0,不使用隐藏位,尾数字段非 0。 因此,单精度和双精度浮点数的实际指数分别为:
-126 和 -1022
非规格化数用于实现渐进下溢,填补 0 与最小规格化数之间的数值间隙。
注意 非规格化数(上面表格的特殊数) 的情况,计算时容易错误,如下图所示:
 用一道真题来熟悉非规格化数的表示:
 关于 无定义数(上面表格的特殊数) 也有一些需要注意的地方,如下图所示:

2.3.3 浮点数的表示范围
规格化的浮点数的表示的范围如下图所示:
 上溢:IEEE 规定把 大于最大表示正数 和 小于最小表示负数 的情况都被称为 上溢,关于上溢的处理具体如图所示:
 下溢:IEEE 规定把 小于最小表示正数 和 大于最大表示负数 的情况都被称为 下溢,关于下溢的处理具体如图所示:
 规格化数下溢其实还能够通过非规格化数来进行表示(|x|< 2-149 才是真的下溢了)
2.3.4 浮点数的加减运算
2.3.4.1 例题示例
浮点数的加减运算和十进制科学计数法是一样的分为五个步骤分别是: 1. 对阶 2. 尾数加减 3. 尾数规格化 4. 尾数的舍入处理 5. 溢出判断
通过三个例子来感受,非常易错,一定去试试:


2.3.4.2 舍入问题
关于浮点数的舍入方式如下图所示,重点在于关注就近舍入这种模式:
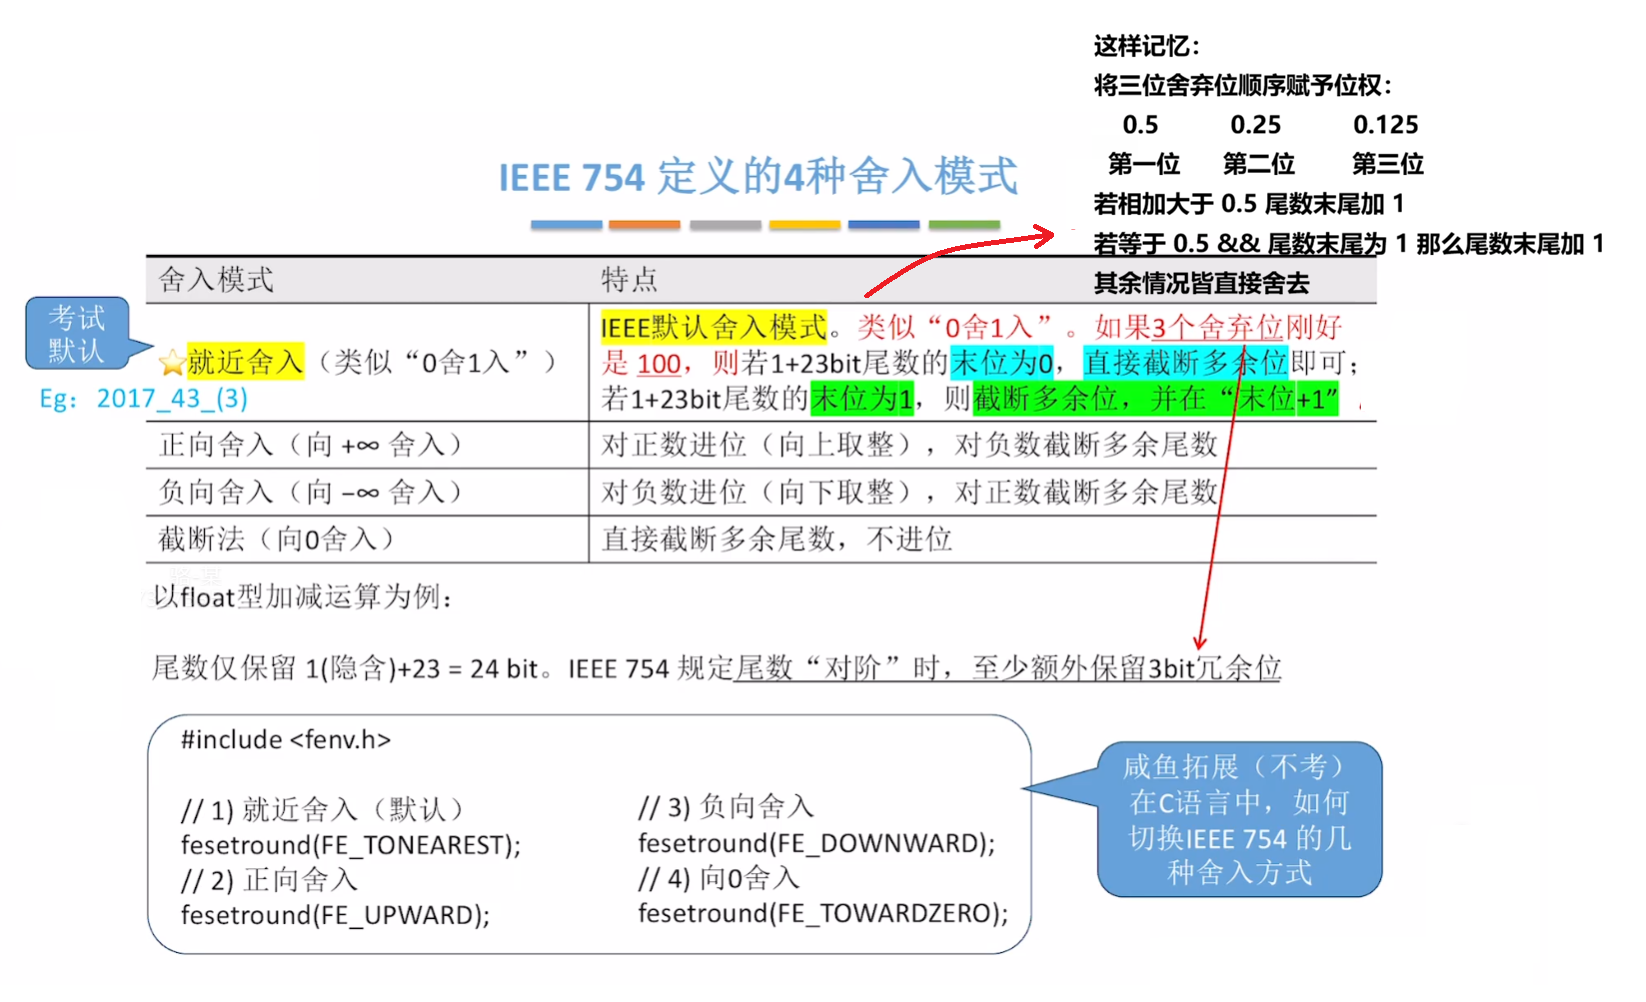 关于就近舍入这种方式,举四个例子如下图所示:


2.3.4.3 溢出问题
浮点数的溢出主要取决于 阶码是否上溢 ,因为阶码下溢还能够通过非规格化数来进行表示(|x|< 2-149 才是真的下溢了),而尾数上溢或者下溢可以通过左移或者右移进行调整。
关于 上溢 的判断如图所示:
上溢了直接为无穷。
 而关于 下溢 的判断也如图所示:
下溢了会先到非规格化浮点数。

2.3.4.4 精度问题
- float 的有效精度是 24 位(一个隐藏 1,加上 23 位的尾数)。
- double 的有效精度是 53 位(和 float 同理)。
精度丢失的原理:在对阶阶段,较小数移位过程中,有非 0 数移位到了舍弃位,此时不论舍弃位处理为截断还是舍入,都会出现精度偏差。
记忆这个有什么用呢,在两数运算差距明显的时候可以直接判断,不过最好还是去算一算,列举两个常见的:
- 整数转浮点数:若是整数 大于 224=16777216 或 253 则可能会发生精度丢失。
- 浮点数之间加减运算:若是阶码之差绝对值 大于 24 或 53 则那么直接 忽略阶码小的。出现 “大数吃小数” 的情况。原理是较小数对阶后,其隐藏 1 ,必定移位至舍弃位第二位,而舍弃位第一位为 1,舍弃位直接被截断无法进位,尾数也为全 0,故直接忽略。
还有一些真值小数,本身就无法被浮点数准确表示,比如:
| 十进制真值 | float32 实际存储值(近似) | 相对真值 |
|---|---|---|
| (0.1) | (0.10000000149011612) | 大于真值 ↑ |
| (0.2) | (0.20000000298023224) | 大于真值 ↑ |
| (0.3) | (0.30000001192092896) | 大于真值 ↑ |
| (0.4) | (0.4000000059604645) | 大于真值 ↑ |
| (0.6) | (0.6000000238418579) | 大于真值 ↑ |
| (0.7) | (0.699999988079071) | 小于真值 ↓ |
| (0.8) | (0.800000011920929) | 大于真值 ↑ |
| (0.9) | (0.8999999761581421) | 小于真值 ↓ |
| (0.01) | (0.009999999776482582) | 小于真值 ↓ |
| (0.05) | (0.05000000074505806) | 大于真值 ↑ |
| (0.15) | (0.15000000596046448) | 大于真值 ↑ |
怎么判断呢?除了去凑,还有一个比较可靠的方法:将该小数用分数表示,若其 分母不是 2 的幂,则不能被浮点数准确表示。
值得注意的是:不能简单的认为是浮点数无限逼近这个小数的真值而判断浮点数小于真值,因为还有舍入的情况。
2.3.5 数据的存储和访问
2.3.5.1 大小端模式
计算机存储通常采用小端模式:
 注意 大小端转换:以每个数据类型对象为范围,按字节反序排列;字节内部的比特顺序不变,不能把整个数组当成一个整体反序。
例如:
int A[2];
A[0] = 0x12345678;
A[1] = 0xABCDEF12;

那么大端序为:12 34 56 78 AB CD EF 12
小端序为 78 56 34 12 12 AB CD EF
2.3.5.2 边界对齐
在字长为 32 位的系统中,边界对齐是指某类型数据的存储地址是其 对齐值(通常是该数据类型大小)的整数倍。 系统按字节进行编址,所以字节长度类型数据可位于任意地址,半字长度类型数据起始地址需为 2 的倍数,字长类型的数据起始地址需为 4 的倍数。
满足这个条件的时候,CPU 能够通过一次访存读取完整数据,否则,若数据跨越两个存储单元,则需两次访存拼接,显著降低效率。 为满足对齐要求,编译器会在必要时补充空白字节。
关于计算机的边界对齐如图所示:
 C 语言中,struct 类型的数据就遵循以下对齐规则:
- 每个成员的 起始地址 是其对齐值(通常是该数据类型大小)的整数倍
- 整个结构体大小必须是 最大成员对齐值的整数倍(不足时在尾部填充)
例如:
struct{ //其实地址设为0x0000
    int a //起始地址 0x0000
    char b //起始地址 0x0004
    short c //起始地址 0x0006
}//由于最大成员对齐值为 4,整个结构体大小刚好为 8 ,不用进行填充。
struct{ //其实地址设为0x0000
    char b //起始地址 0x0000
    int a //起始地址 0x0004
    short c //起始地址 0x0008
}//由于最大成员对齐值为 4,整个结构体大小 12 ,0x000A 0x000B 需填充。