存储系统
第三章_存储系统
3.1 存储系统的基本概念
3.1.1 存储器的层次化结构
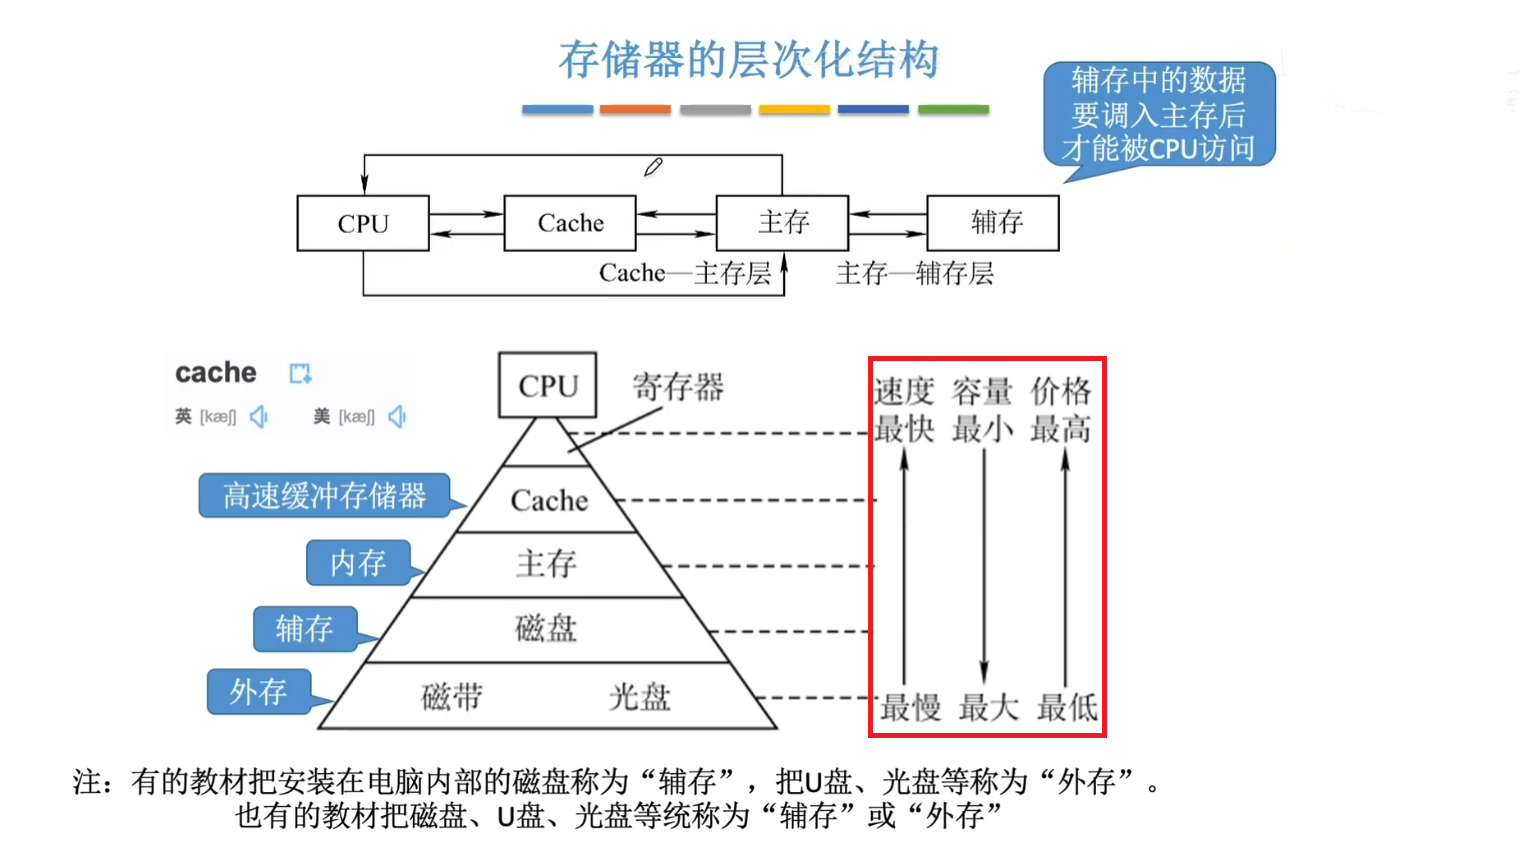
为缓解存储系统在容量、速度与成本之间的矛盾,现代计算机普遍采用多级存储器结构,如下图所示:
3.1.2 存储器的分类
存储器的种类繁多,可以从不同的角度进行分类(和计算机网络一样)
-
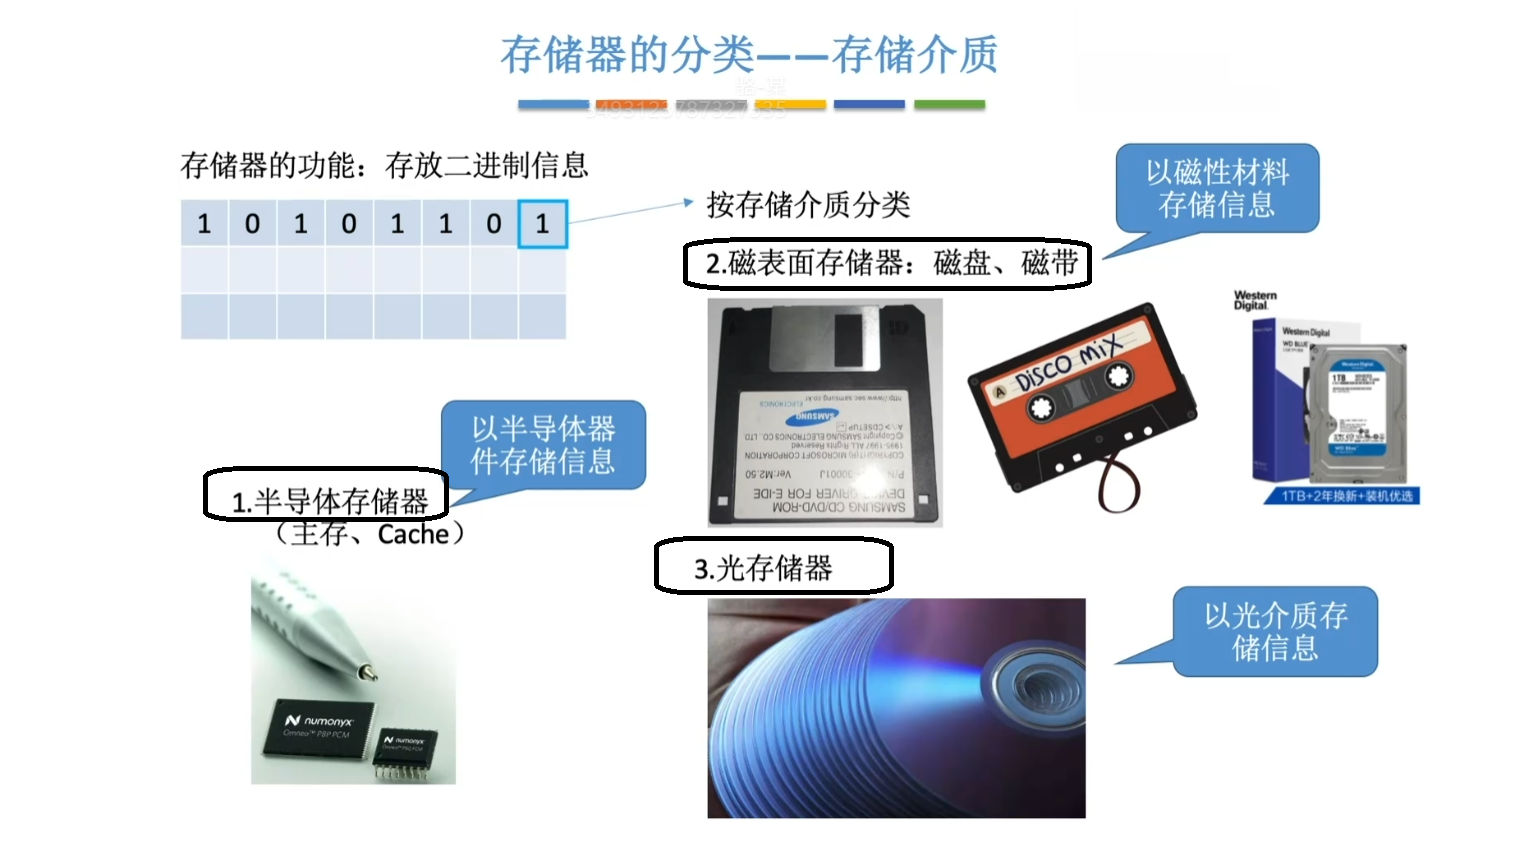
按存储元件分类: 存储元件须具备两个可区分的稳定物理状态用来表示 0 和 1。 如下图所示:
-
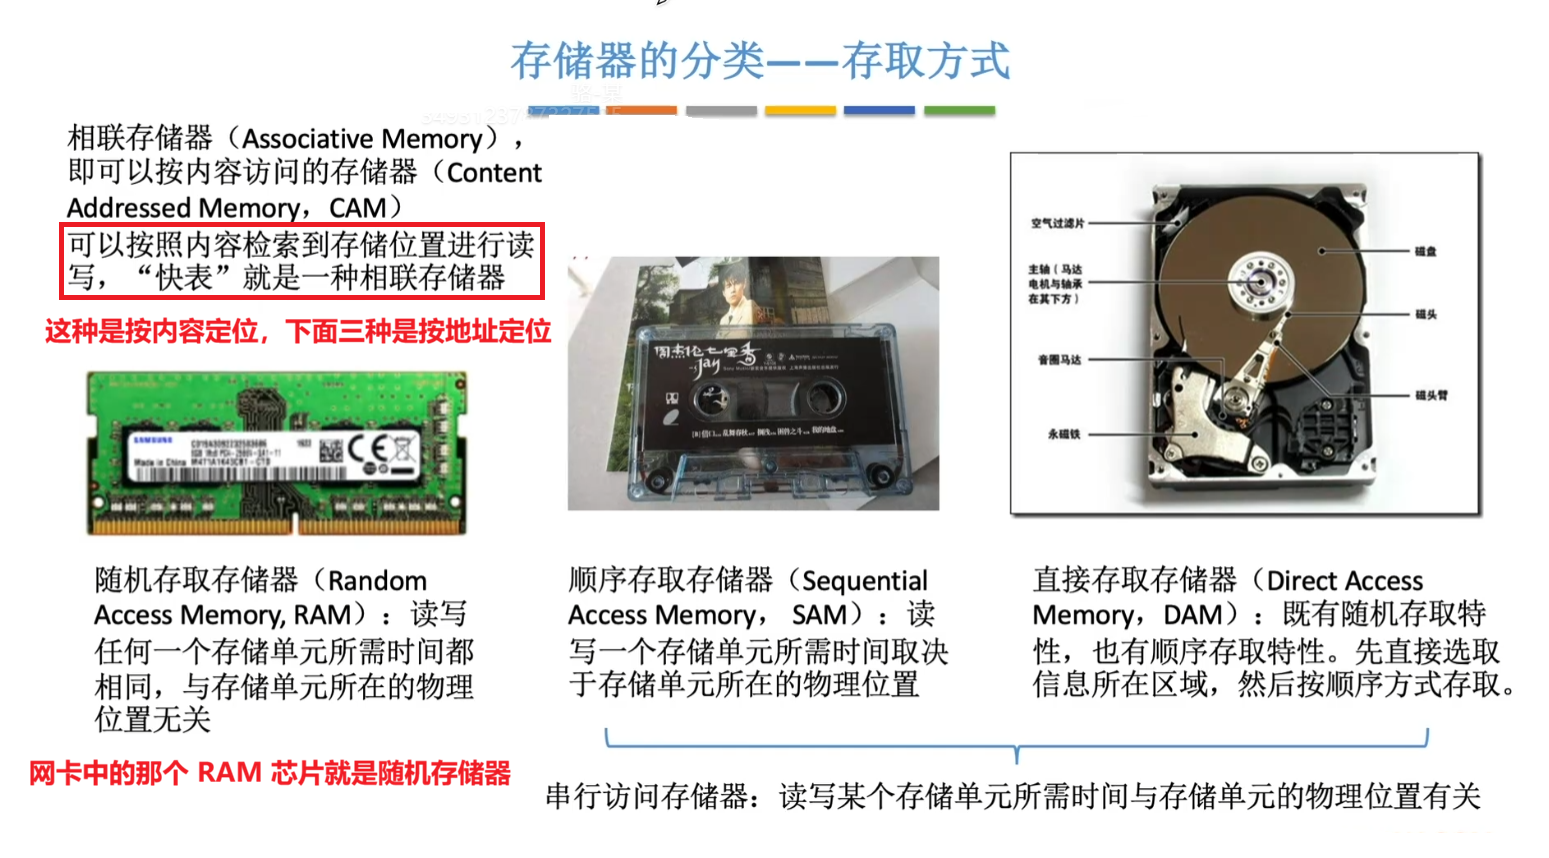
按存取方式分类: 如下图所示:
-
按信息的可更改性分类: 如下图所示:
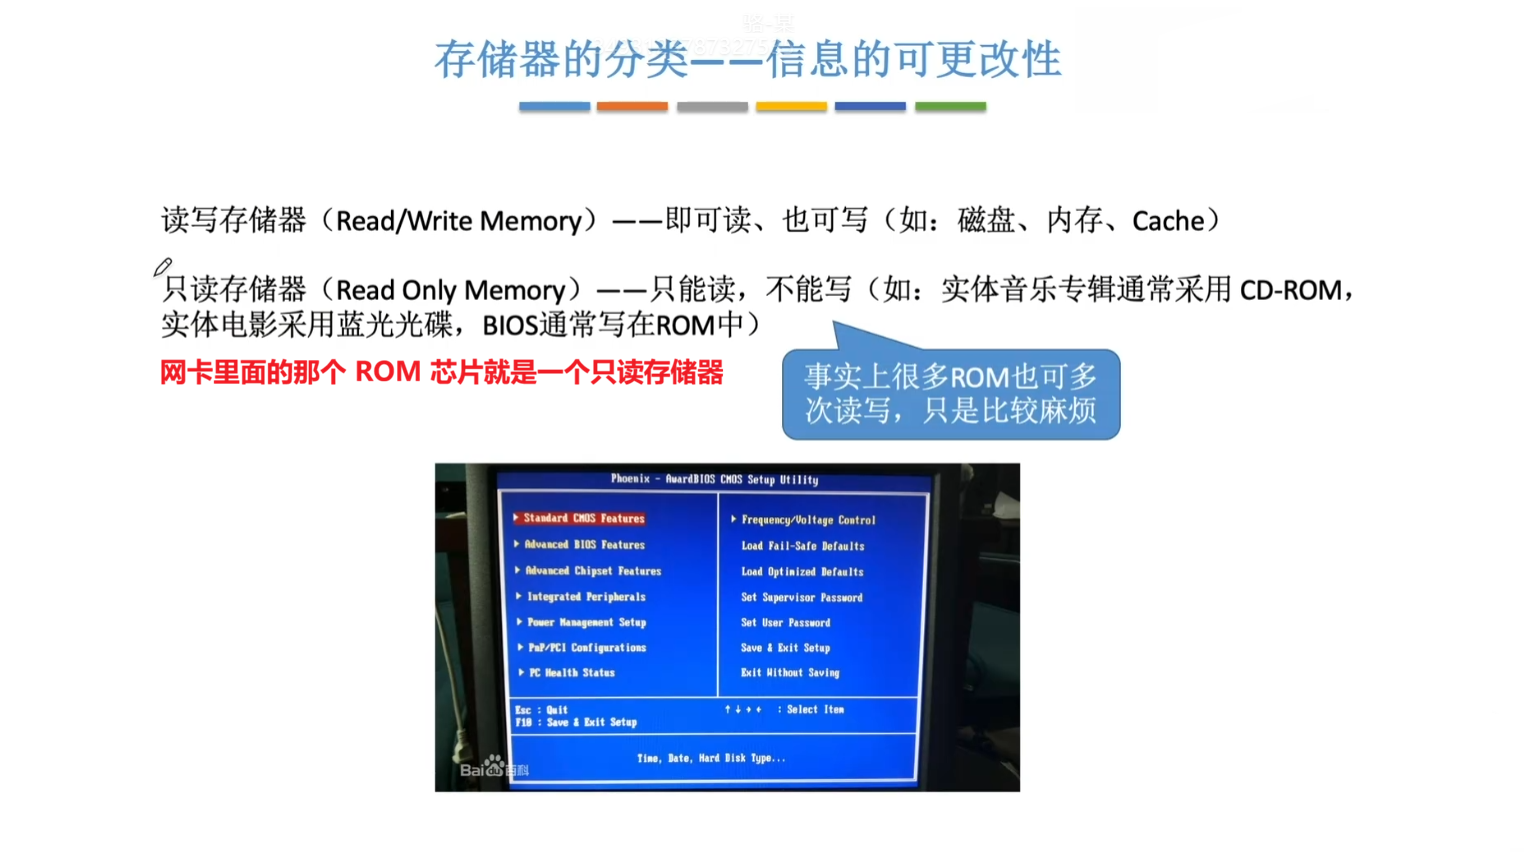
-
按信息的可保存性分类: 易失性存储器:断电之后,信息即丢失,如 RAM。 非易失性存储器:断电之后信息仍能保持,如 ROM、Flash 存储器、磁盘和光盘等。 此外,读取操作对信息是否具有破坏性也能分类,如下图所示:
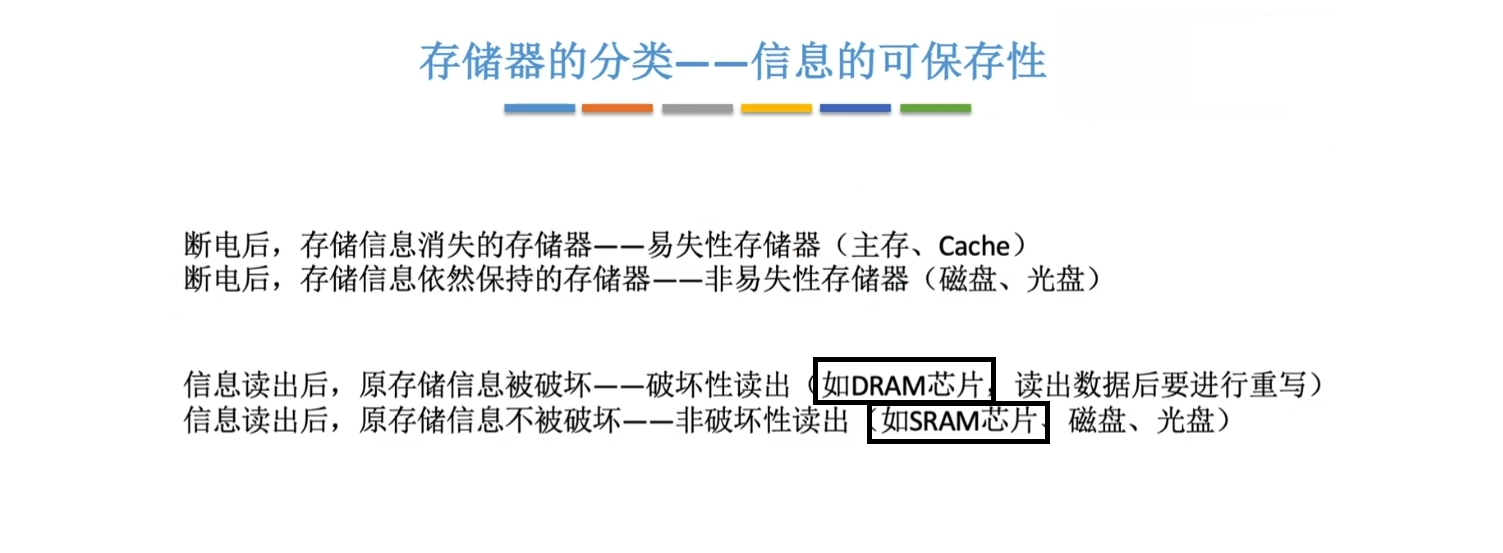
3.1.3 存储器的性能指标
存储器的性能指标如下图所示:
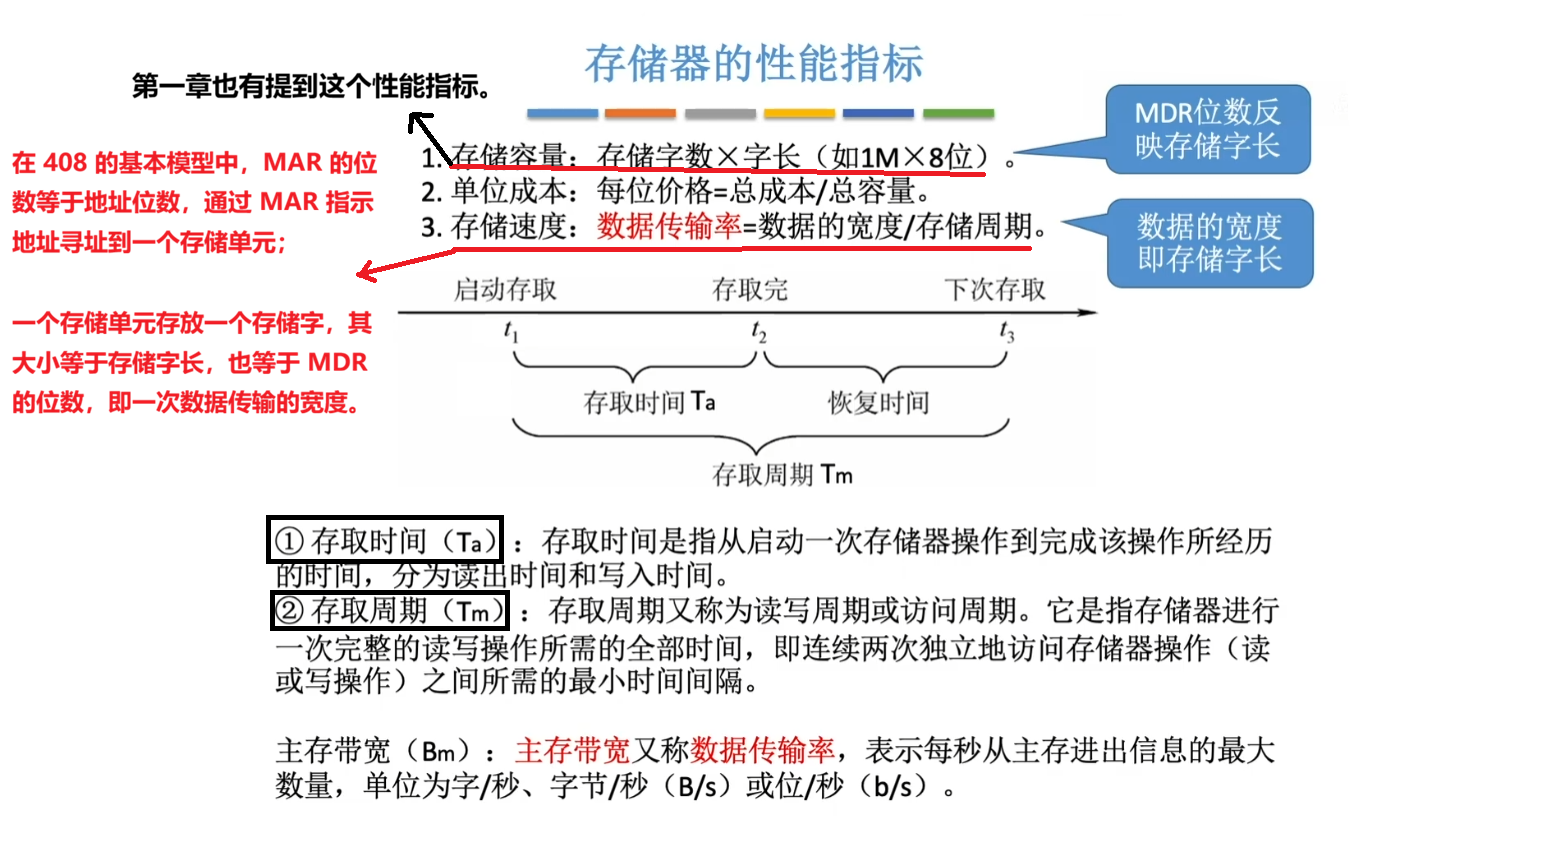
3.1.4 主存储器的组成和基本操作
本节思维导图如下:
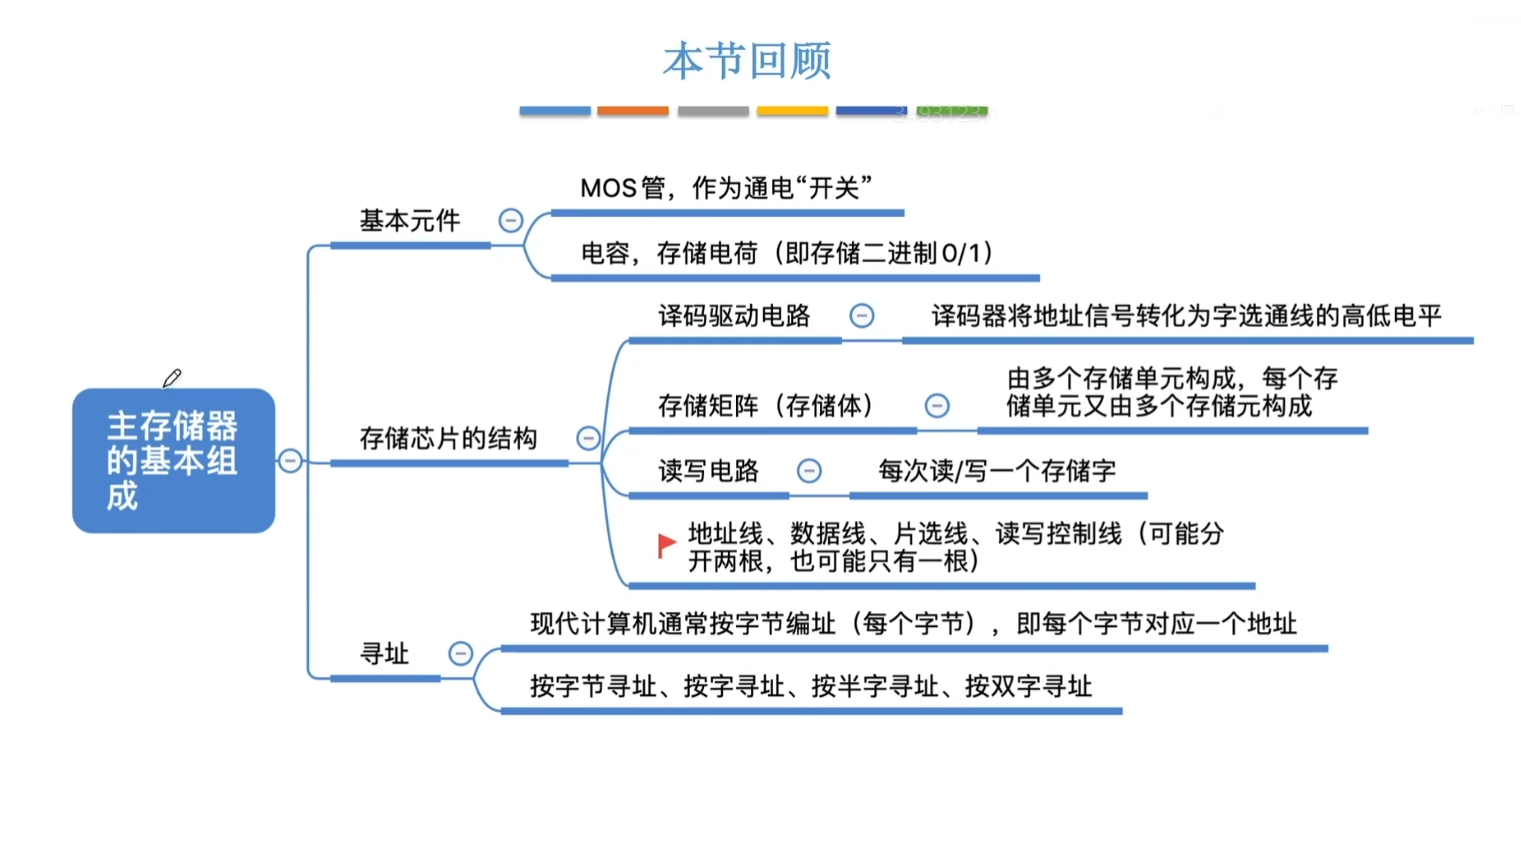 包含关系:
存储元件 ⊂ 存储元(记忆单元) ⊂ 存储单元 ⊂ 存储体
说明: 存储字长表示一次可读写的数据位数,不属于上述物理层次的包含关系。
3.1.4.1 基本元件
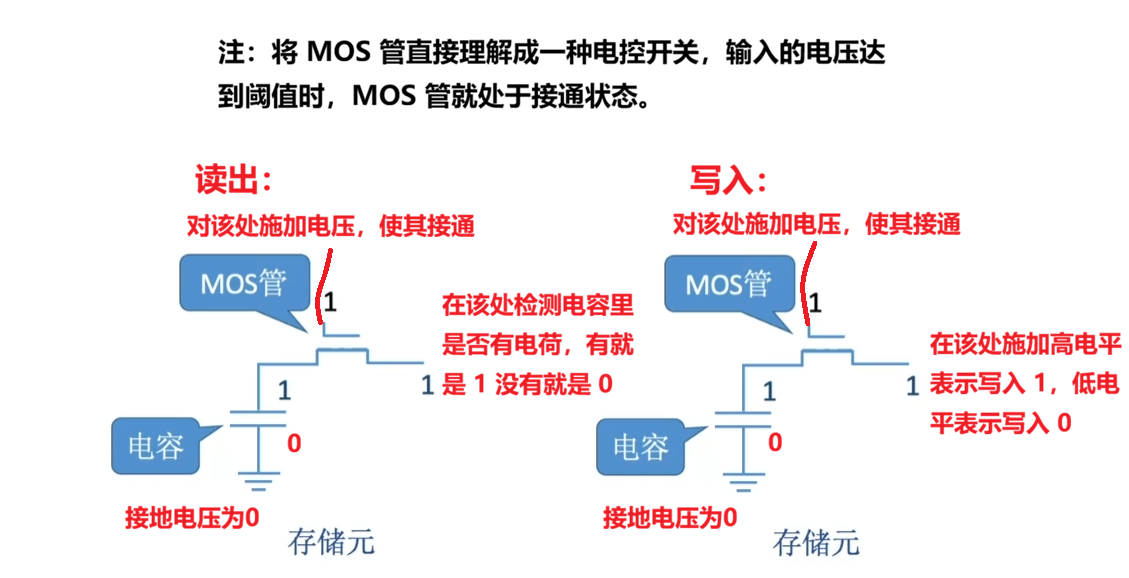
一般用于一个二进制数 0 或 1 的器件被称作 记忆单元(也称存储元),这是一个完整的、能够稳定保存 0 或 1 的最小存储结构。
而对于不同类型的芯片,一个记忆单元内可能存在多个基本元件。下面以 DRAM 芯片(1个 MOS 管 + 1个电容) 为例,介绍一个记忆单元是怎么存储一个二进制数的,如下图所示:
(当然,这并不是很重要,只是便于理解存储器)
3.1.4.2 存储芯片的结构
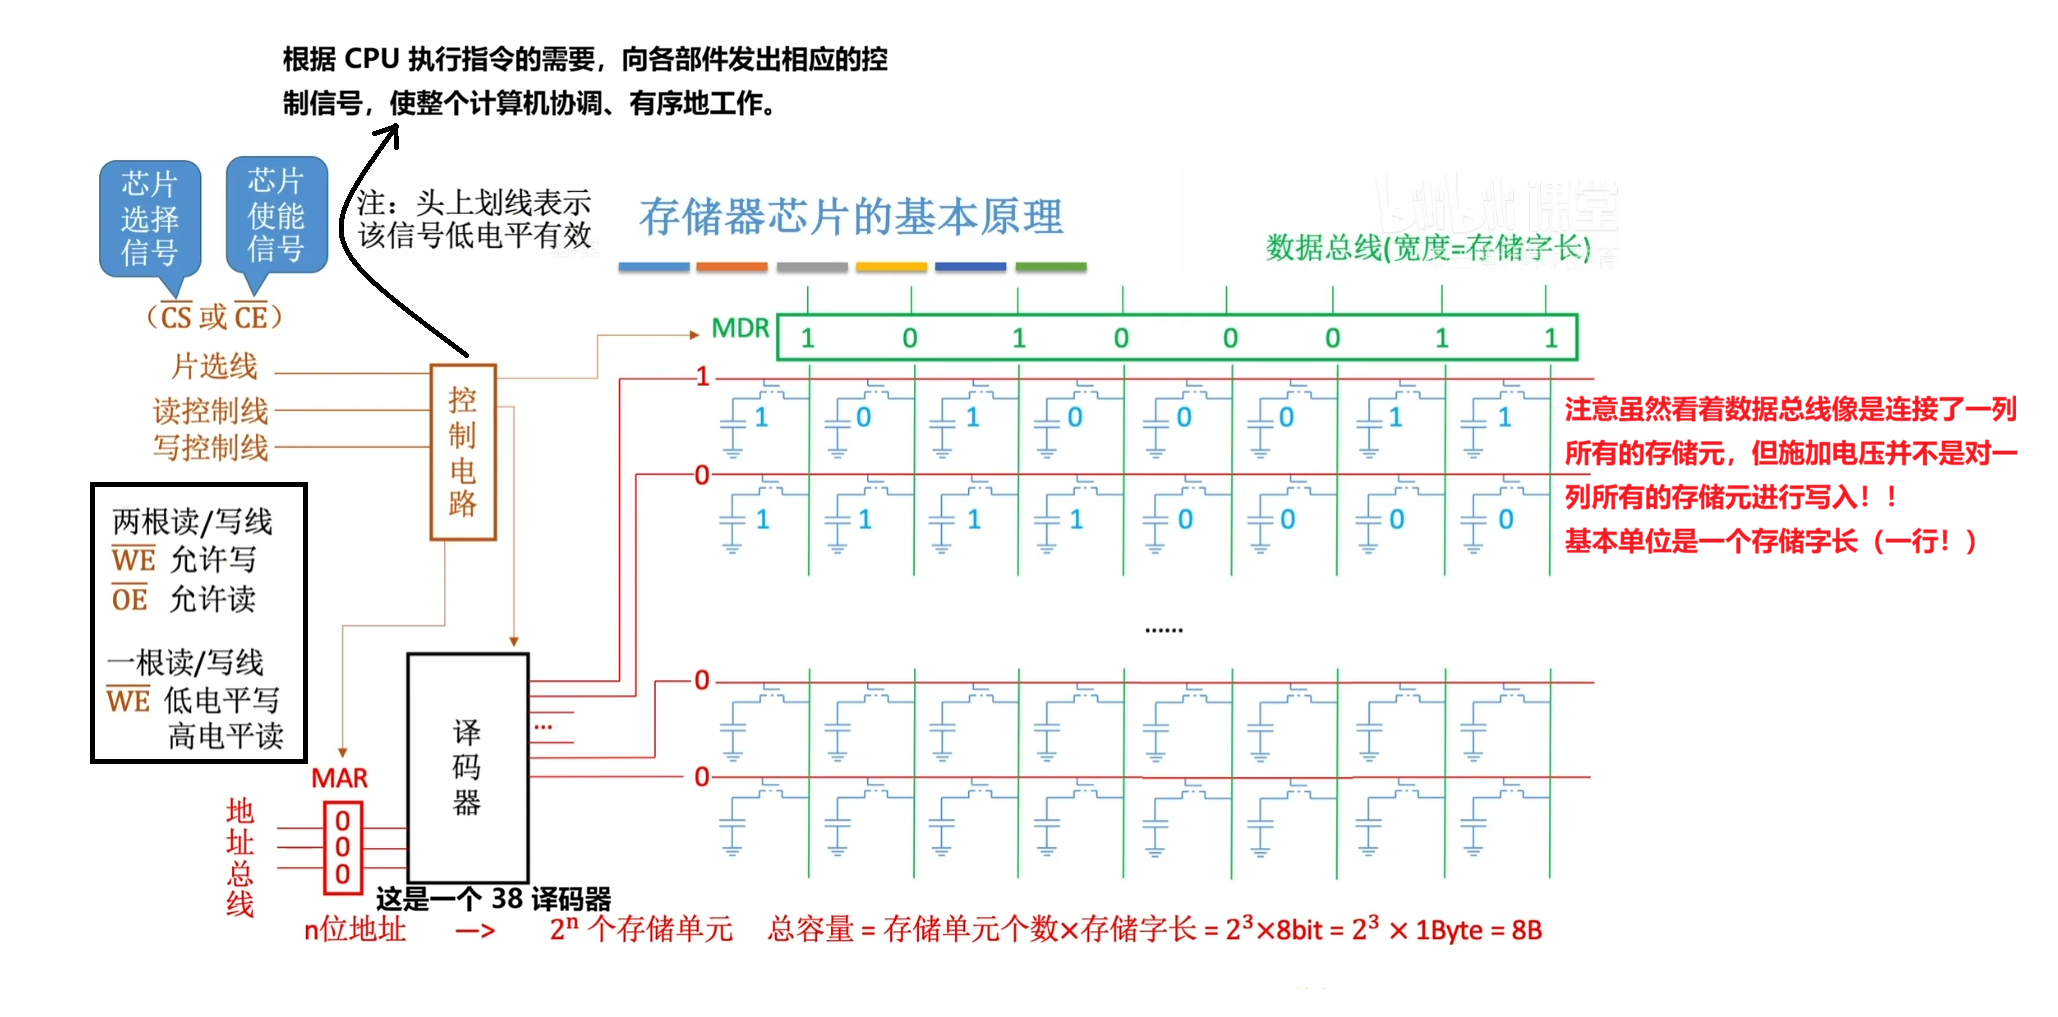
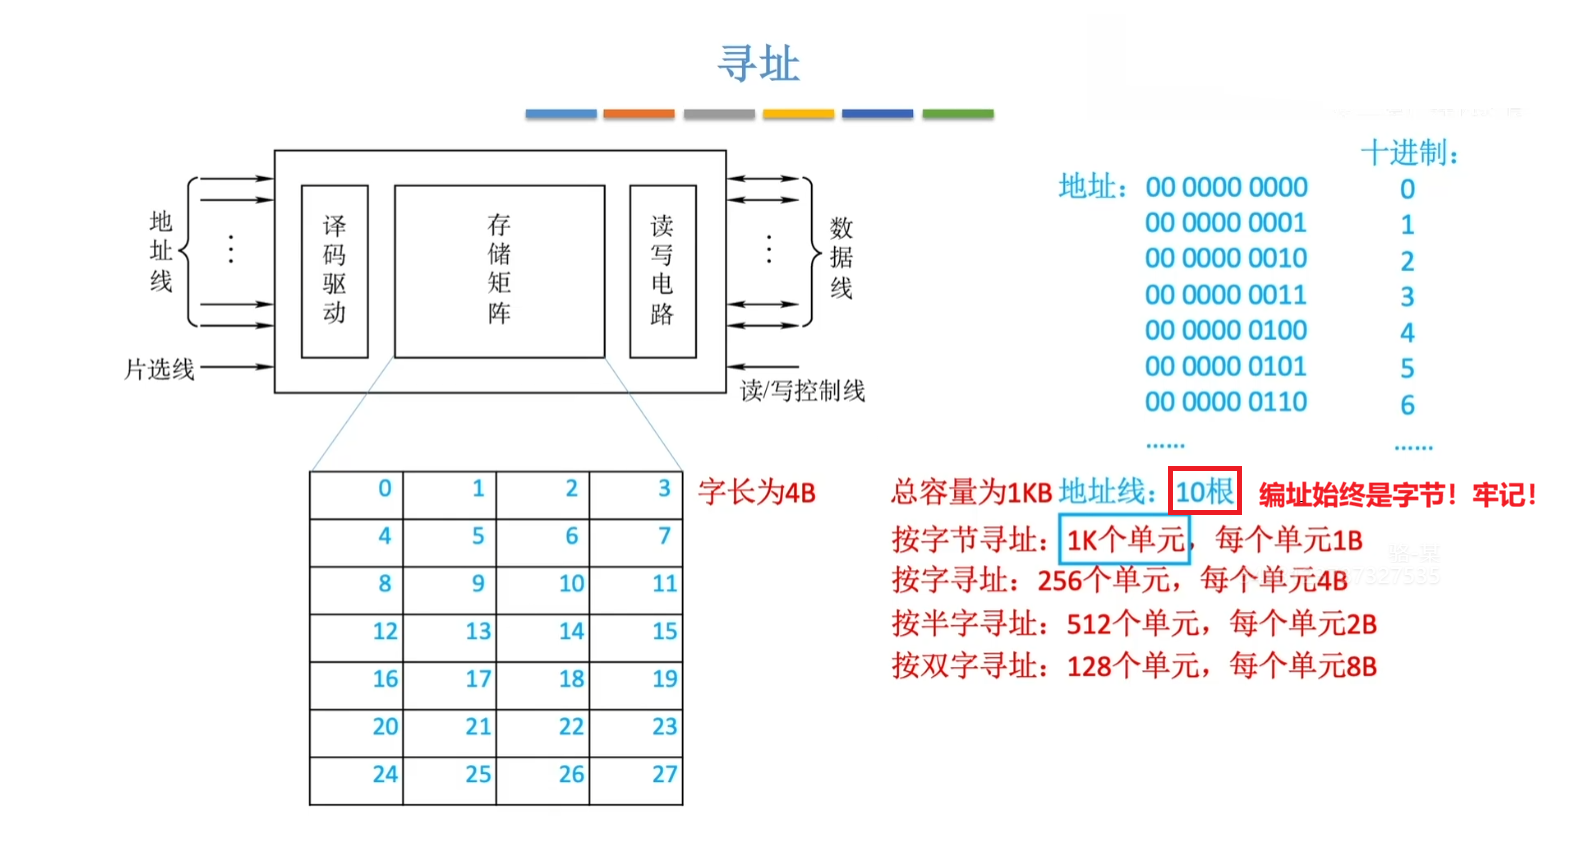
对于具有相同地址的一组存储元,称为一个存储单元。现代计算机普遍采用字节编址的方式,即一个地址对应 1 字节(8位)数据。
而通过数据总线、地址总线、控制总线进行控制,即可对整个存储体进行读写操作,以 DRAM 芯片为例,如图所示:
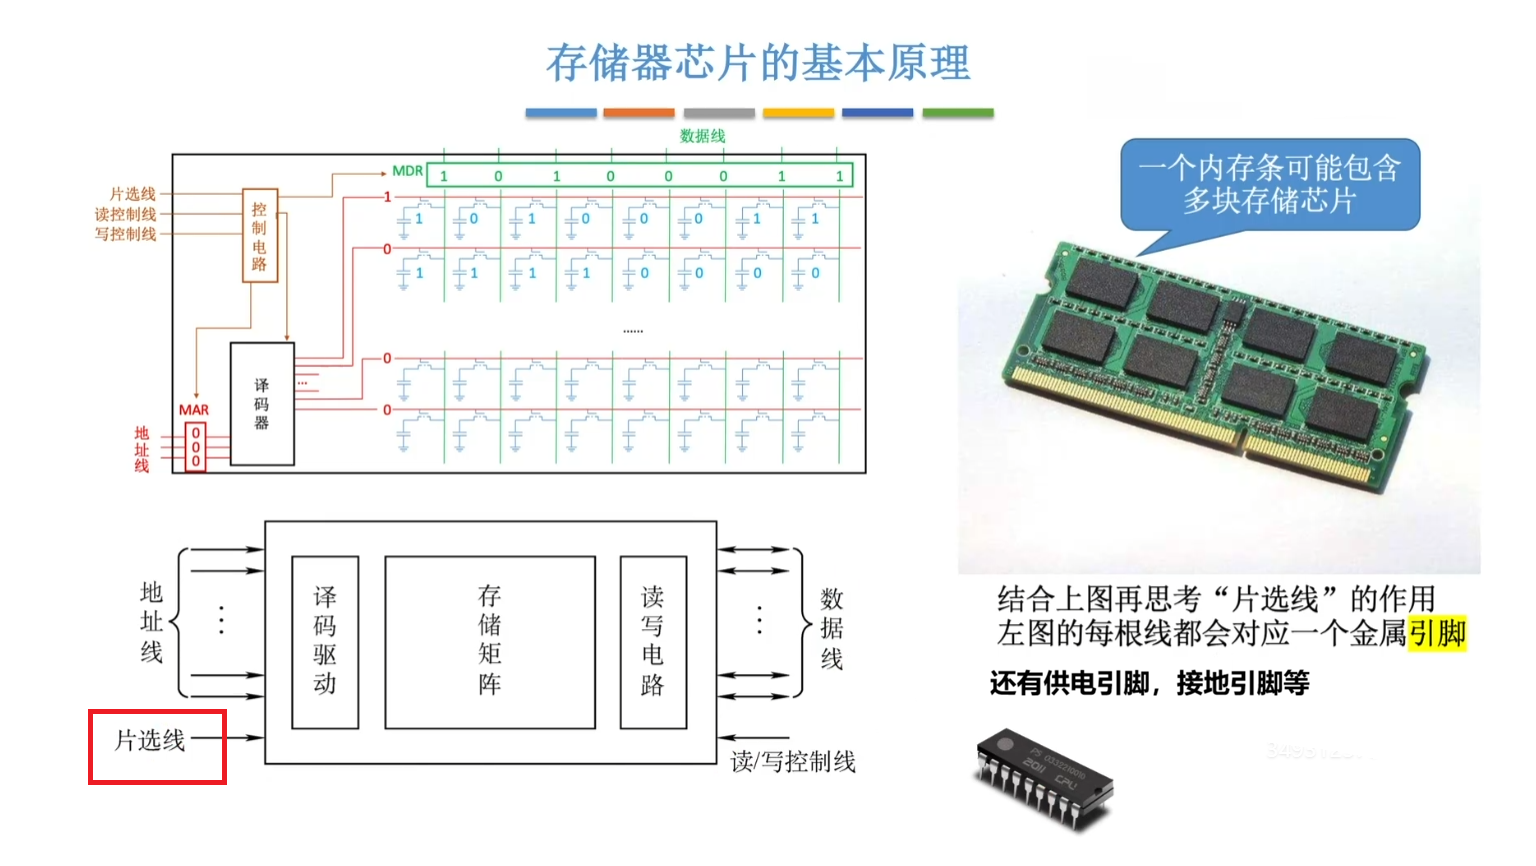
 而将一个存储体(存储矩阵) 进行封装之后,还会使用到片选线等线,如下图所示:
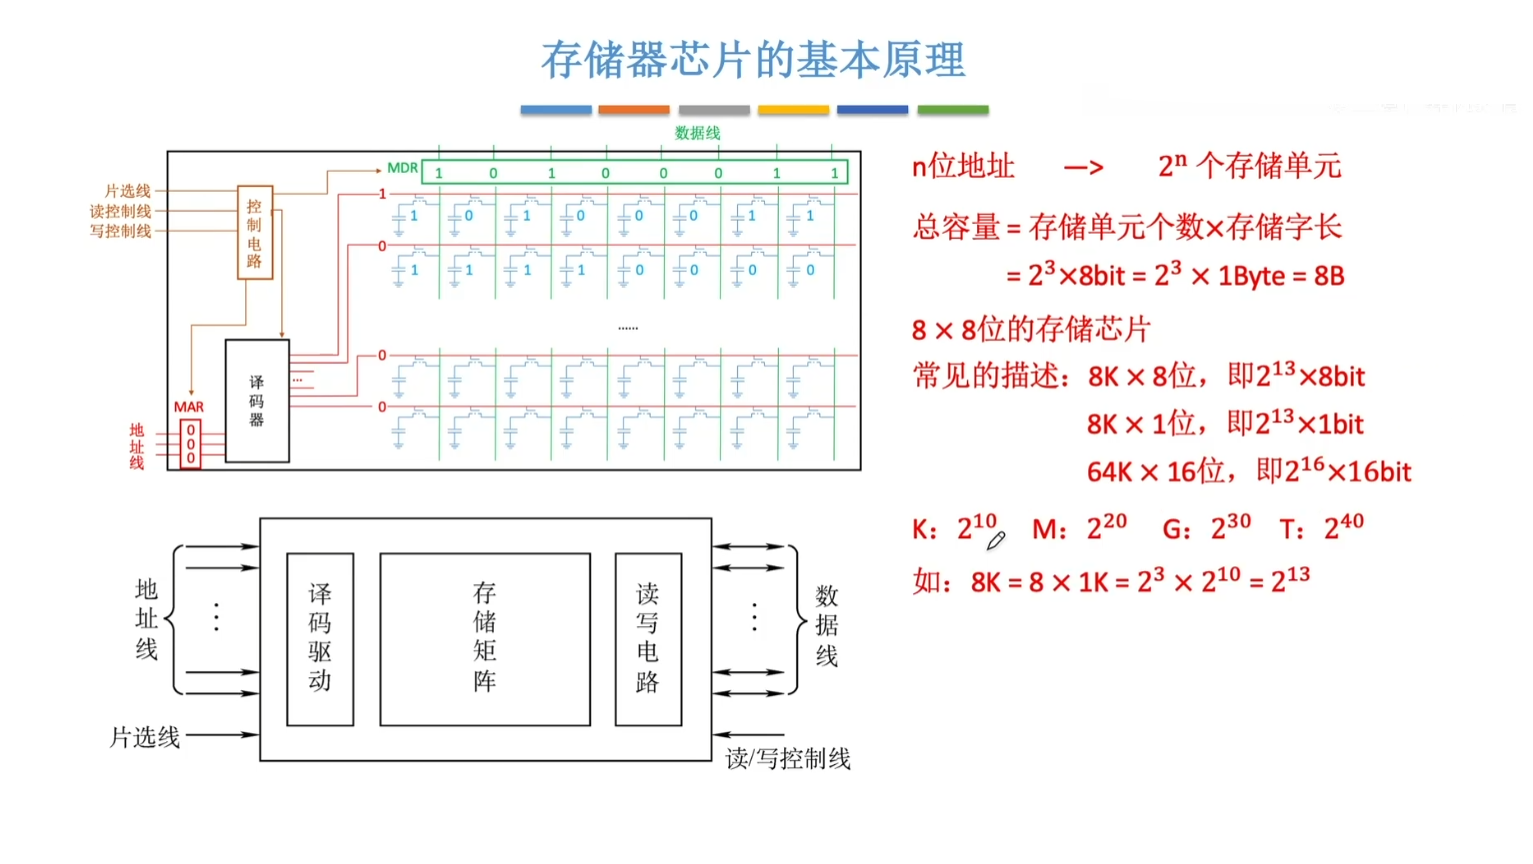
 而在考研中,经常会给出数据让你判断需要暴露多少引脚,常见的描述如图所示:
3.1.4.3 寻址与读数据
分清楚几个概念: 一个地址对应一个 存储单元,存储字 指一个存储单元中存放的数据,存储字长 是指一个存储单元对应的位数,而一次存取周期能够读写的最大位数是 数据总线位数 决定的。比如一次访问的数据单位:可能是半字、字、双字。
这里还要解释一点,字 本质指的是机器字长(CPU 规定的基本数据处理单位),和存储字不一样。通常为 4 个字节,是因为默认在 32 位机器下讨论,但是在教学模型中为了简化通常是使用的 2 个字节!
寻址方式如下图所示:
3.1.5 SRAM 和 DRAM
3.1.5.1 SRAM VS DRAM
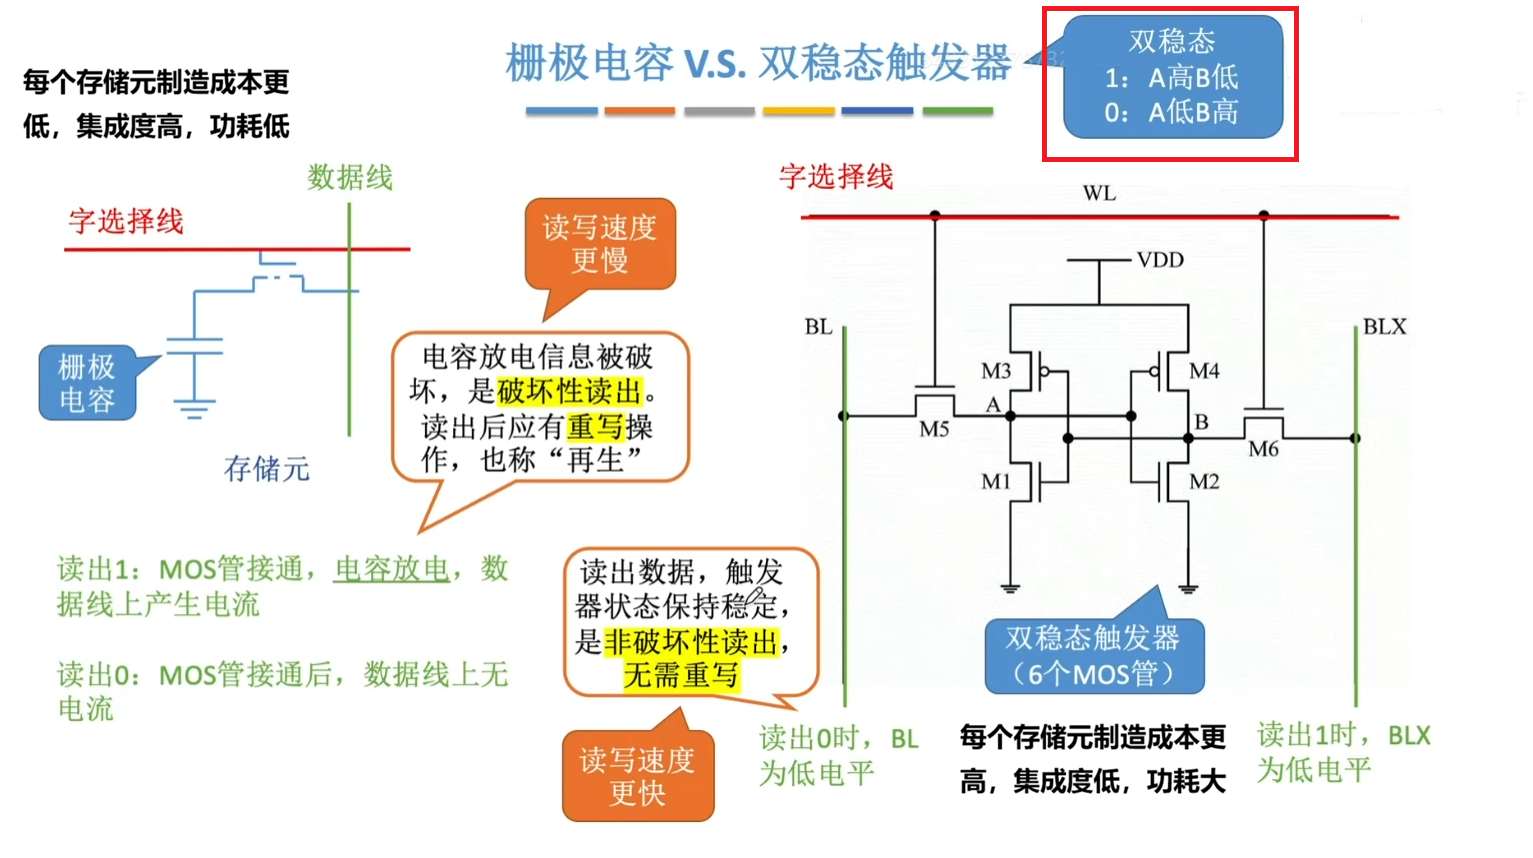
顾名思义,SRAM 和 DRAM 都属于 RAM(Random Access Memory,随机存取存储器)的一种。
SRAM 和 DRAM 芯片的主要区别在于存储元件的不同,如下图所示:
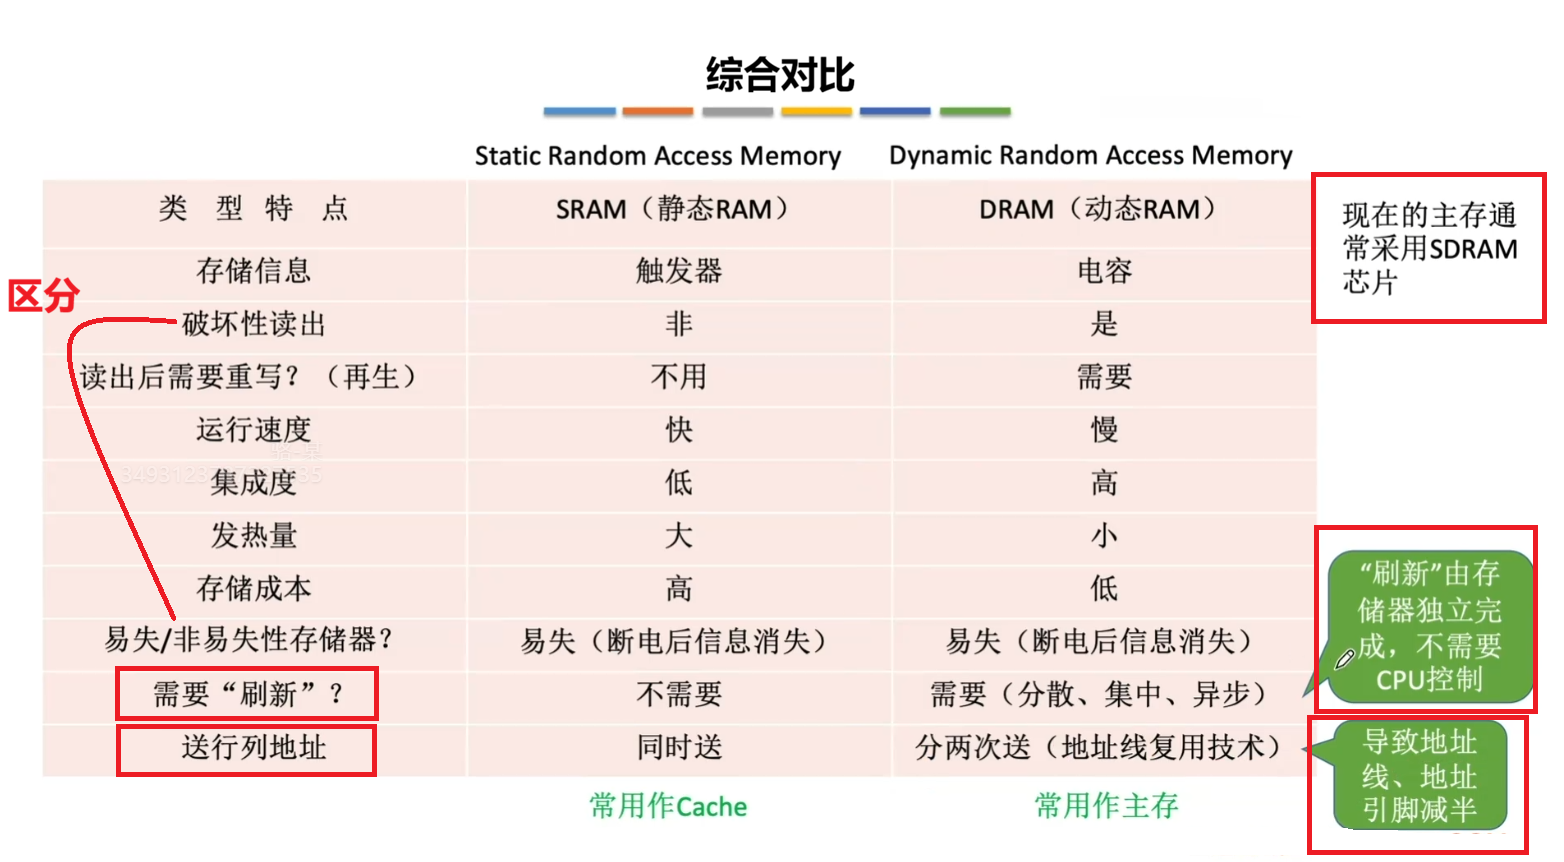
 关于两种芯片的综合对比如下:
3.1.5.2 DRAM 芯片的刷新
高中知识:电容不稳定,电荷会随时间逐渐泄漏。这是需要进行刷新的根本原因。
这里需要先介绍行列地址的概念,如下图所示:
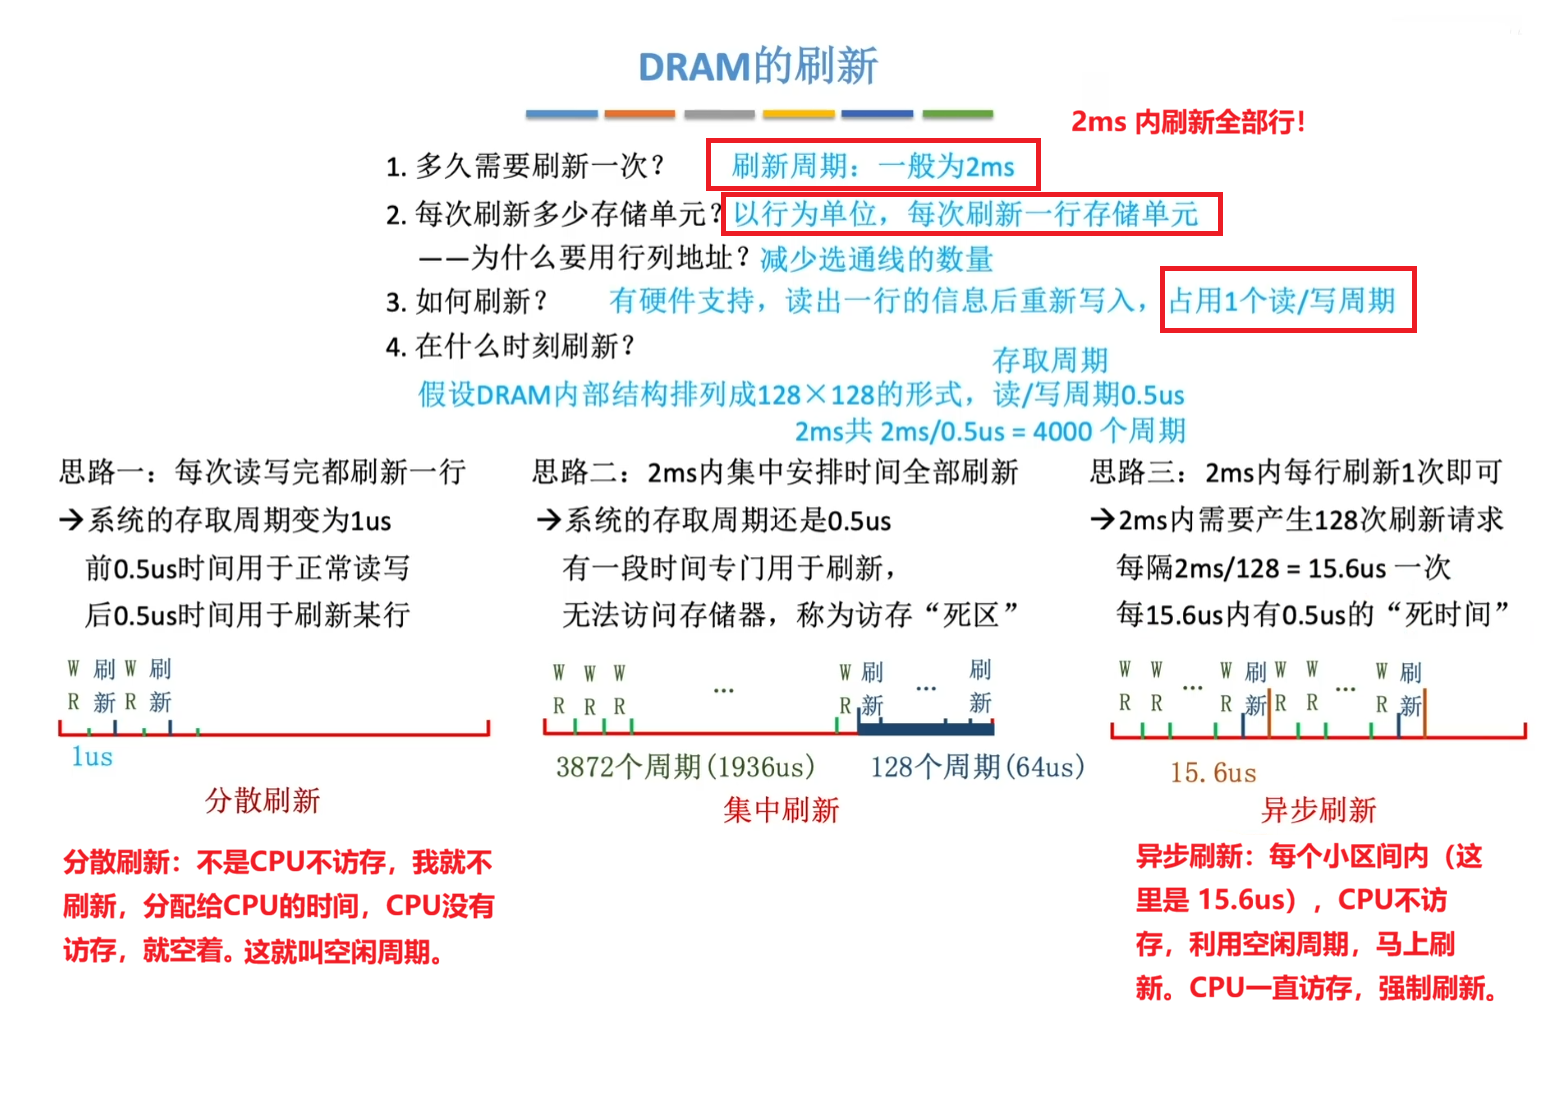
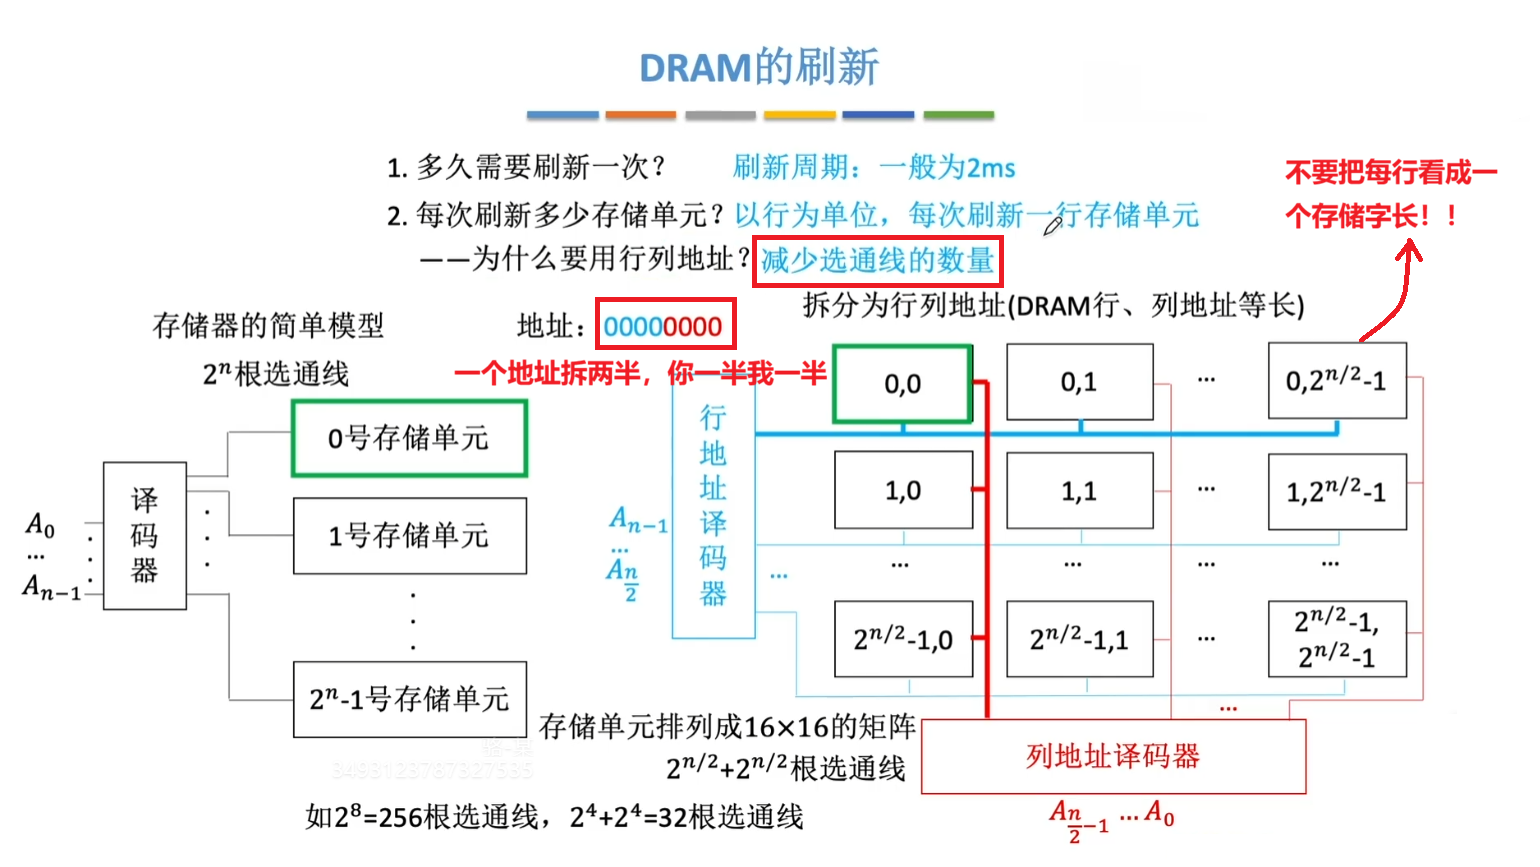 而 DRAM 芯片的刷新就是以行为单位进行的刷新,有三种刷新方式,如下图所示:
3.1.5.3 送行列地址
SRAM 和 DRAM 送行列地址有所不同,SRAM 是同时送(分用),DRAM 是不同时间分开送(分时复用),如图所示:
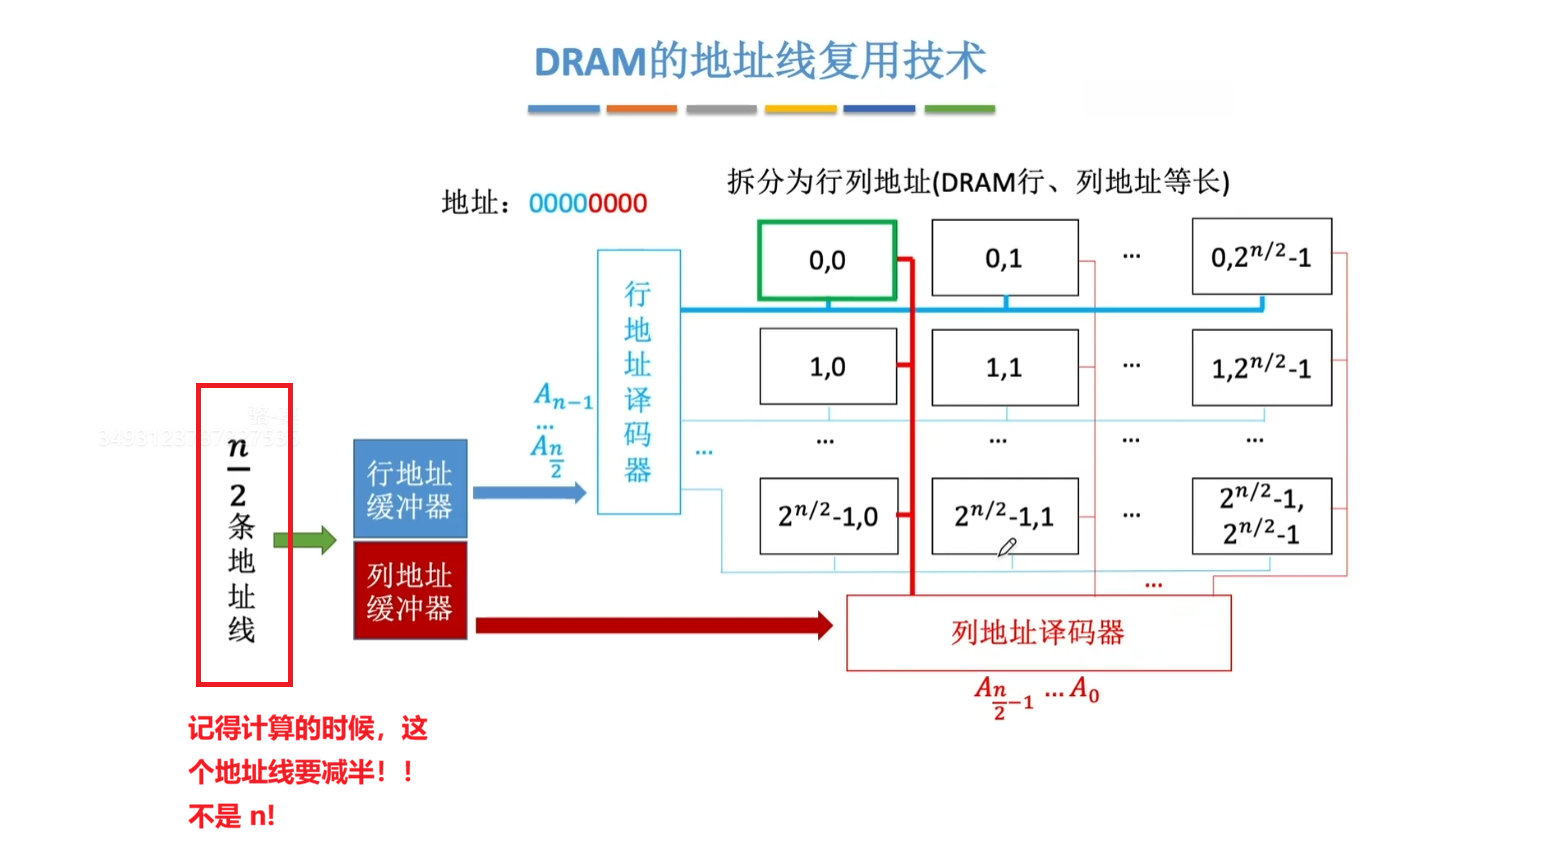 DRAM 判断地址引脚个数的时候,选行地址和列地址中最大的。
3.2 主存储器
3.2.1 只读存储器 ROM
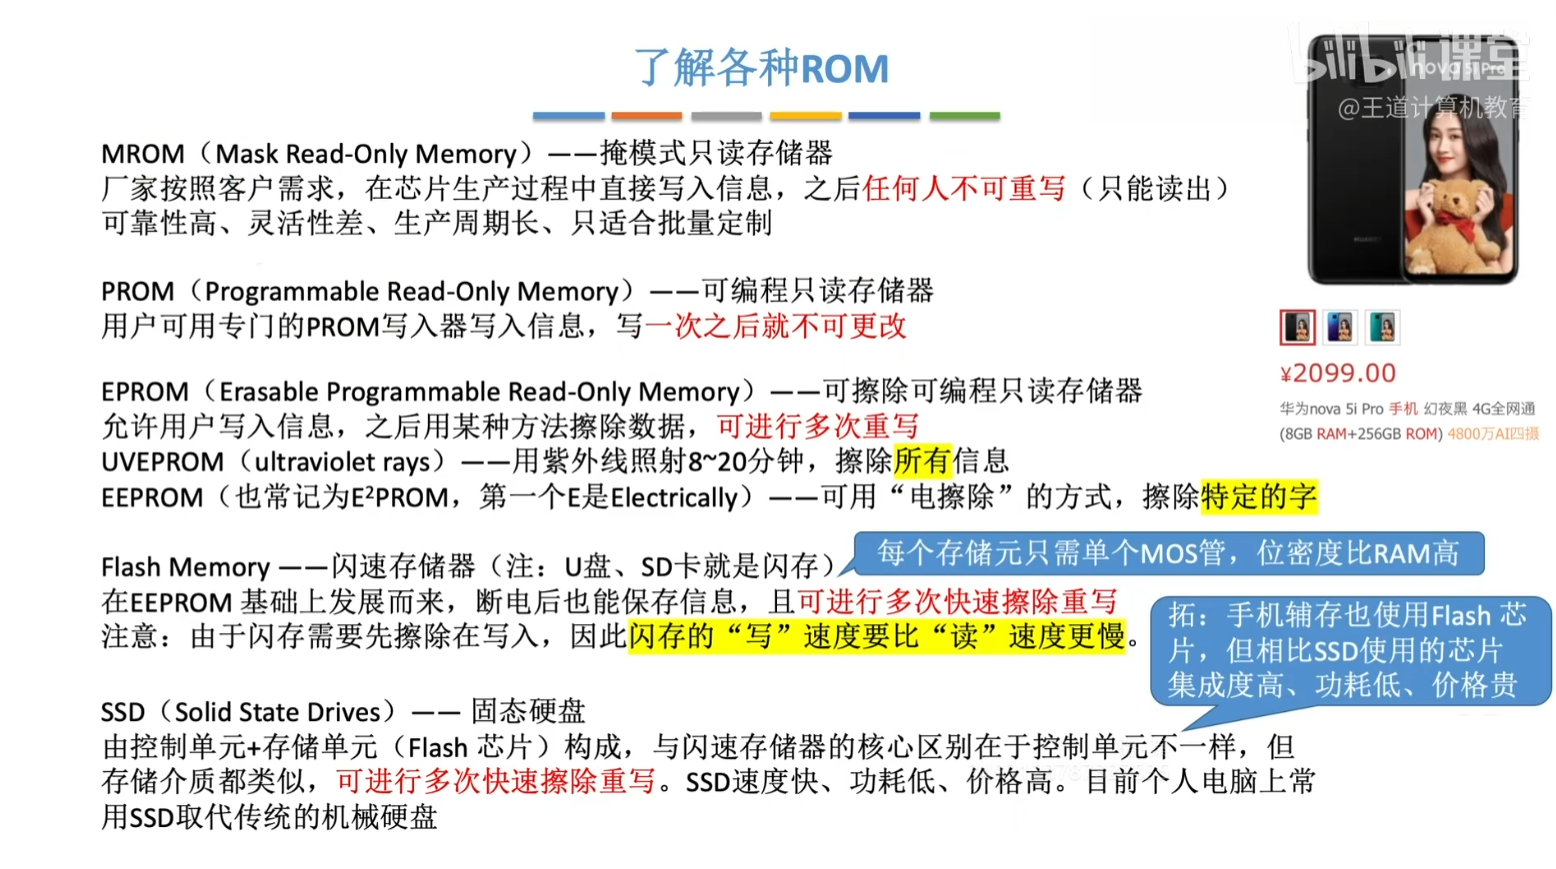
各种 ROM 芯片如下图所示:
注意:ROM 属于 非易失性存储器 大类,虽然 Flash 和 SSD 都能够可读可写,但是在考研中仍然将其算成 ROM,当成 只读存储器体系下的可编程只读存储器 来对待。同时虽然部分 ROM 不能进行写,但是 ROM 和 RAM 都采用随机存取的访问方式进行读/写。
 计算机中还存在一个非常重要的 ROM ,就是主板上的 BIOS 芯片。
BIOS 芯片用于存放计算机开机自检、硬件初始化和引导操作系统(开机)所需的固件程序,使计算机上电后能够启动并管理基本硬件。
如下图所示:
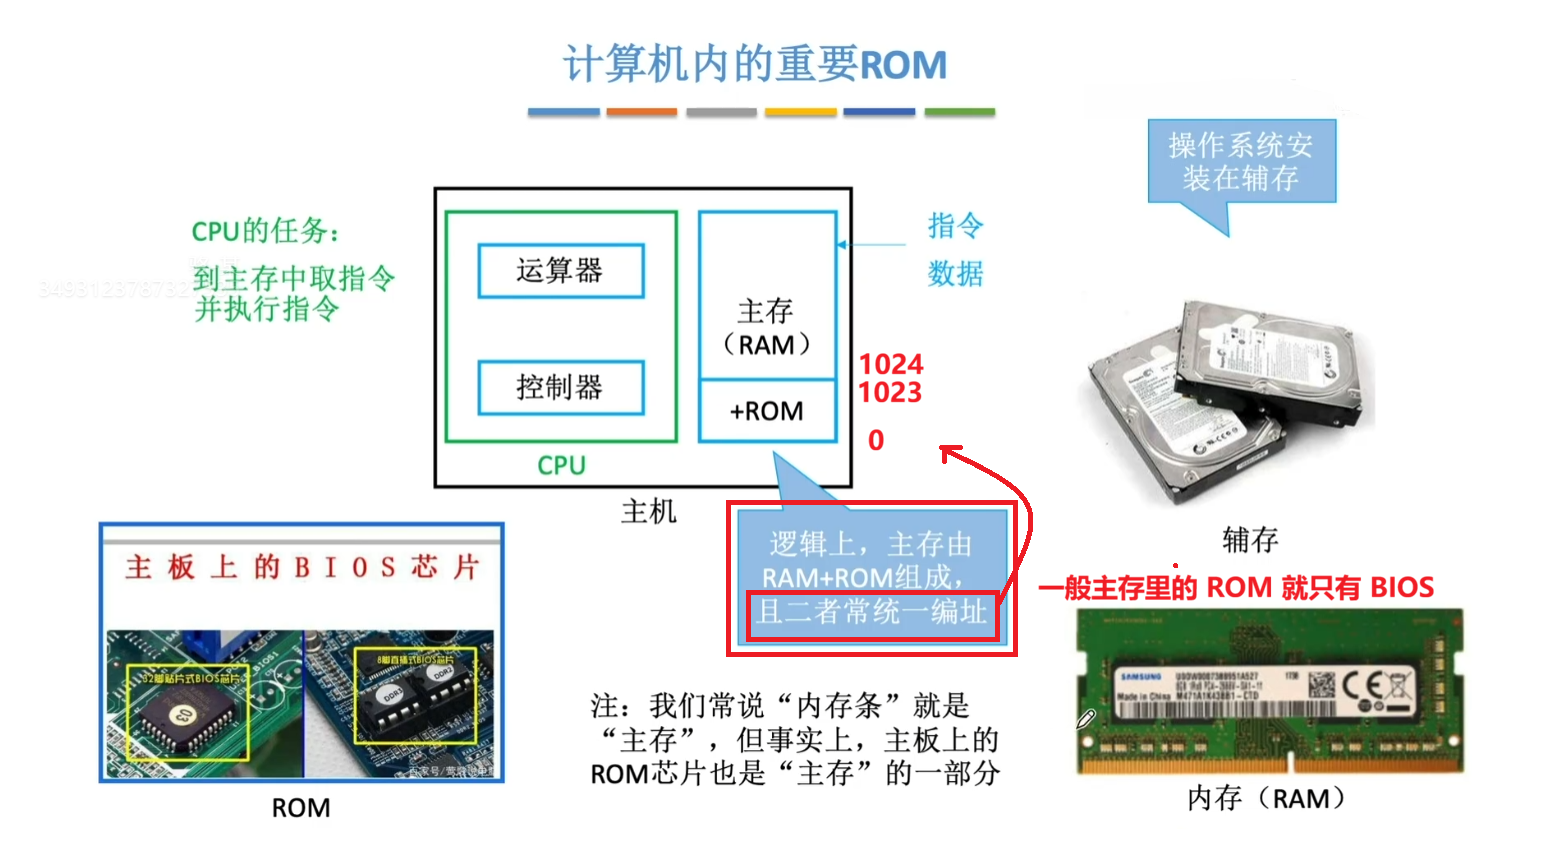 可以看见在考研模型中,主存由 RAM + ROM 构成,
3.2.2 双端口 RAM 和多模块存储器
本小节主要是讲述 提升主存速度的方法,思维导图如下:
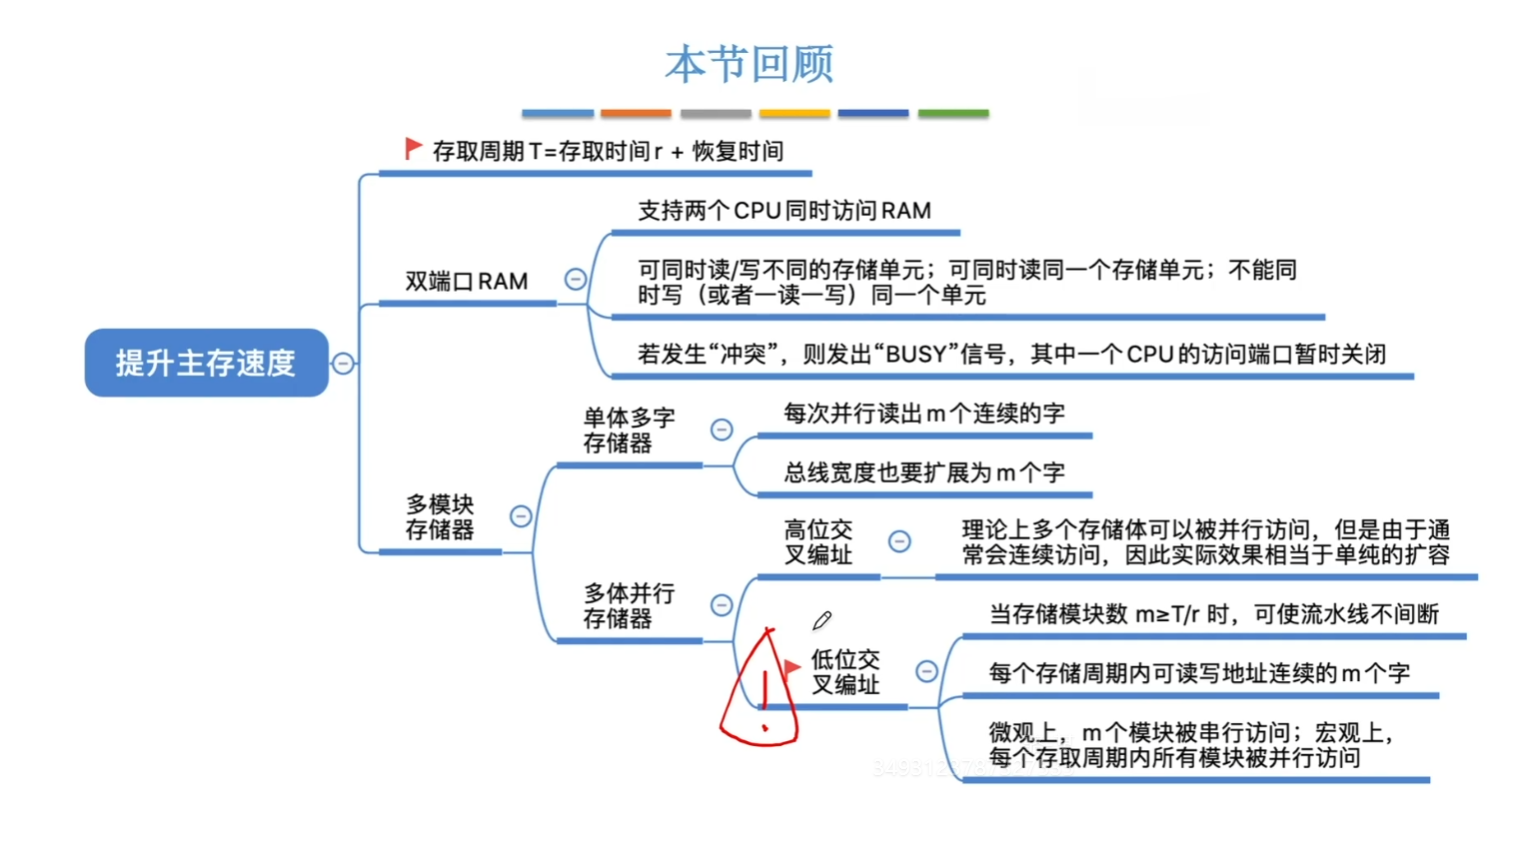
3.2.2.1 多模块存储器
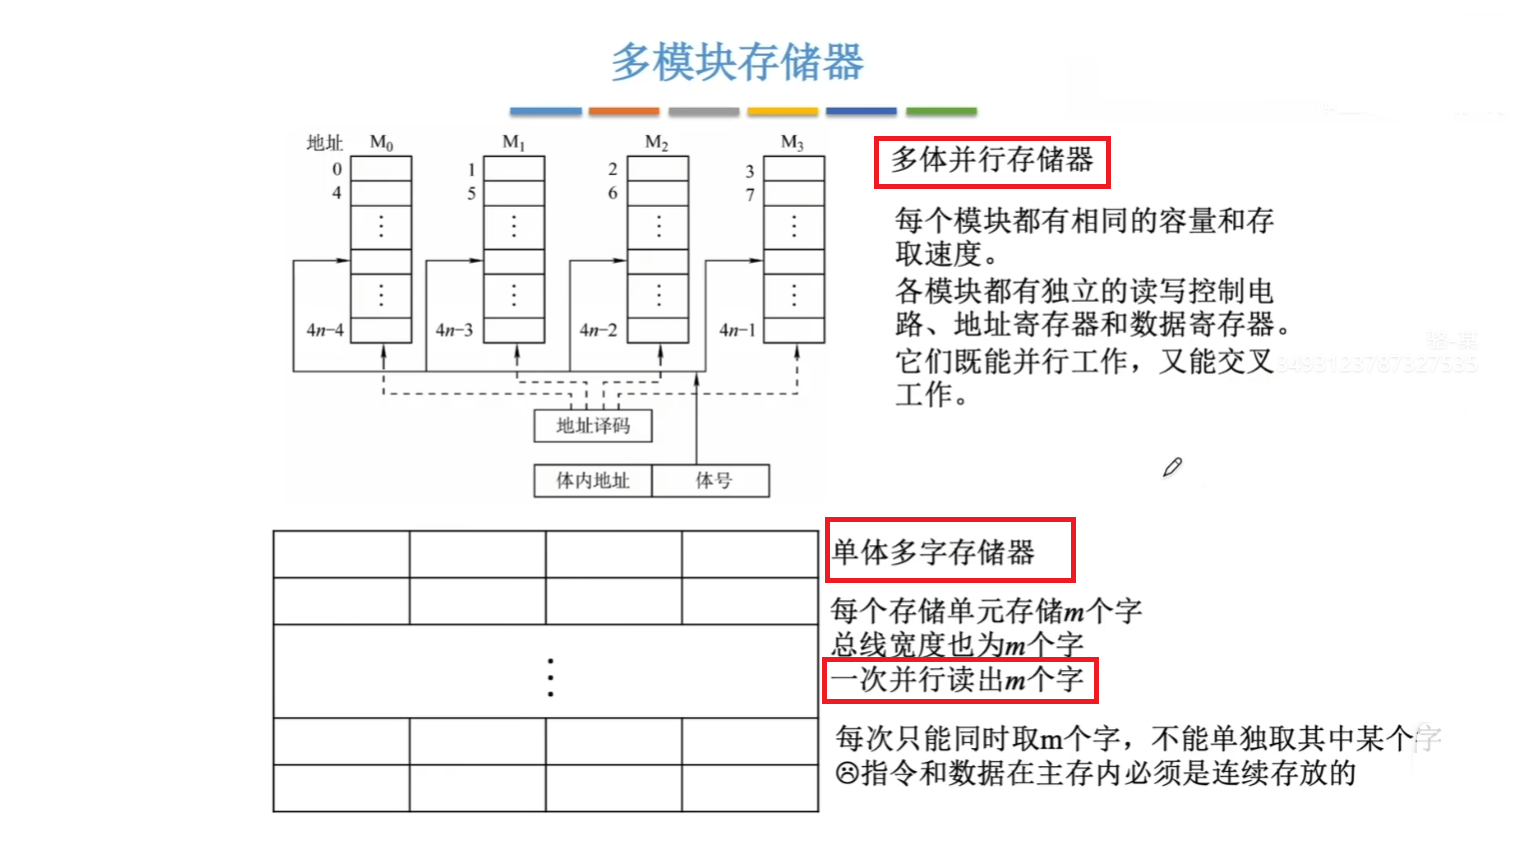
多模块存储器如下图所示:
下图这里应该是为了简化模型,起始每个模块(考研里面一般指一个存储体中的一个芯片)应该还是分行列存储的。
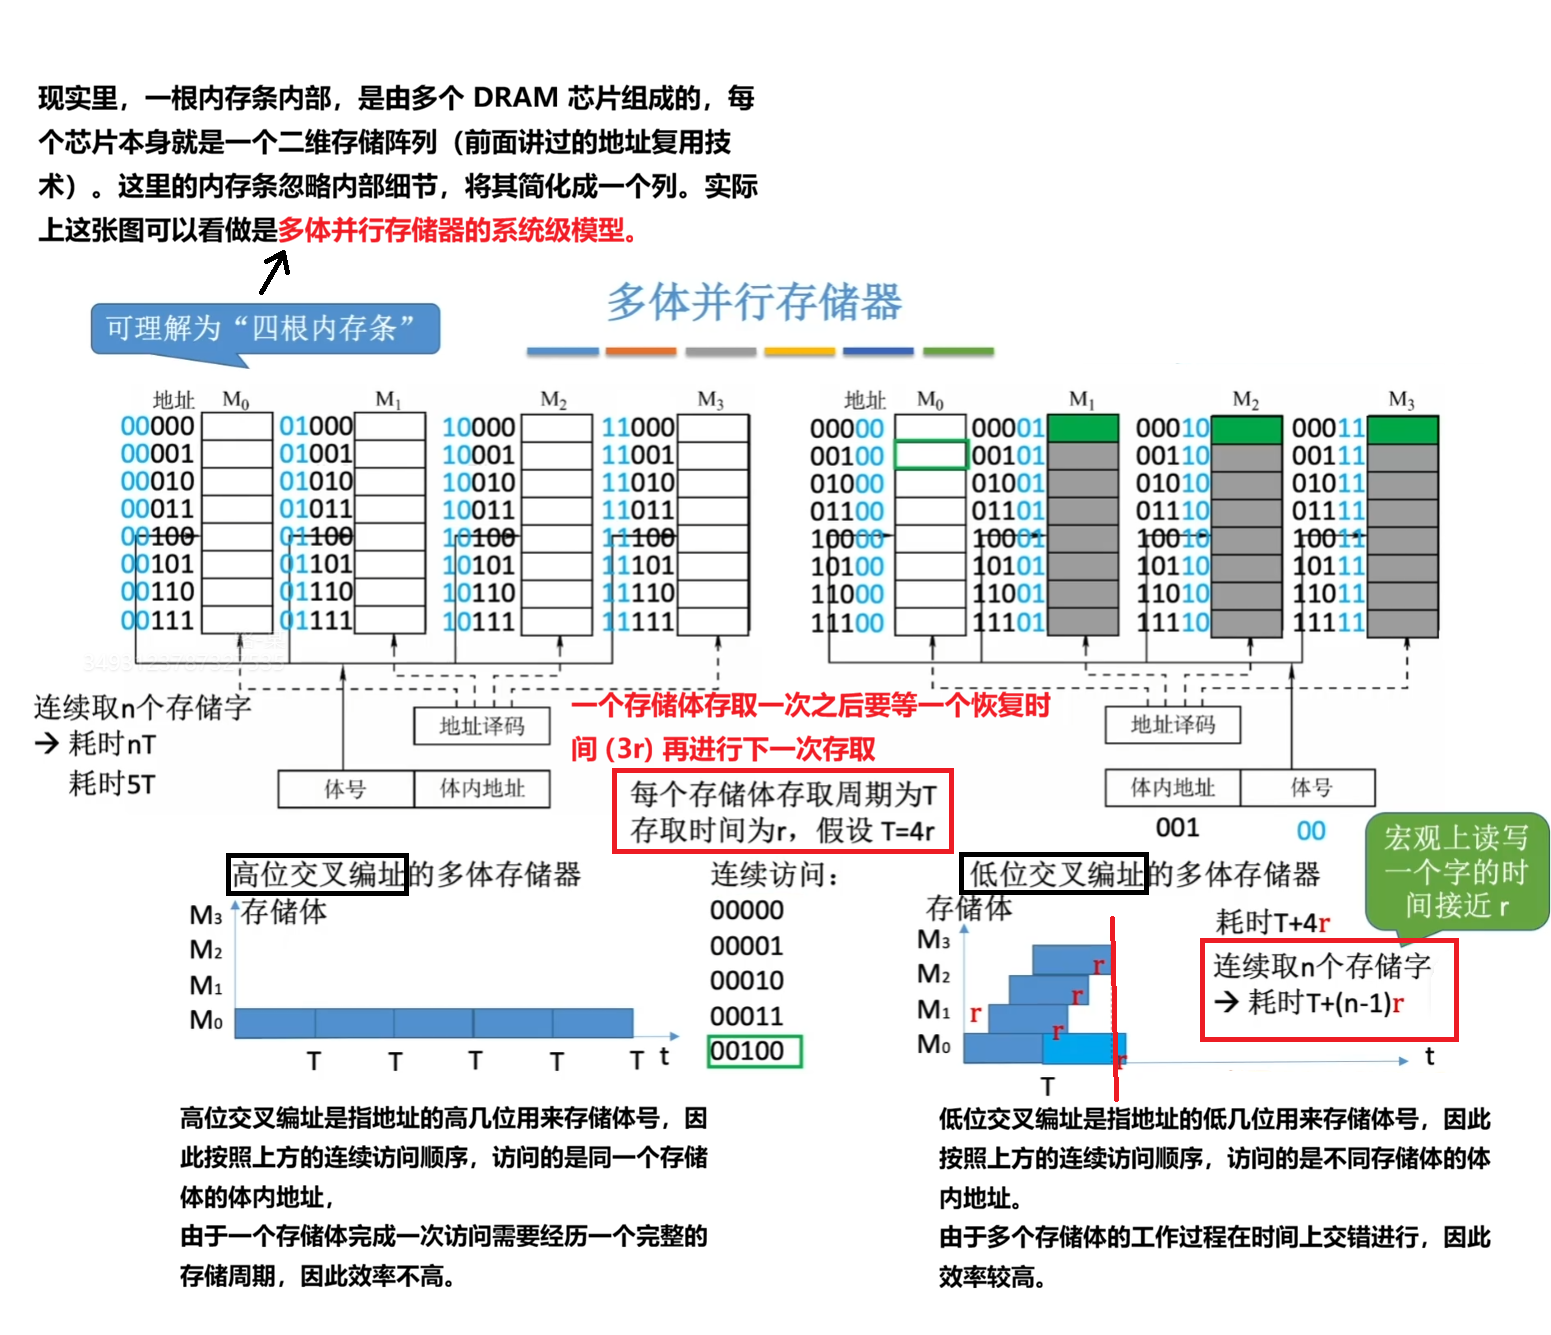 注意:上图说的地址容易误解,CPU 给出的地址是 行列地址+体号,但是体号并不进入存储其中的地址线,而是进入地址译码部分。所以 算地址引脚的时候不要把体号算上了。
那采用低位交叉编址达到类似“流水线”的方式进行存取之后,多体交叉存储器中,存储体数 (m) 应该取多少,才能让“流水线”充分发挥作用。 如下图所示:
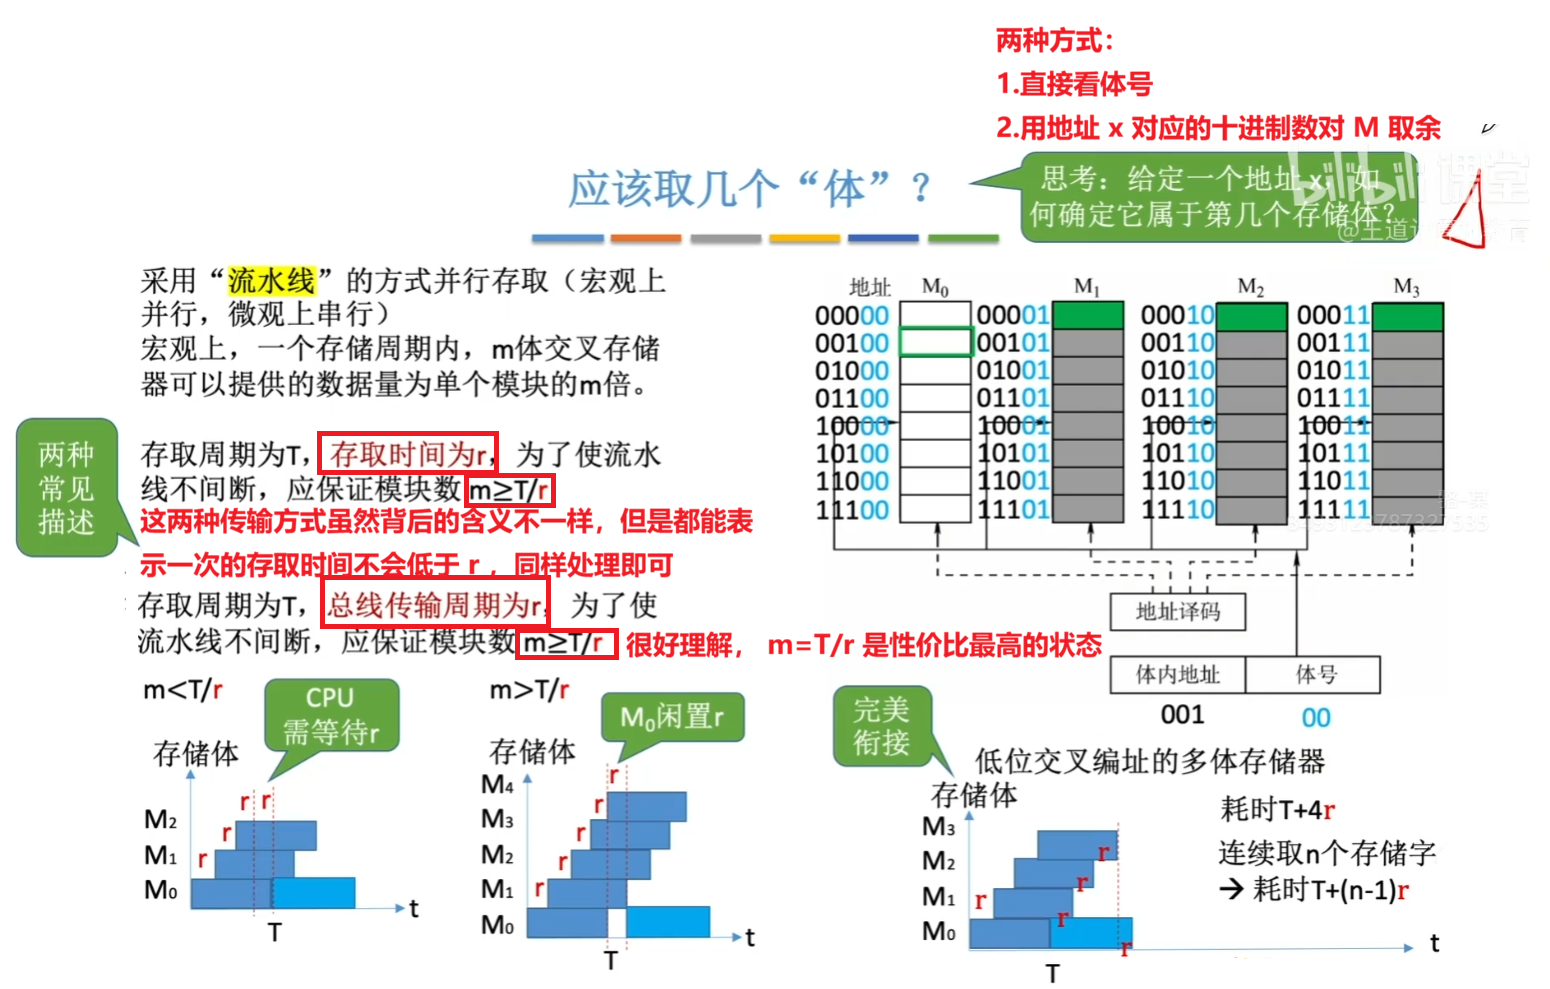 值得注意的是多模块存储器具有两种 启动方式:
- 轮流启动:就是上述说的方式。
- 同时启动:当所有存储模块一次并行读/写的总位数恰好等于存储器数据总线的宽度时,就能够采用这种方式,这也正是要求 内存对齐的原因,比如一次要同时从多个模块(假定地址总线位数为 32)取出一个 int 类型数据,那么起始地址必须满足相应的对齐要求,不然可能会涉及到两次读写。
突发传输(了解): CPU/控制器明确发起了突发读请求,并给出起始地址和突发长度(或由协议规定长度)。一般是在低位交叉编址中采用,因为不同地址分布在不用存储体中,能够更快的读/写。
与多体单字存储器相对应的是 单体多字存储器,对比如下图所示:
3.2.2.2 双端口 RAM
双端口 RAM 技术如下图所示:
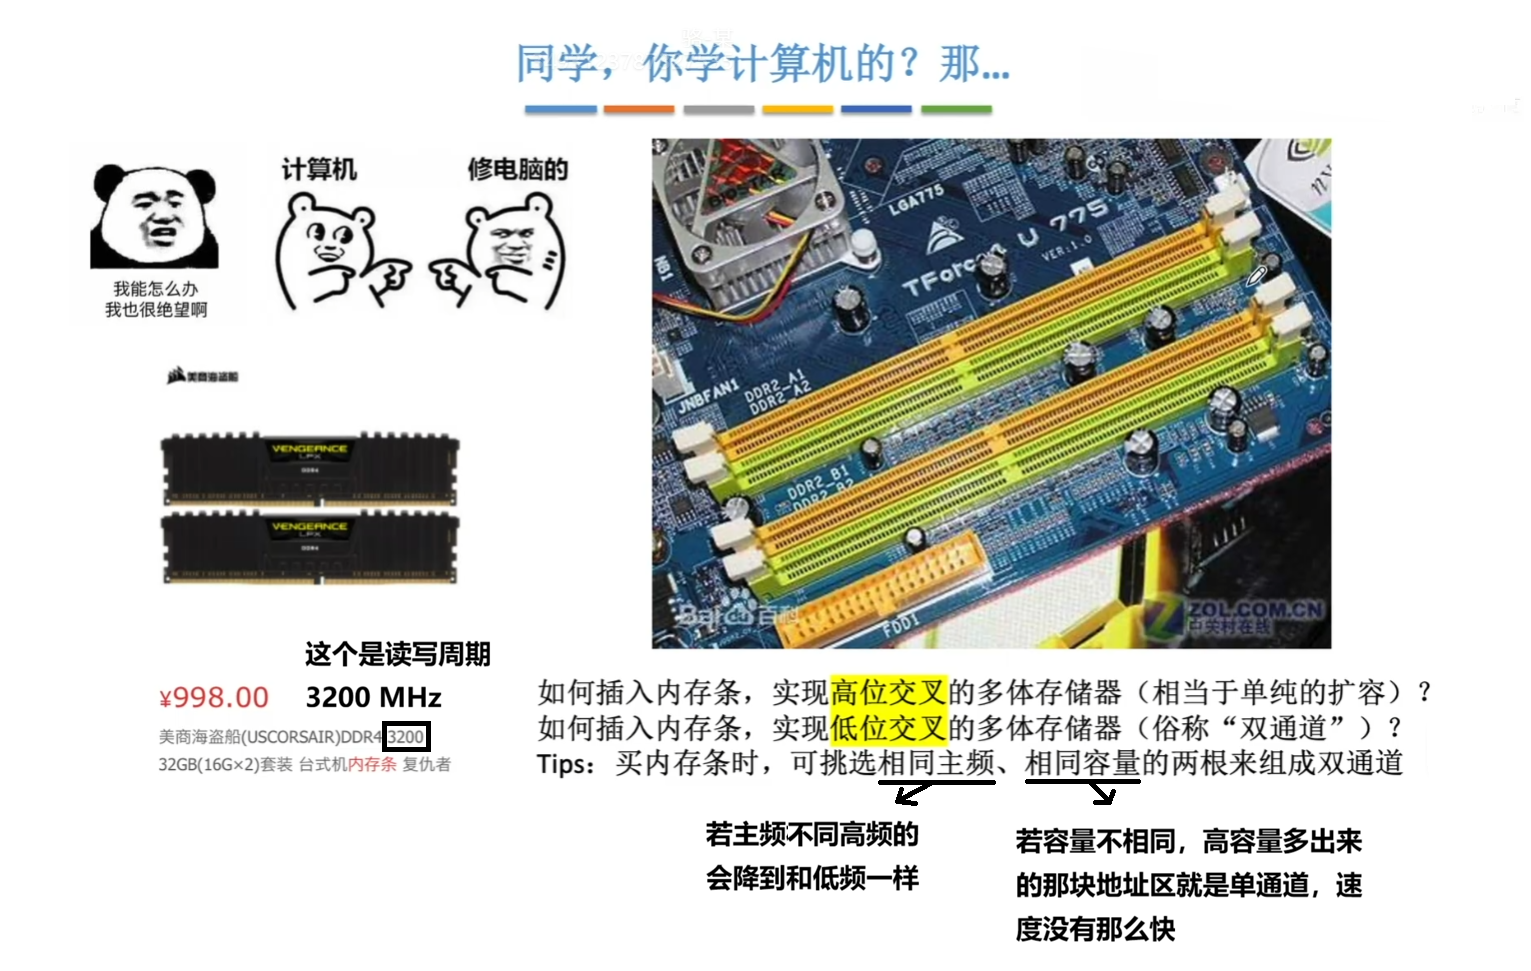
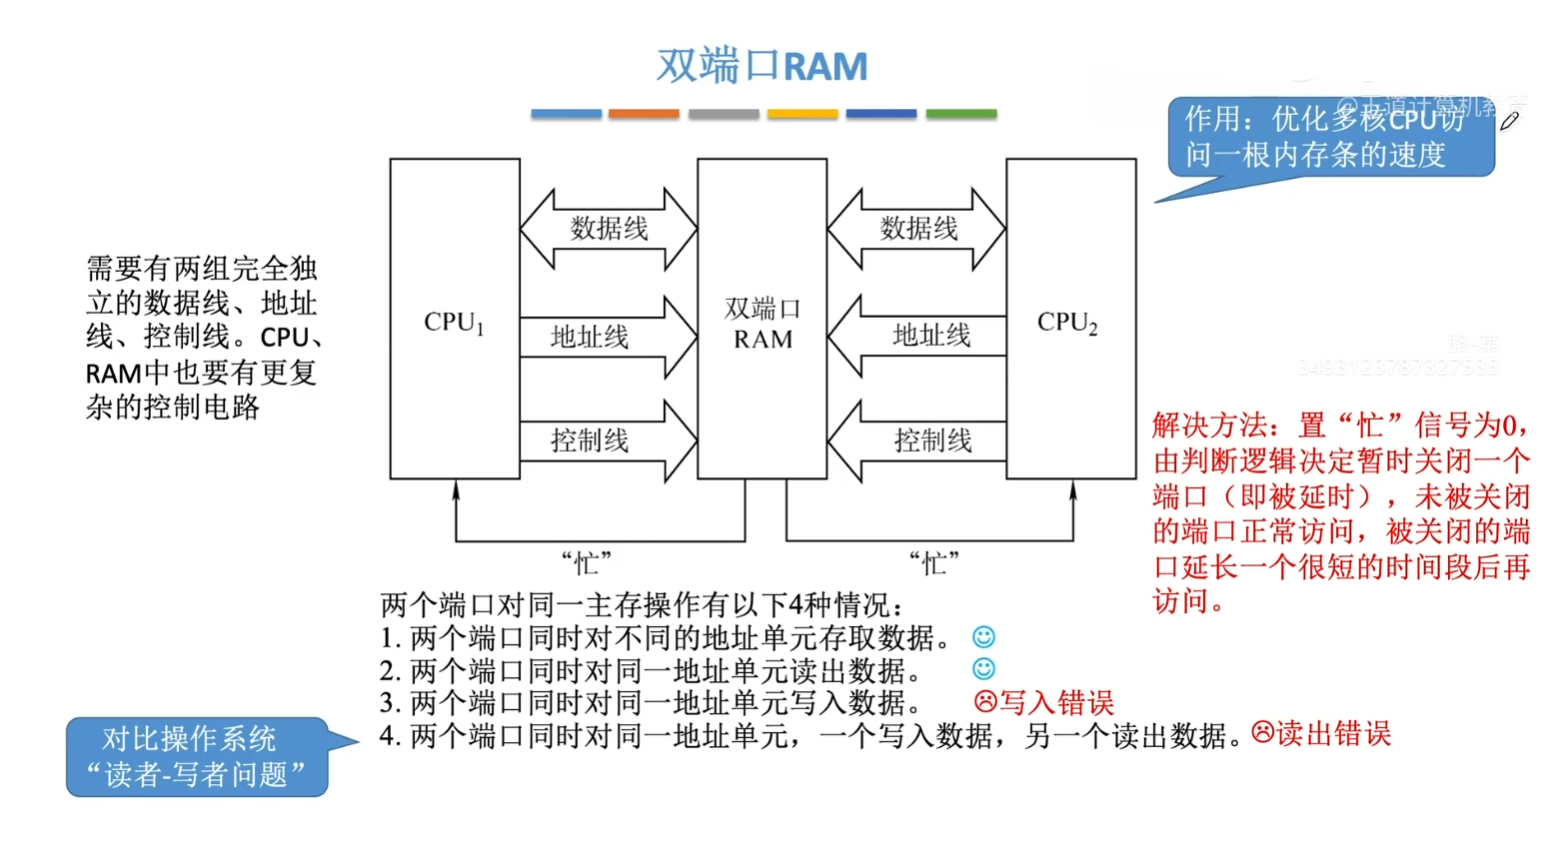 很明显,其实这个双端口 RAM 就是一个多体存储器,现代的多体并行思想,确实已经从 “多根内存条” 下沉,集成到了单根内存条、甚至单个 DRAM 芯片内部。
当然,放两根内存条(组成双通道),属于叠加了并行度,性能也会比单条更好。但是记住,叠加的内存条最好主频和容量都要相同。
那么,恭喜你,当有人问你会不会修计算机时,你可以说:“我能帮你改成低位交叉的多体存储器(插根内存条)”。
3.3 主存储器和 CPU 的连接
3.3.1 单块存储芯片和 CPU 的连接
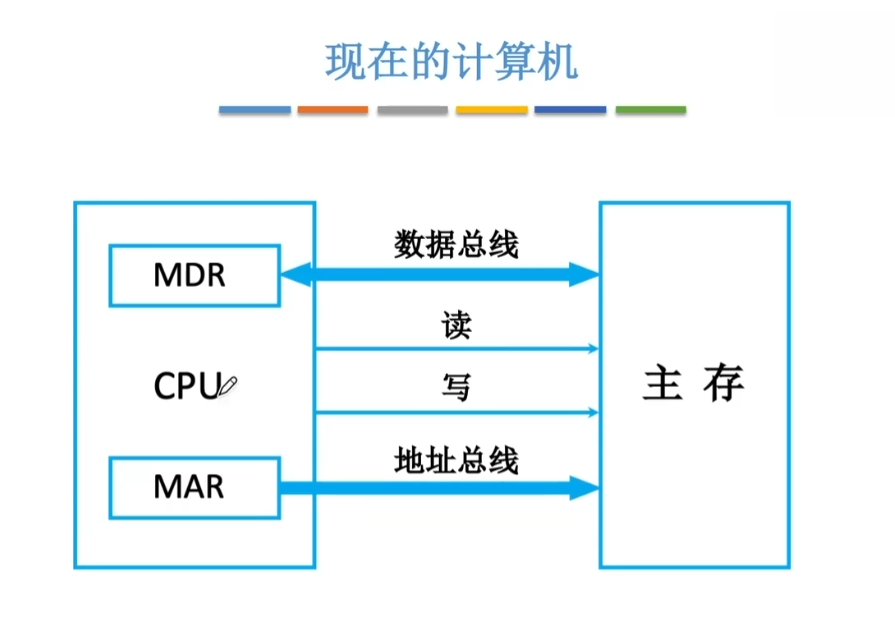
首先纠正一个可能存在的误区,现代计算机 MAR 和 MDR 并不是在主存储器里,而是在 CPU 中,原先 MAR 和 MDR 的位置只是一个普通寄存器(可能用作缓冲作用),如下图所示:
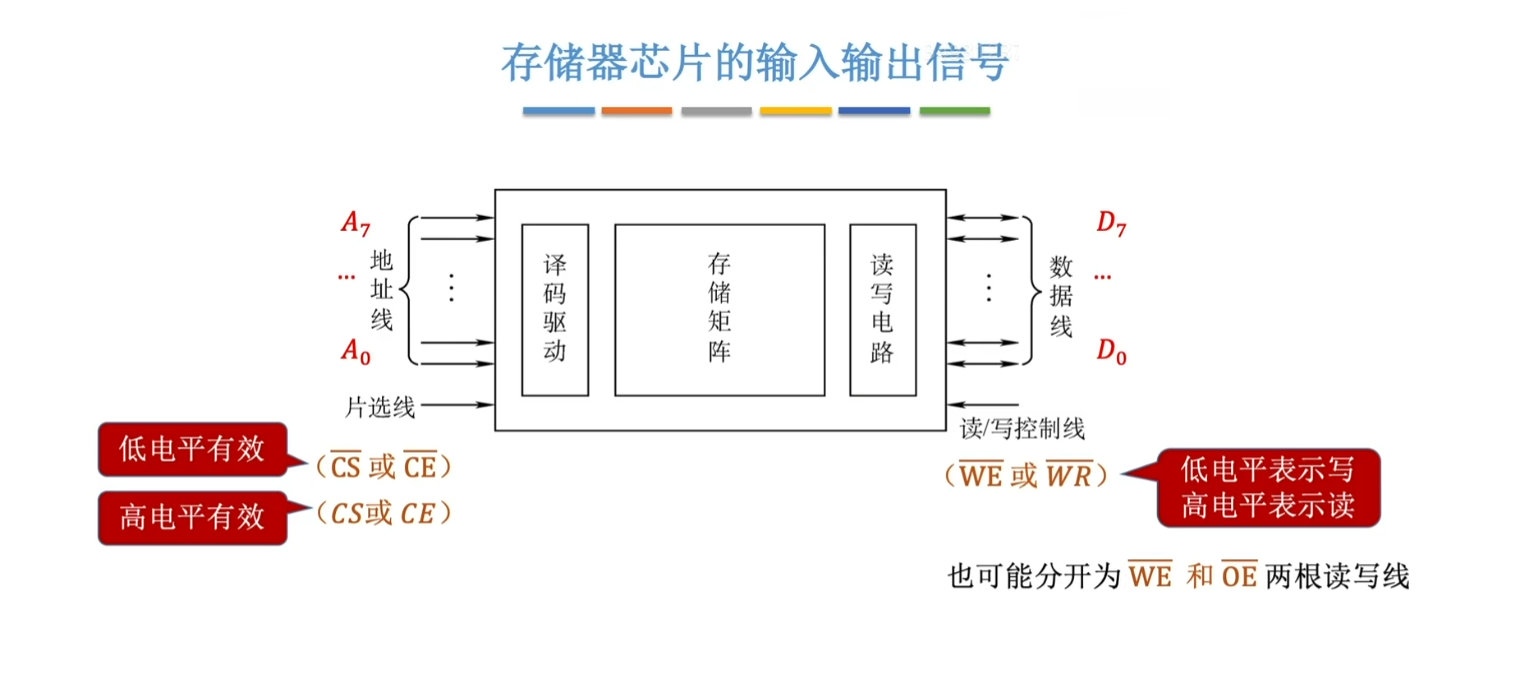
 一个内存条通常是由多块存储芯片组成的,而单个芯片与 CPU 的连接如图所示:
主要看看存储芯片中常用的输入输出信号的英文缩写。
3.3.2 位扩展
位扩展如下图所示:
在考研模型中就是把多个芯片并行起来以满足,数据总线的长度 = 芯片个数*存储字长。
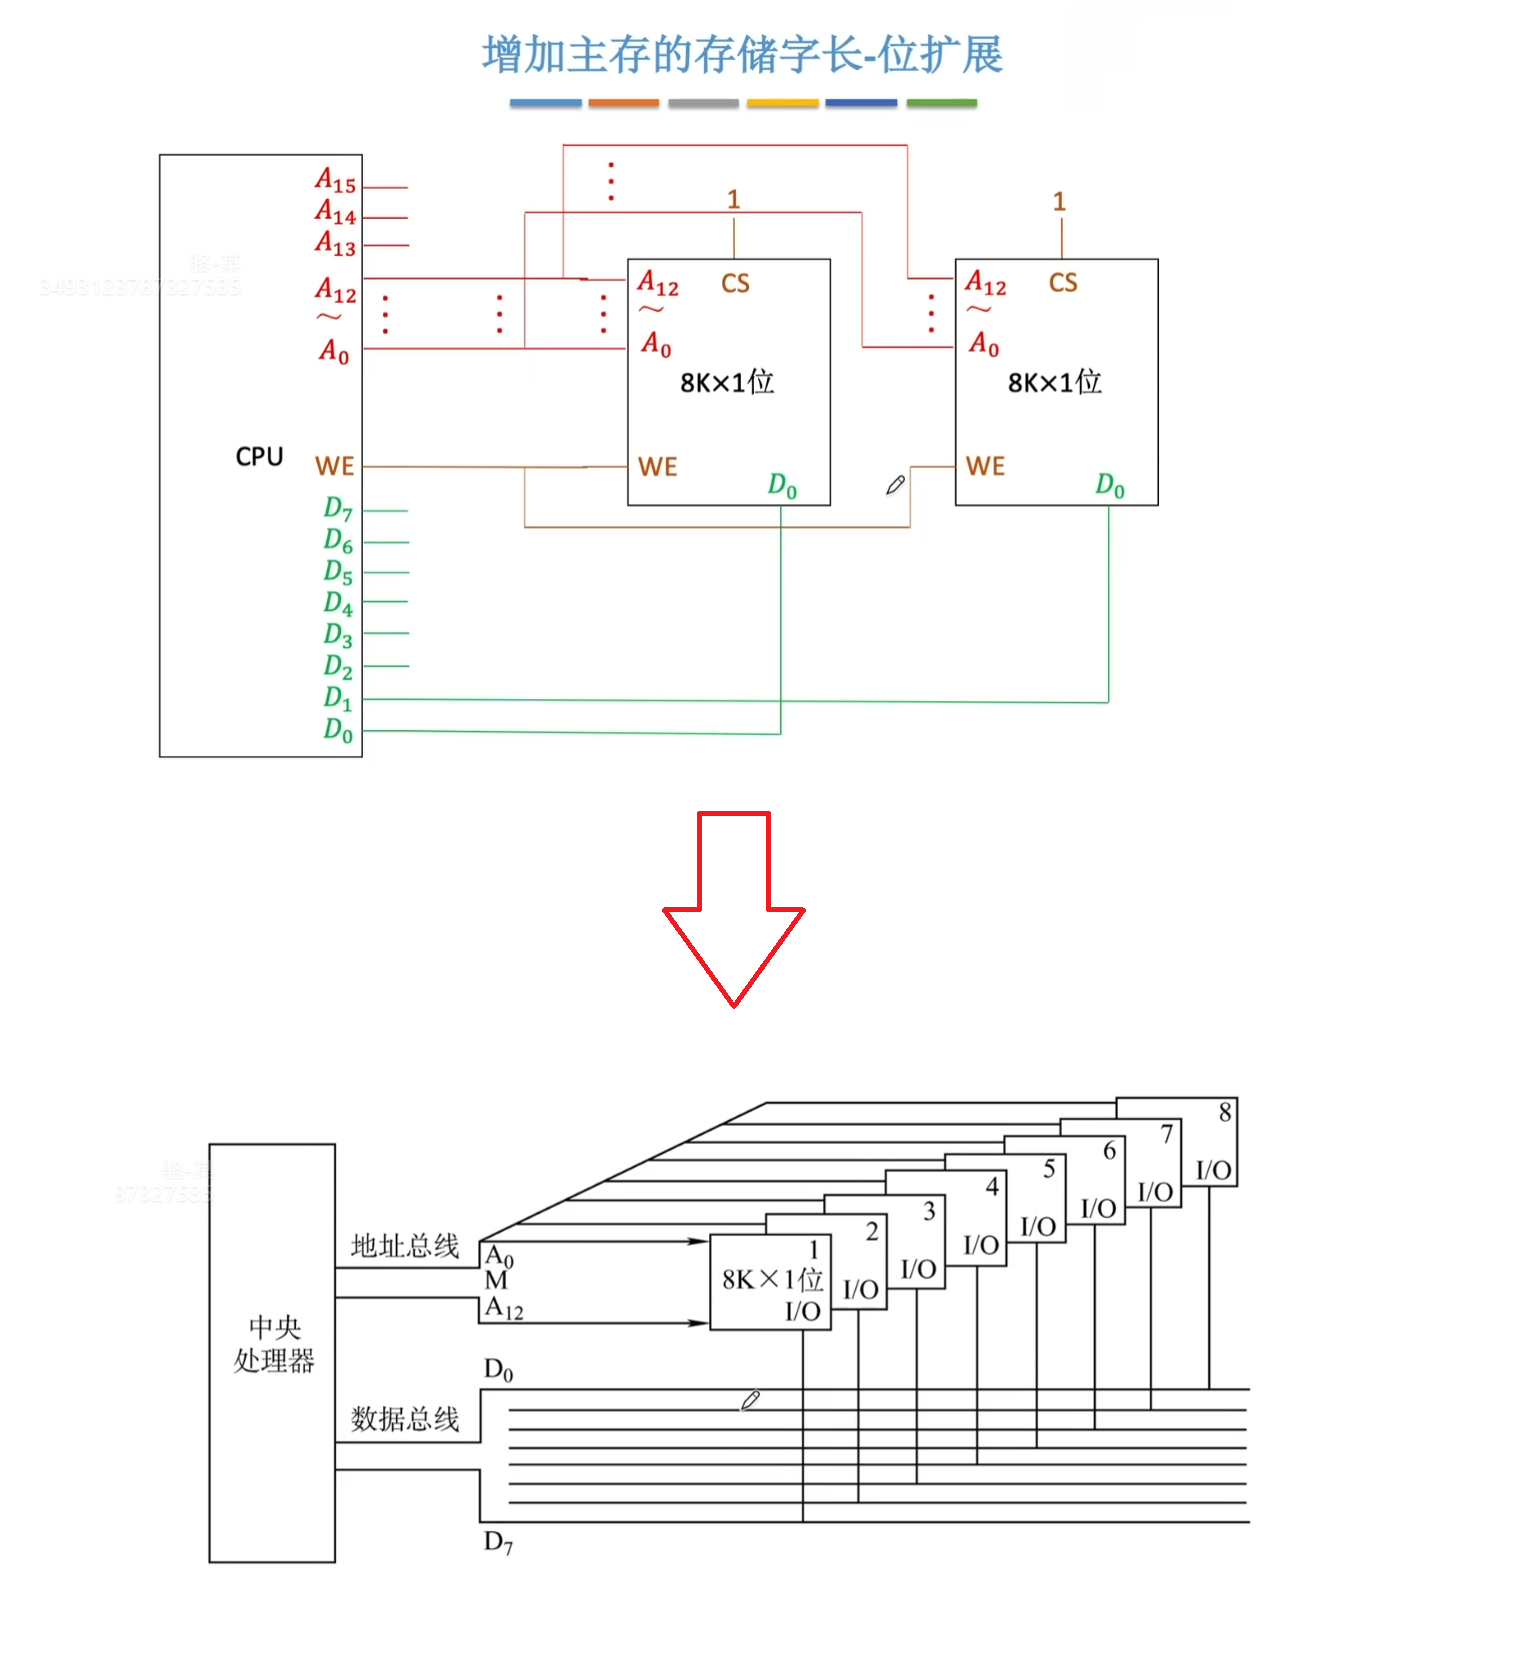
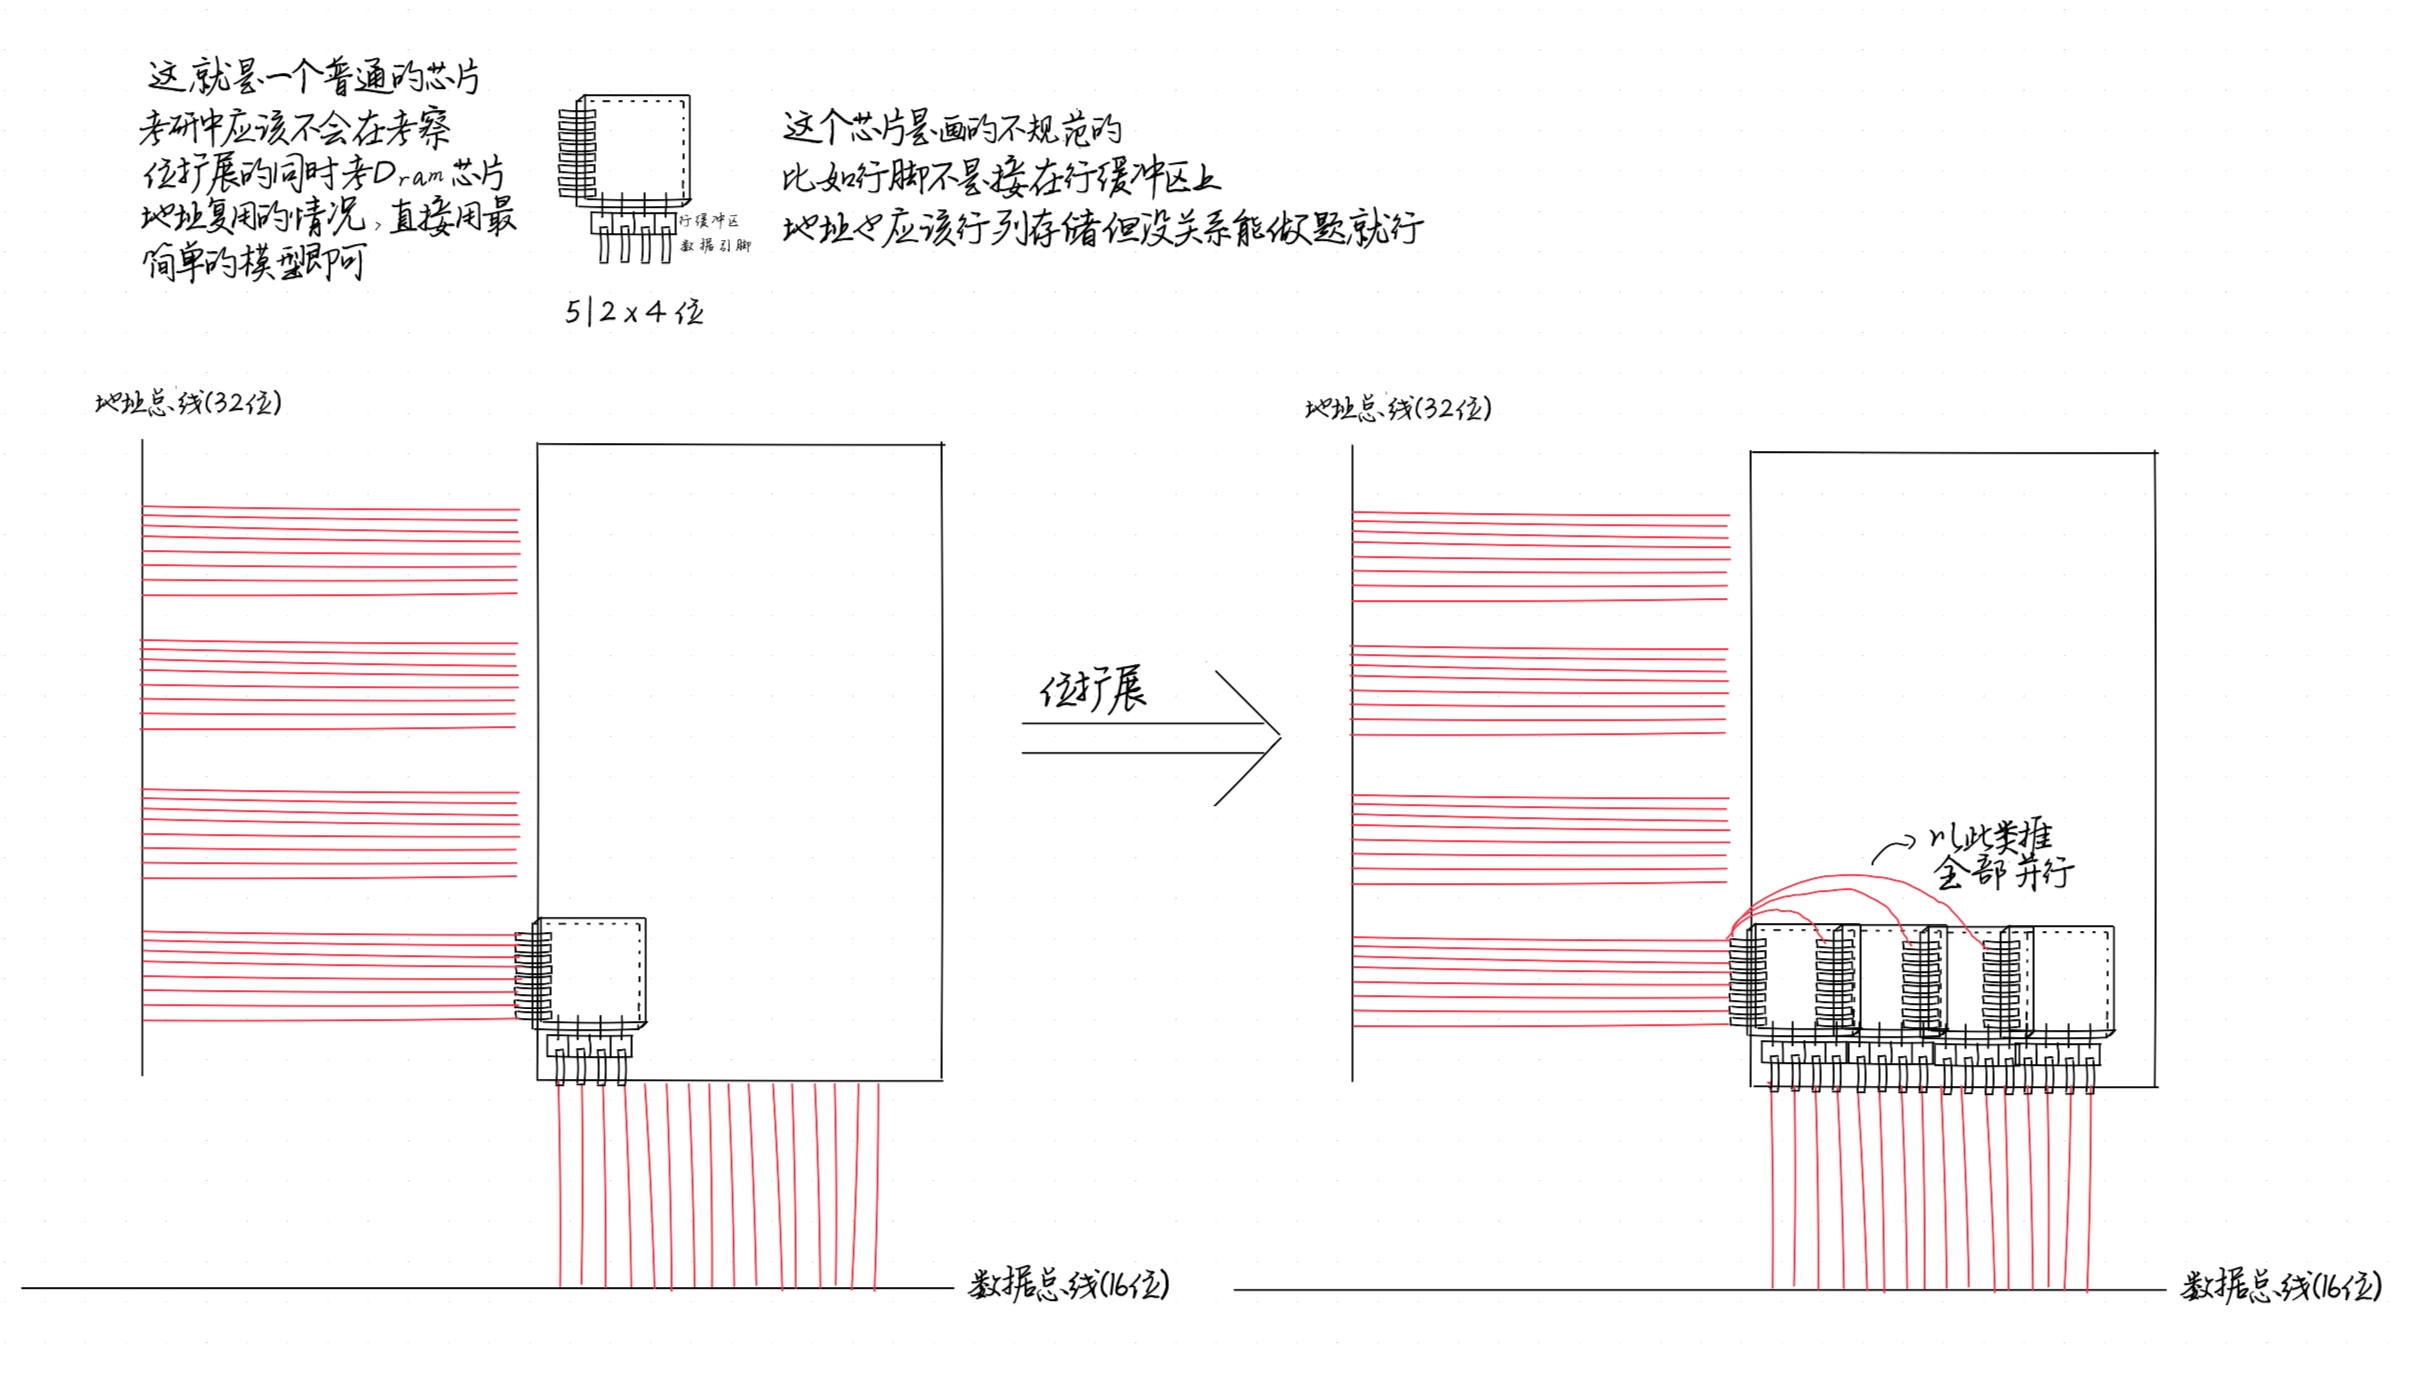 很明显是不需要片选的。
3.3.3 字扩展
字扩展是用于增加存储单元的数量(扩大地址空间),扩展之后在使用的时候必须进行选芯片的操作(与位扩展不同,位扩展不用选芯片),因为不同芯片中对应的是不同地址的数据,同时使用会发生冲突。 选择芯片的方式分为 线选法 和 译码片选法,分别如下所示:
- 线选法:
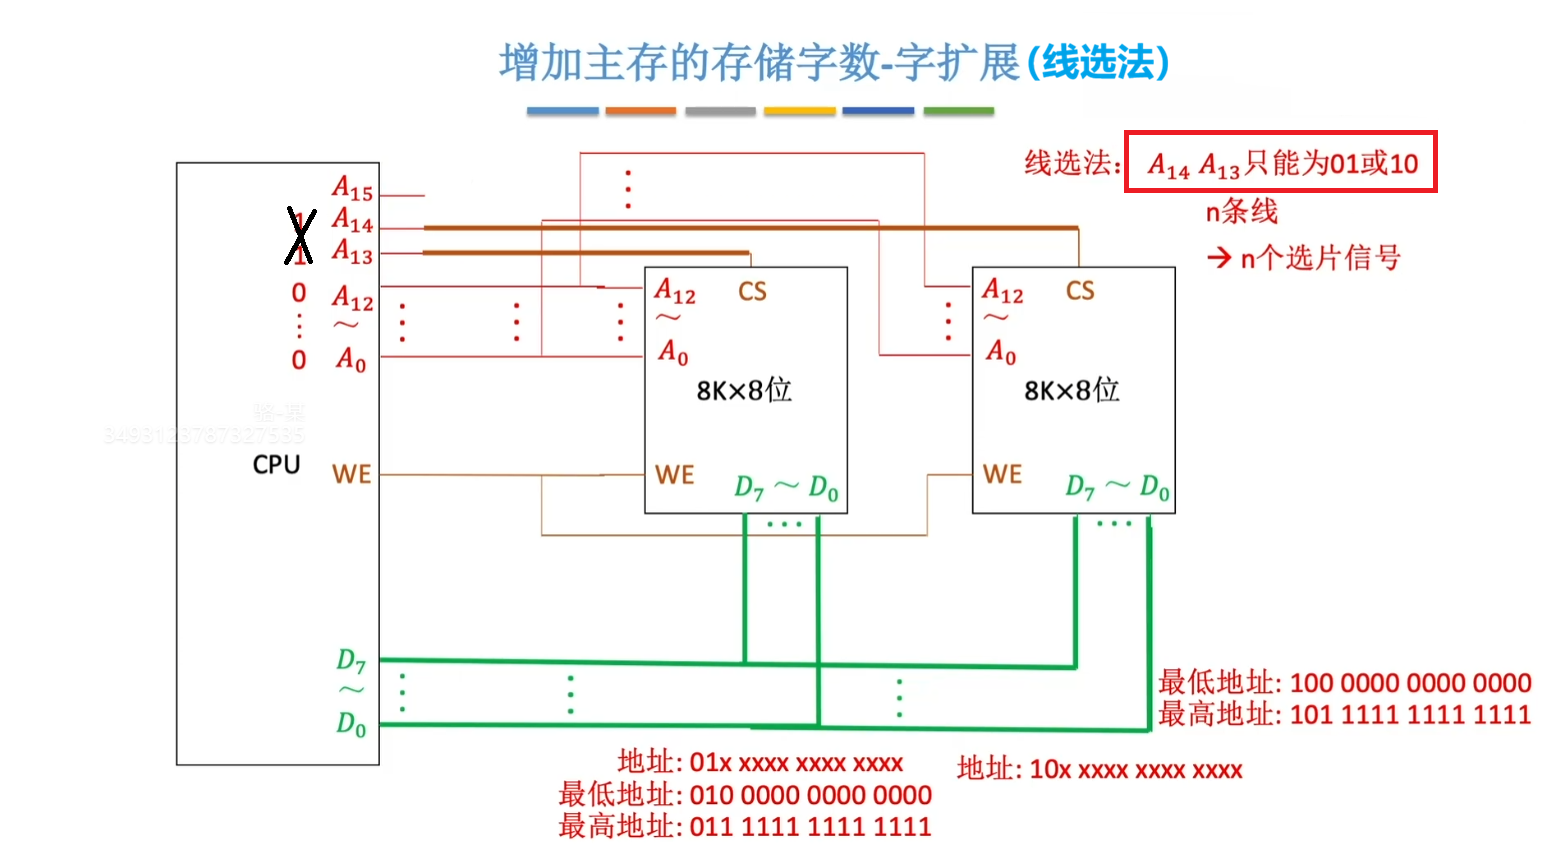
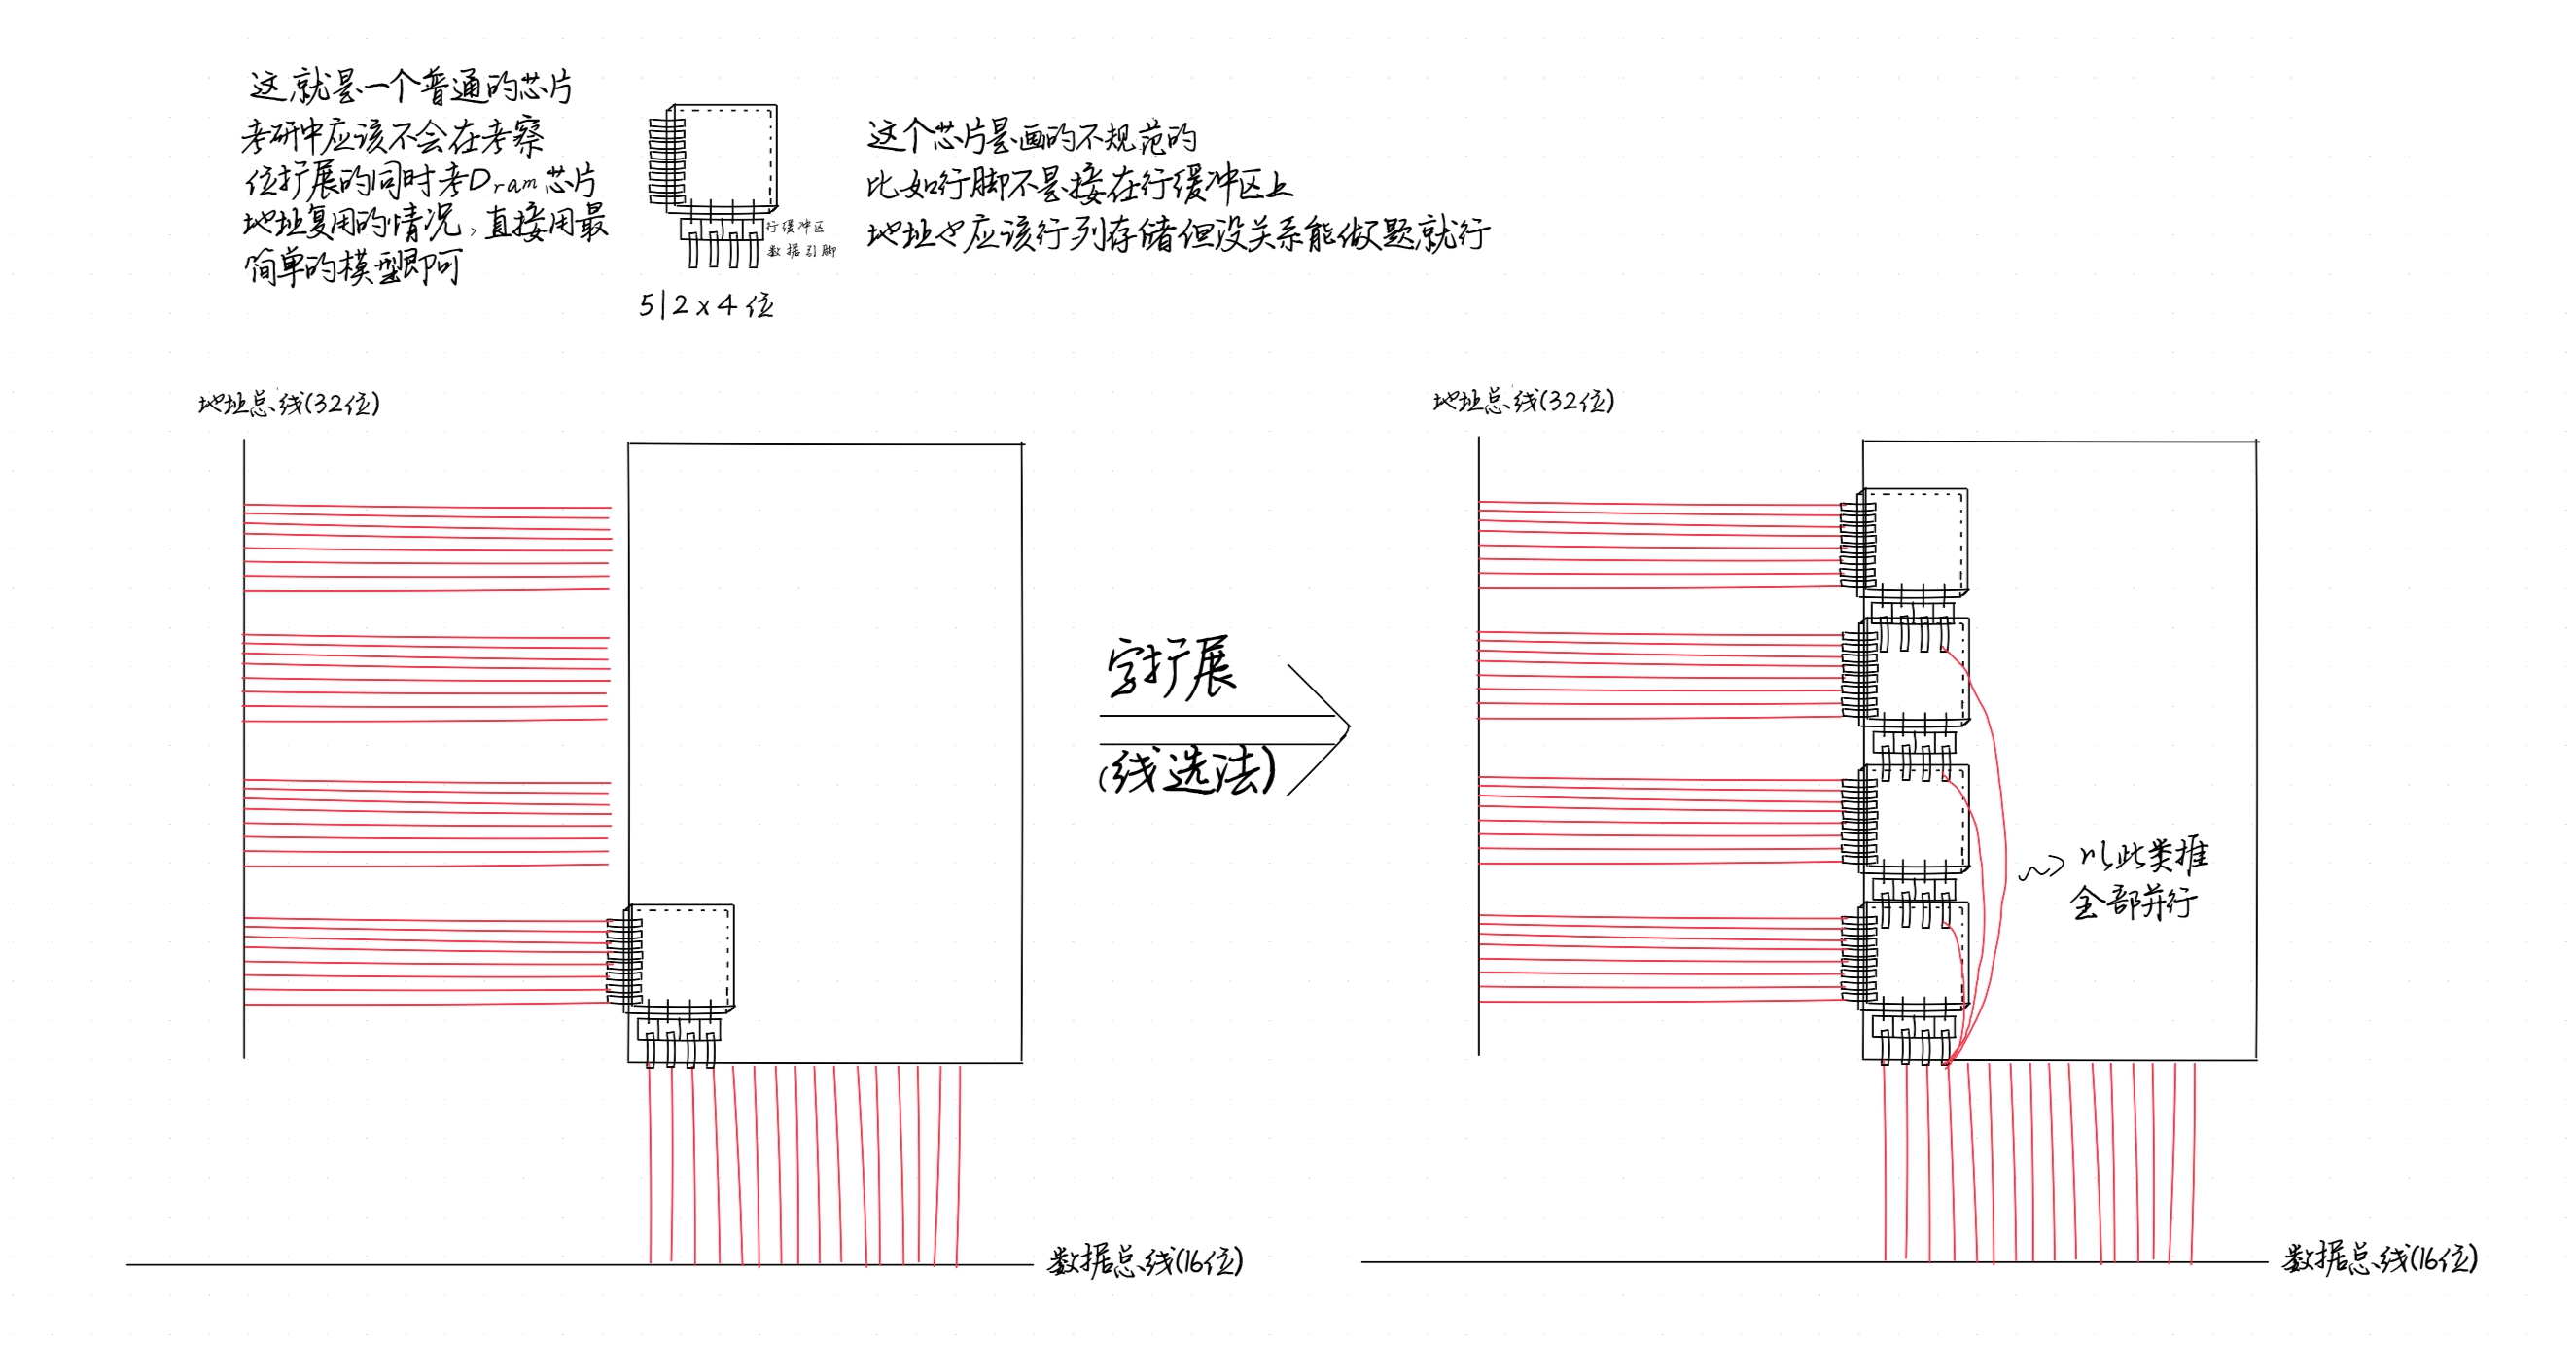 显然,线选法的方式存在过于浪费地址线资源的弊端,因此实际应用中也不常用这种方法,而更加常用译码片选法。
- 译码片选法:
值得注意的是,译码片选法 用还没用到的较高位做片选信号。故这个是和低位交叉存储有区别的,尽量分开成两个模型看。
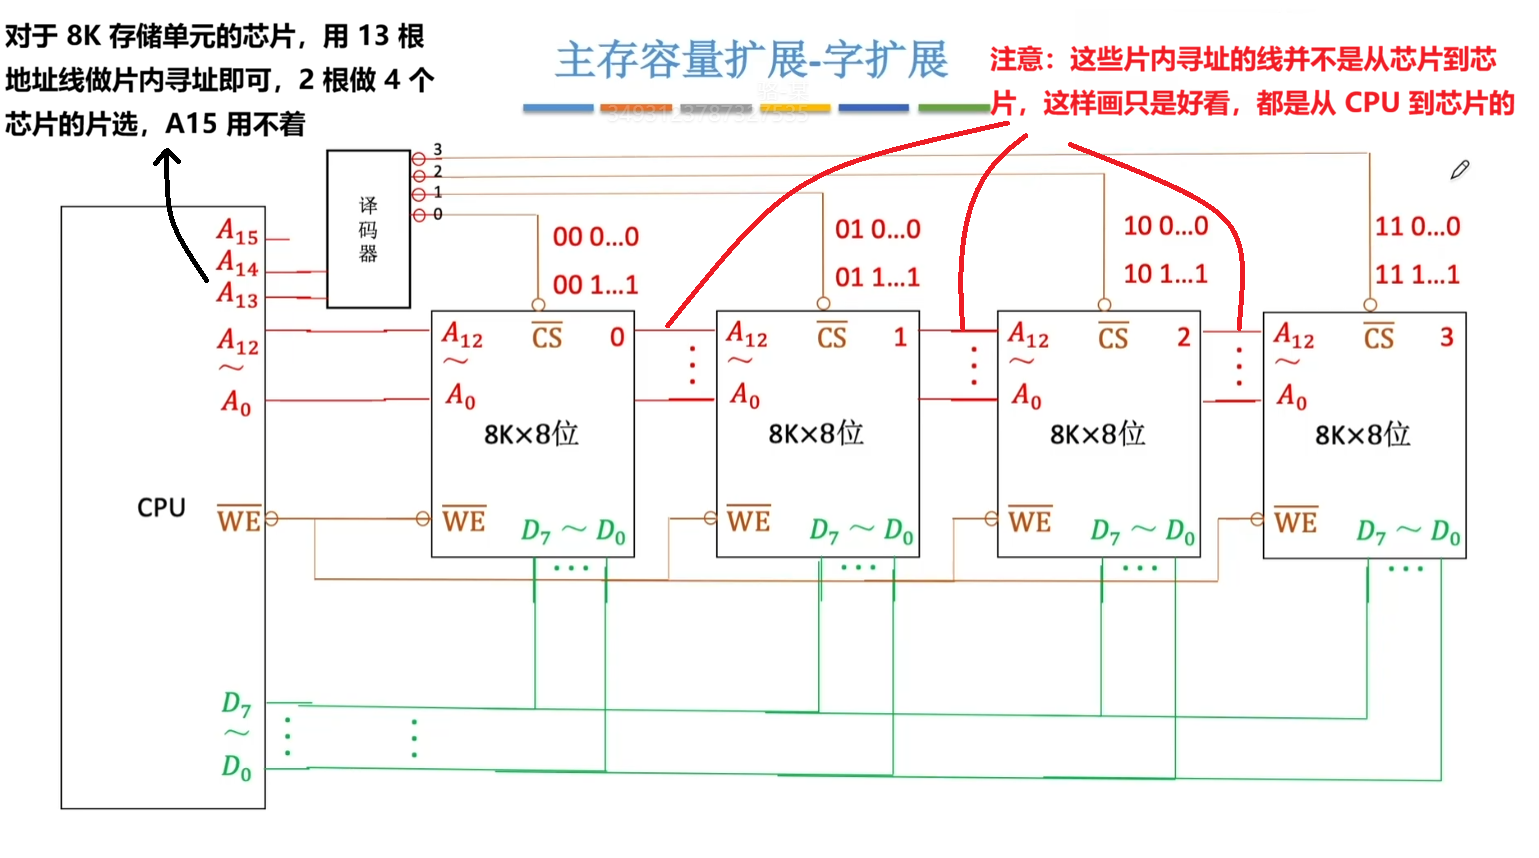
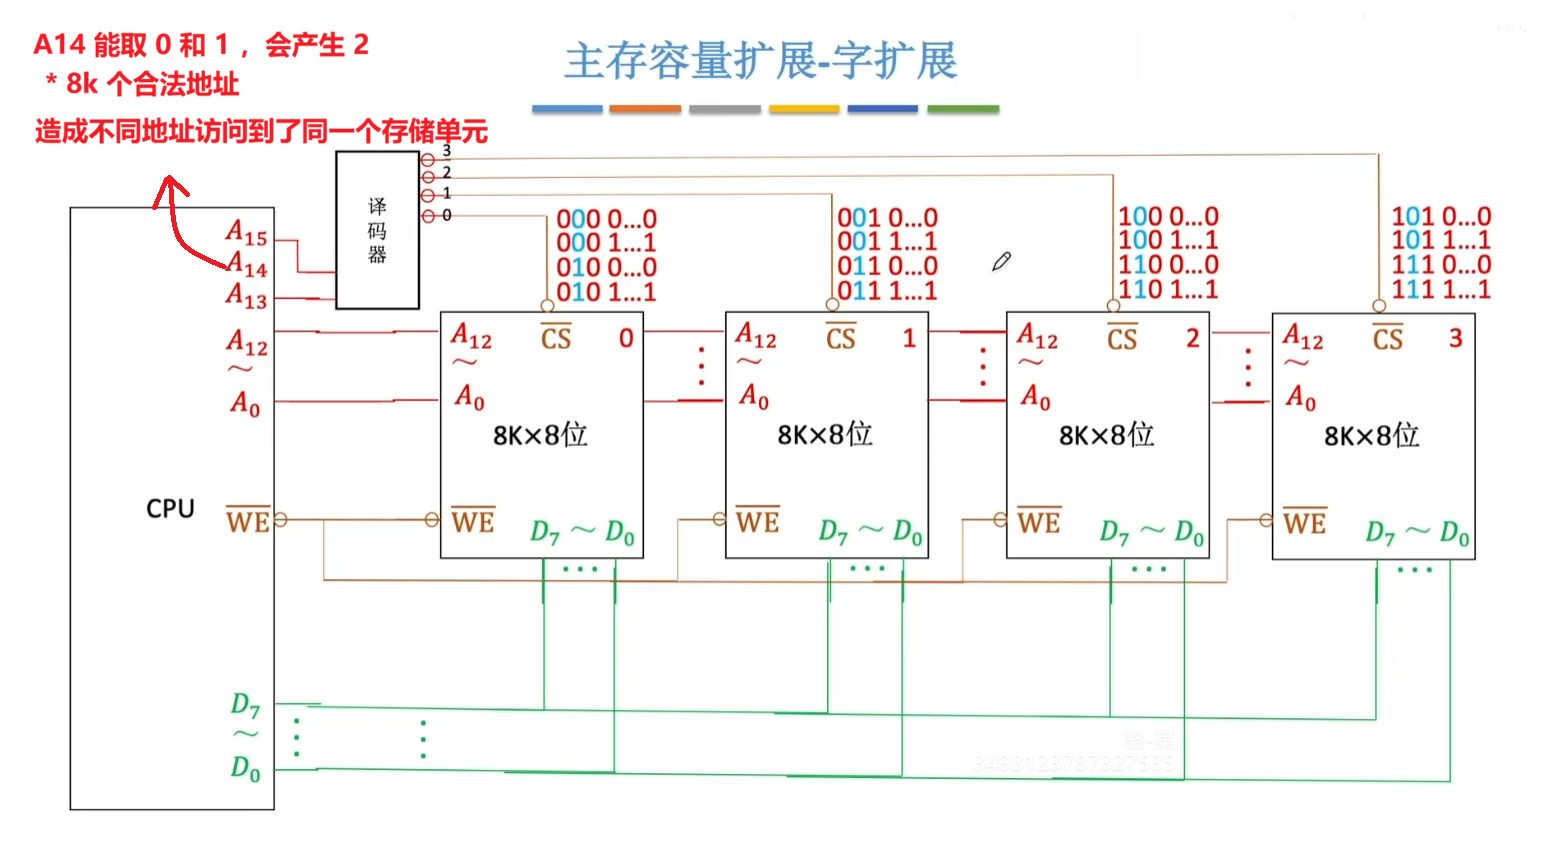
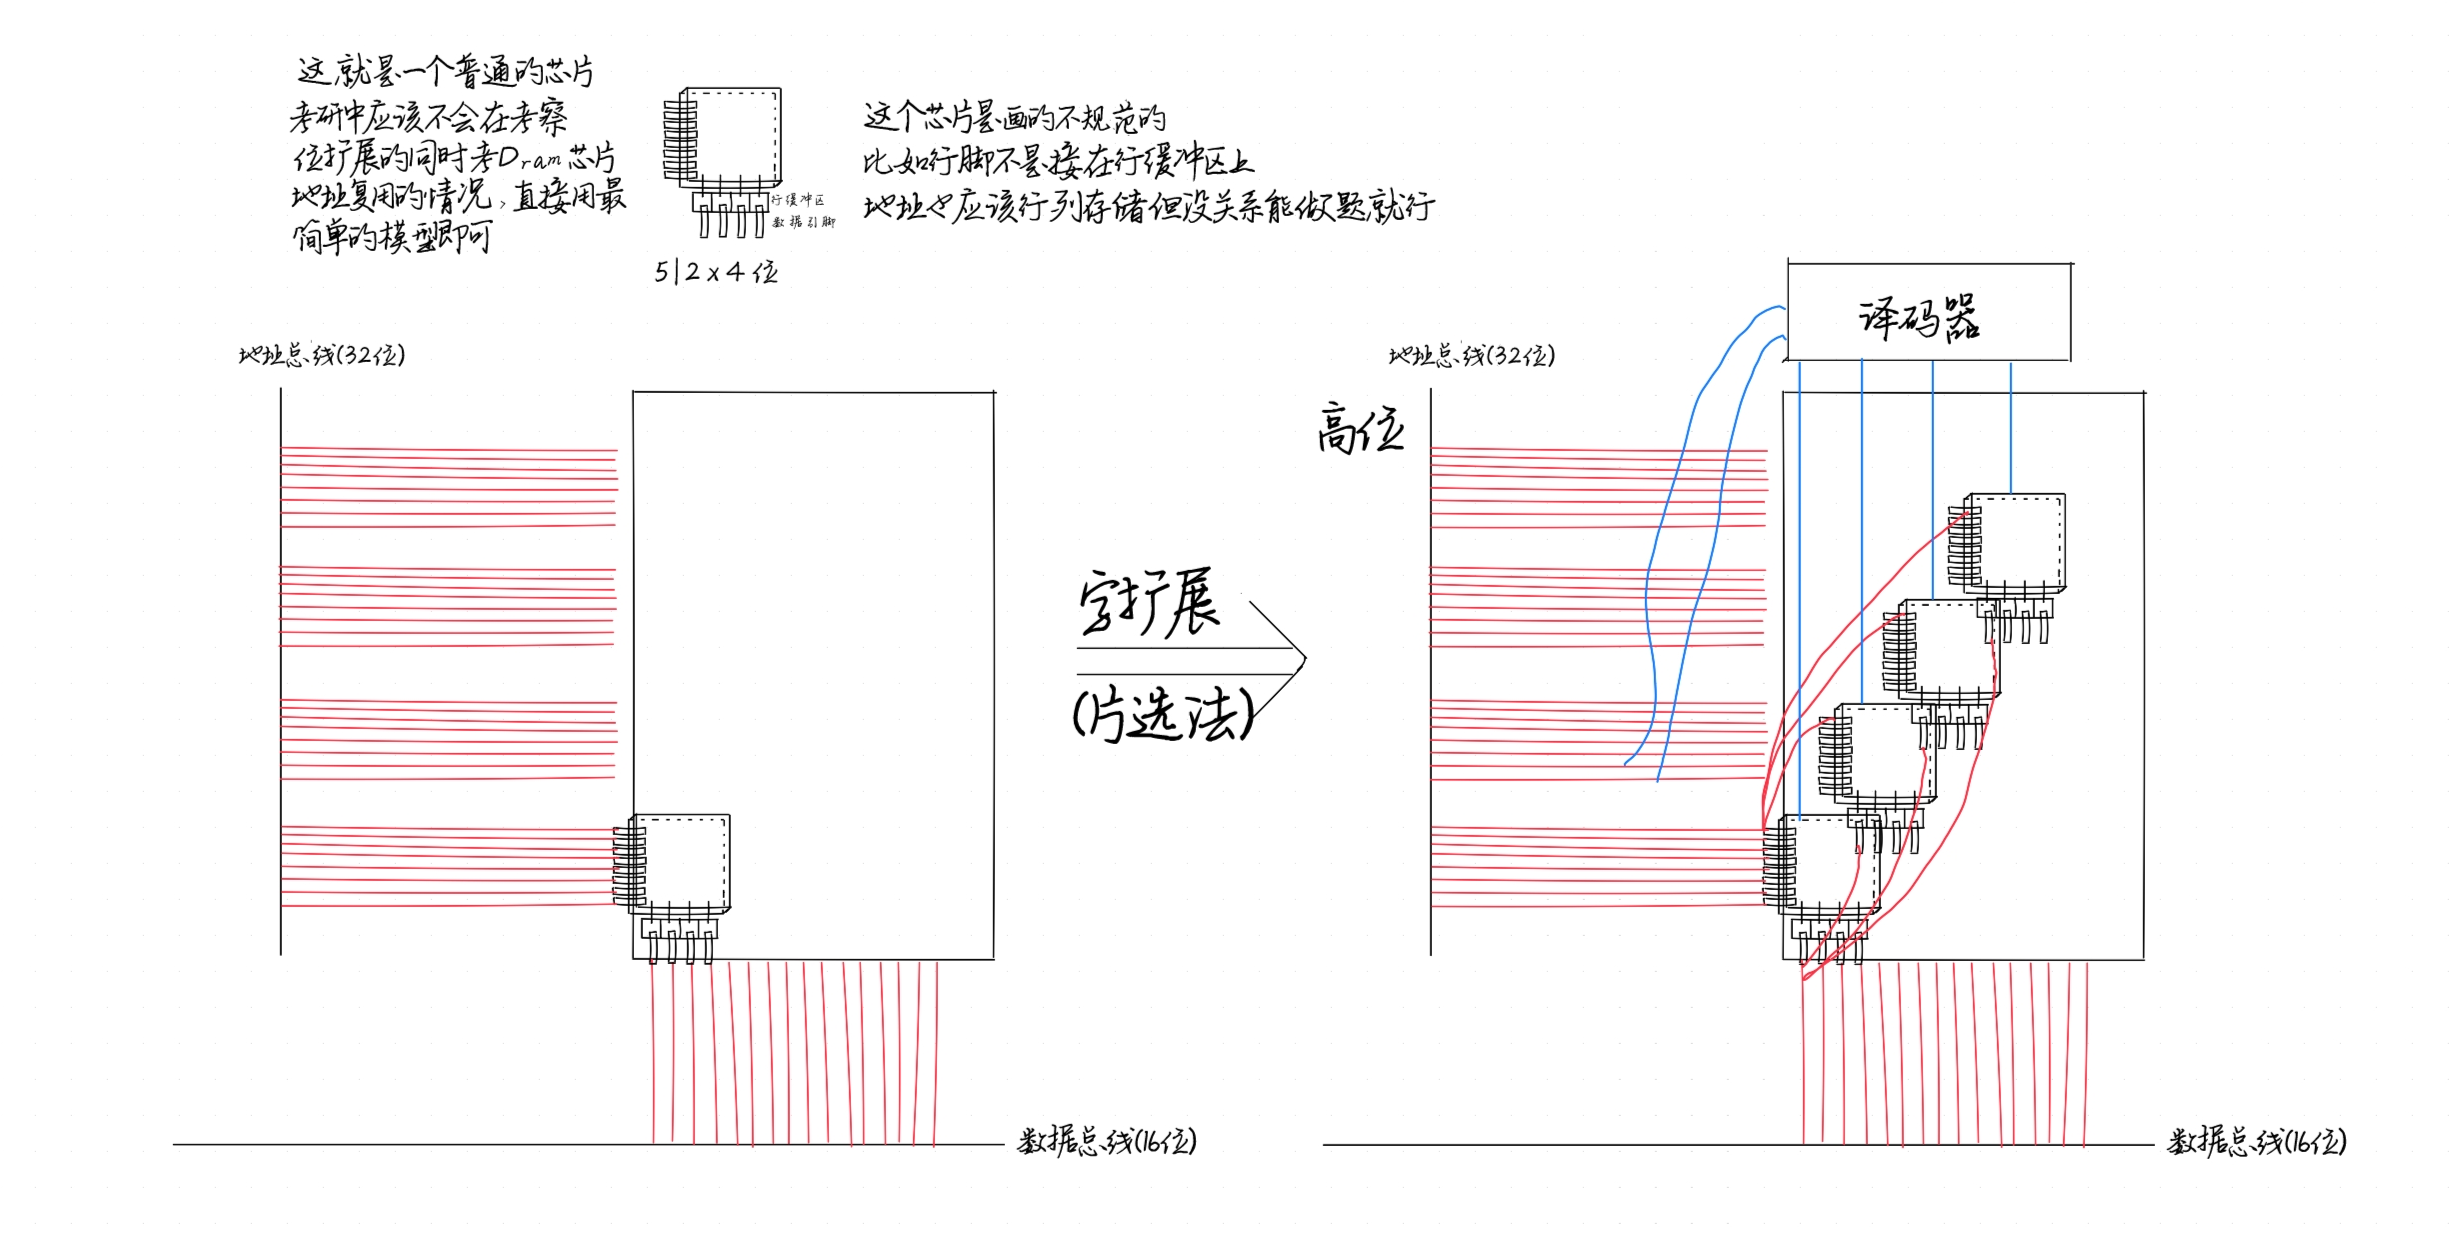 在考研中,我们常常会遇到下面的情况,当然这种在实际中是不会使用的。
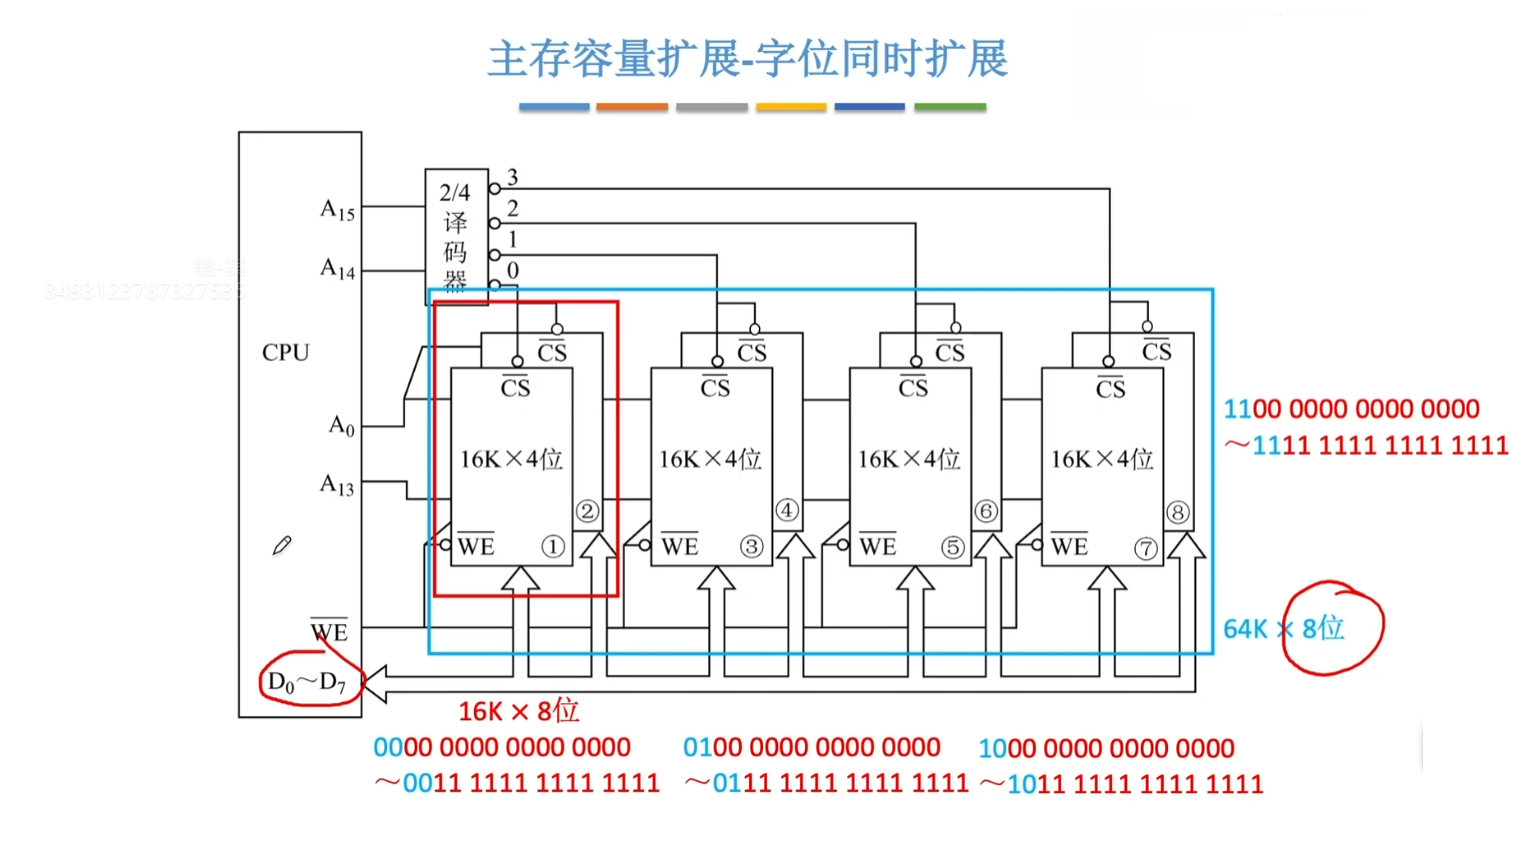
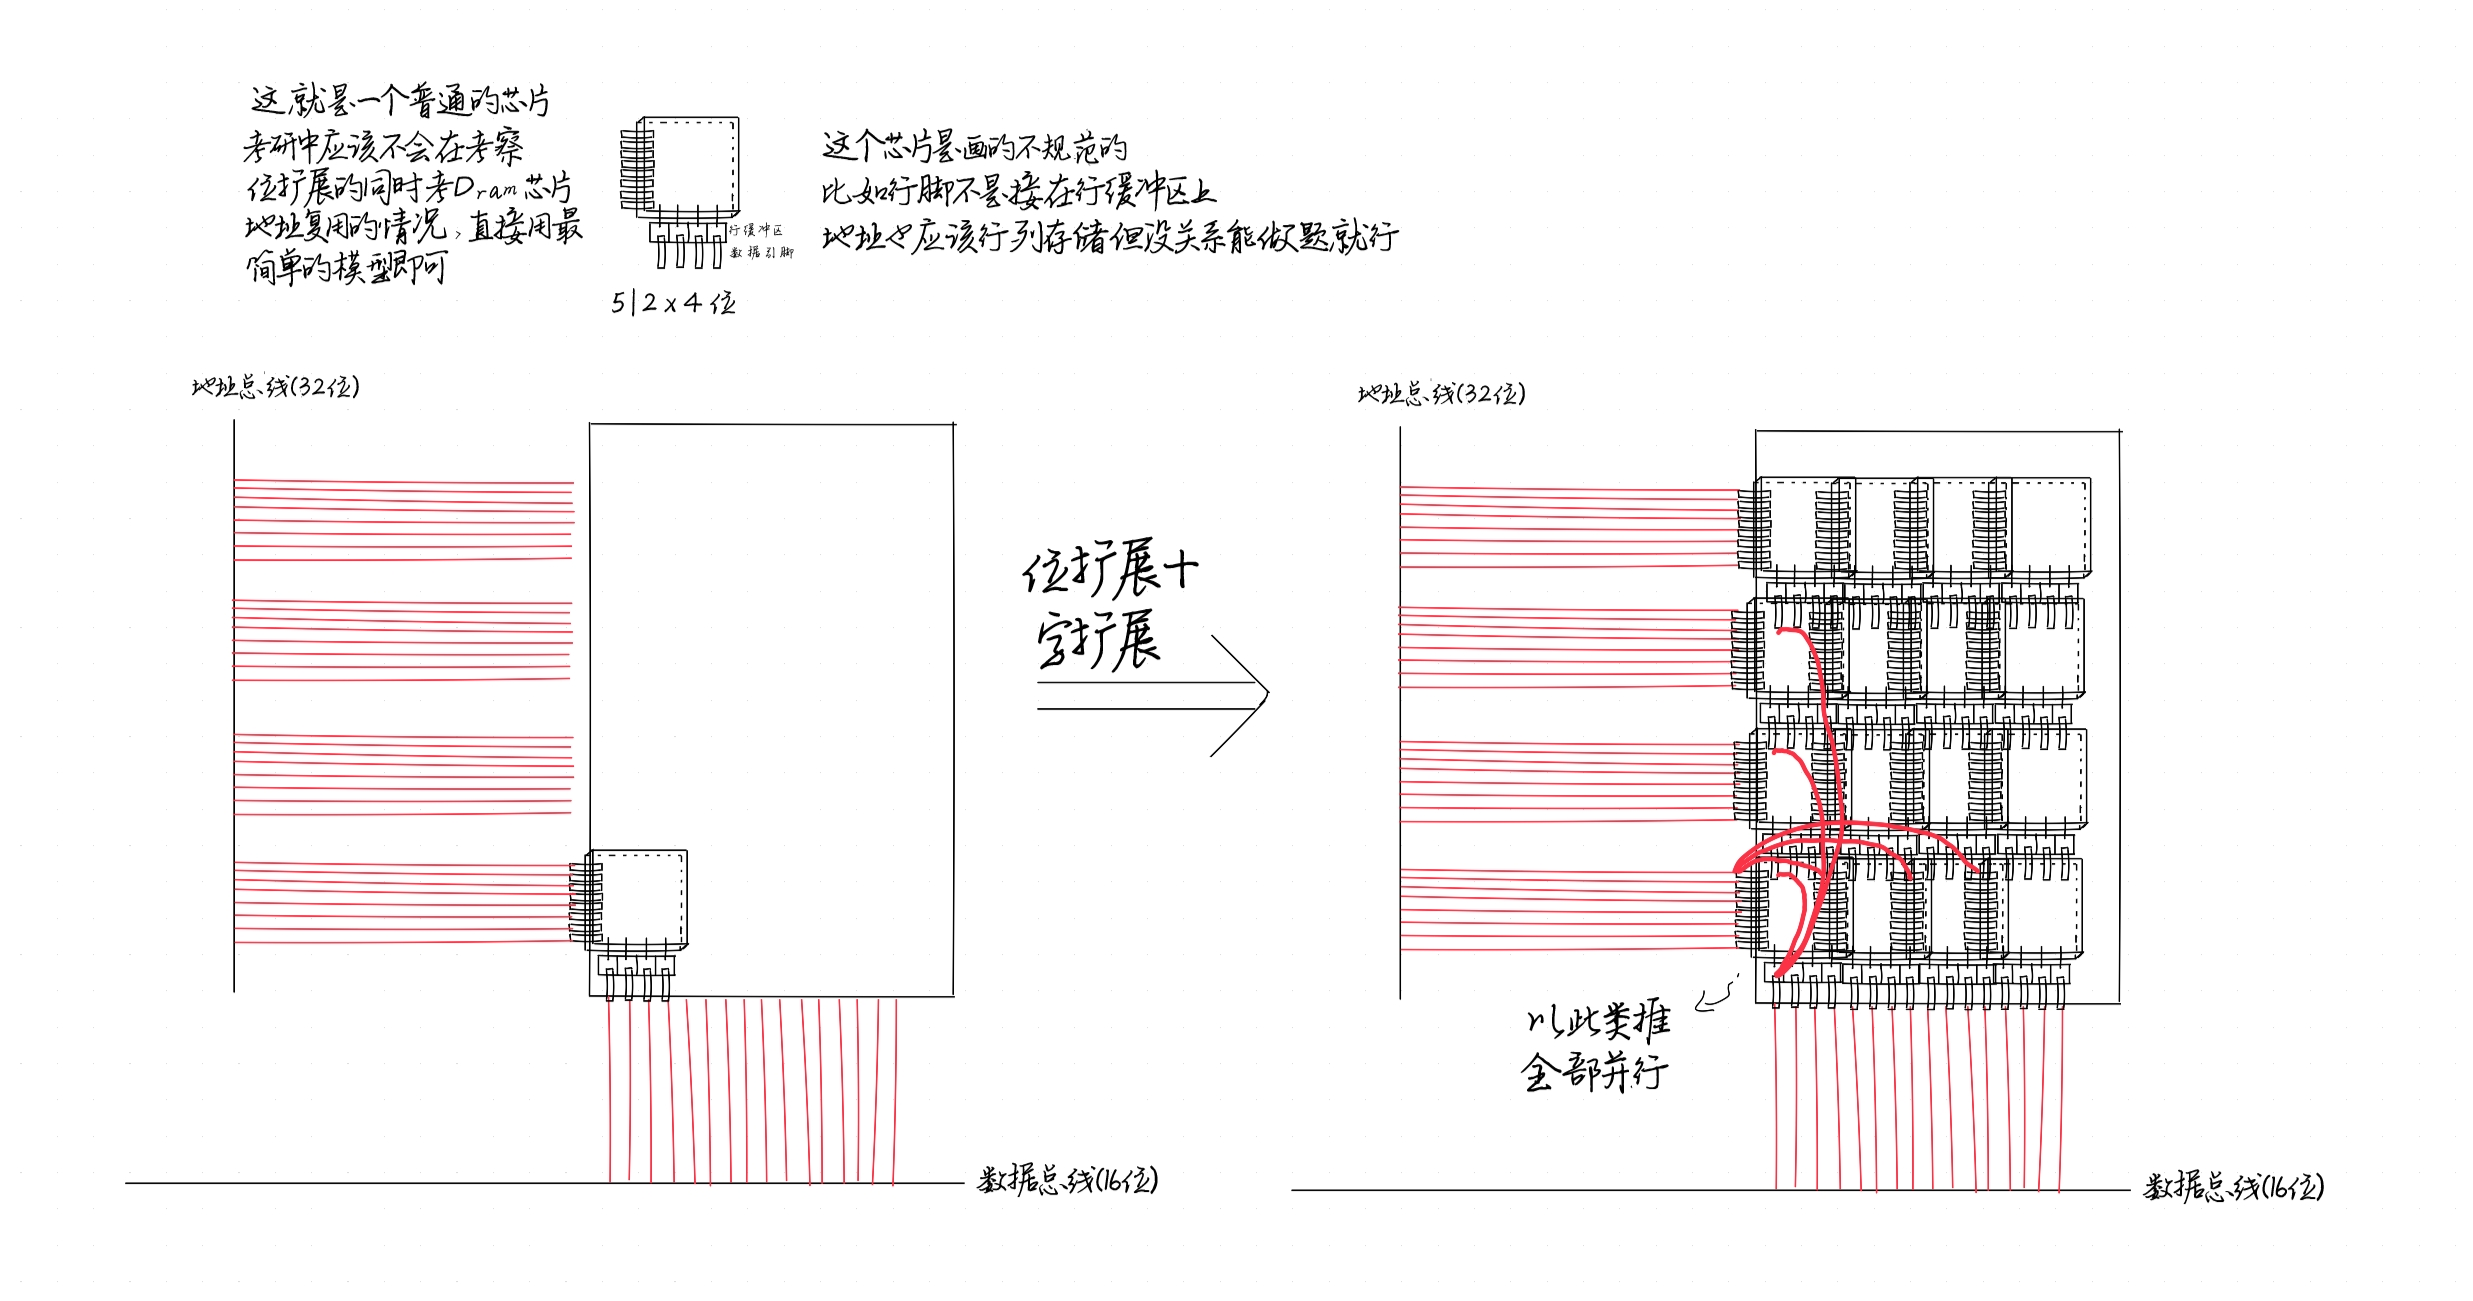
3.3.4 位和字同时扩展
位和字同时扩展如图所示:
3.3.5 译码器(补充)
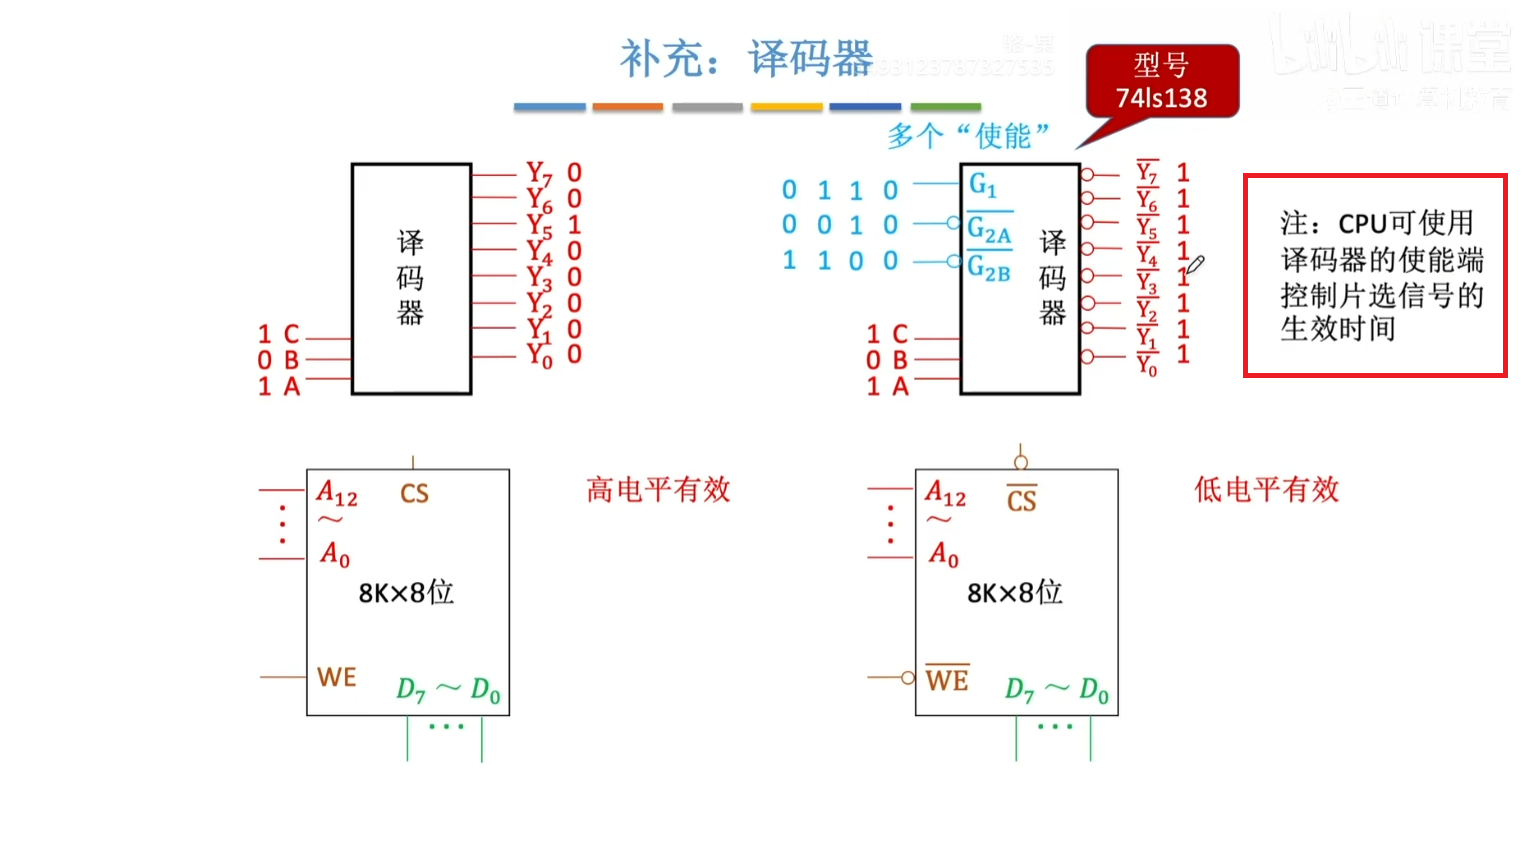
如下图所示:
注意看看译码器的输出端有没有非门,还有多个使能端要全部被满足才能工作。
3.4 外部存储器
计算机的外存储器又称为辅助存储器,目前主要使用磁表面存储器。 所谓“磁表面存储”,是指把某些磁性材料薄薄地涂在金属铝或塑料表面上作为载磁体来存储信息。磁盘存储器、磁带存储器和磁鼓存储器均属于磁表面存储器。
3.4.1 磁盘存储器
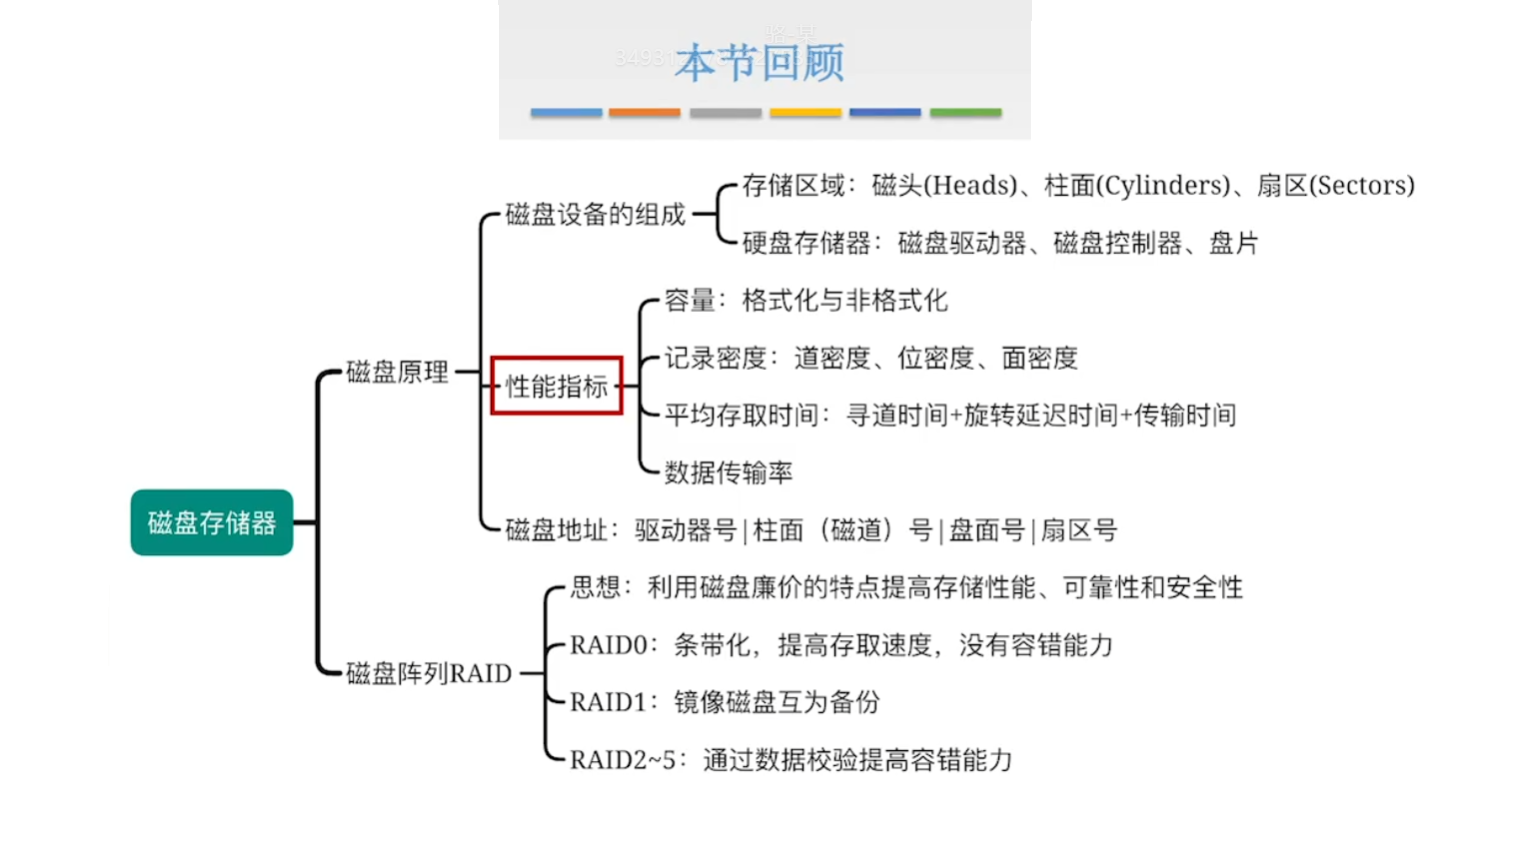
本小节思维导图如下图所示:
3.4.1.1 磁盘设备的组成
如下图所示:
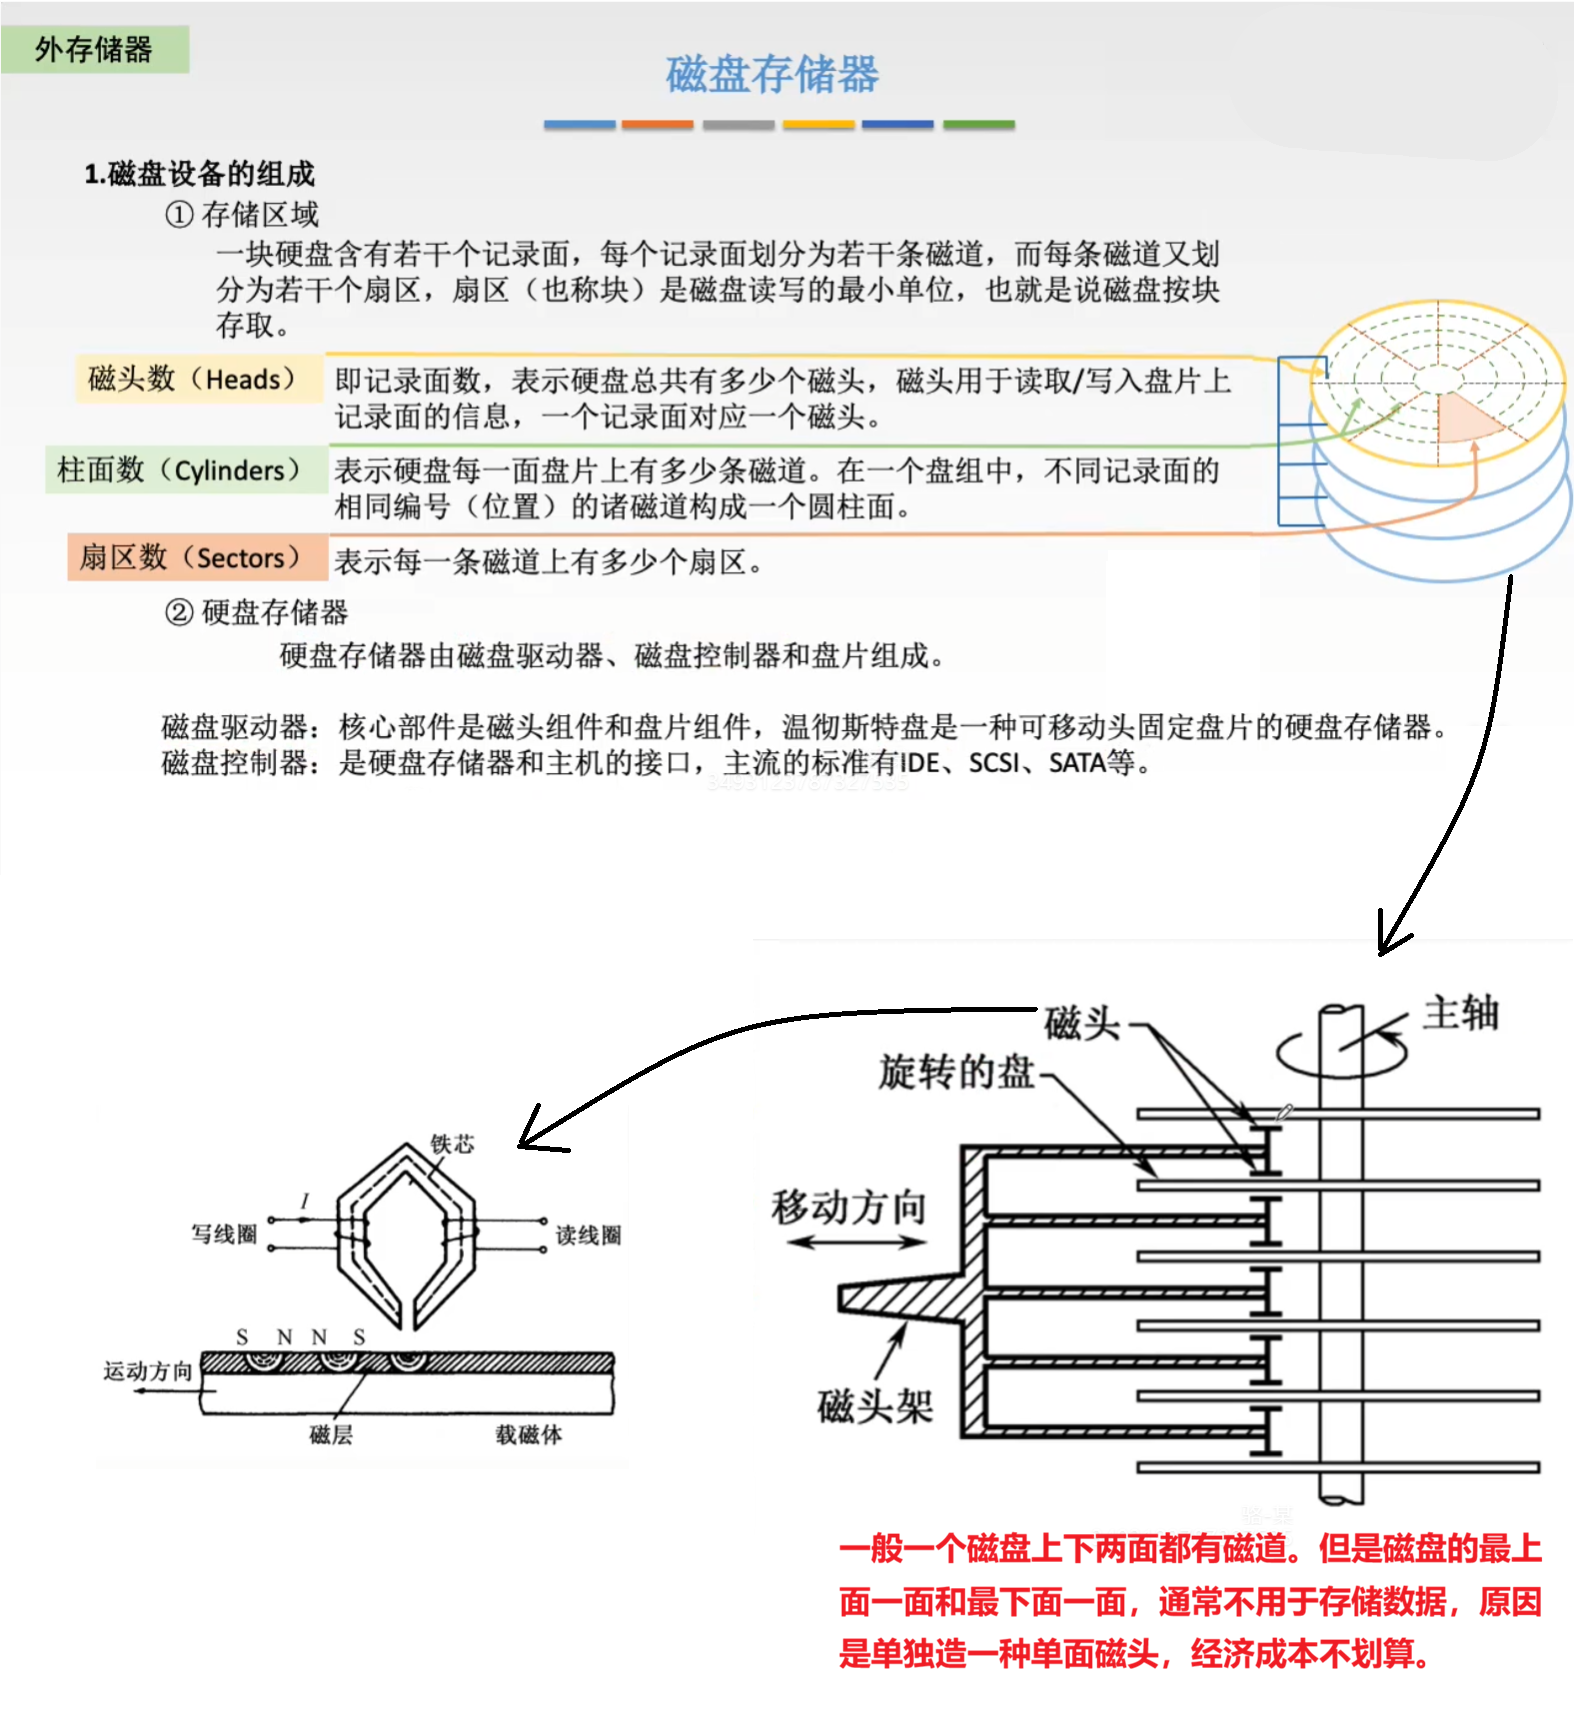 值得注意的是,每个磁盘的上下两面都有盘面,最上面和最下面只是没有磁头!在计算的时候不要乱减!
磁盘的最小读写单位 是 扇区 而不是比特位!
3.4.1.2 磁盘设备的性能指标
如下图所示:
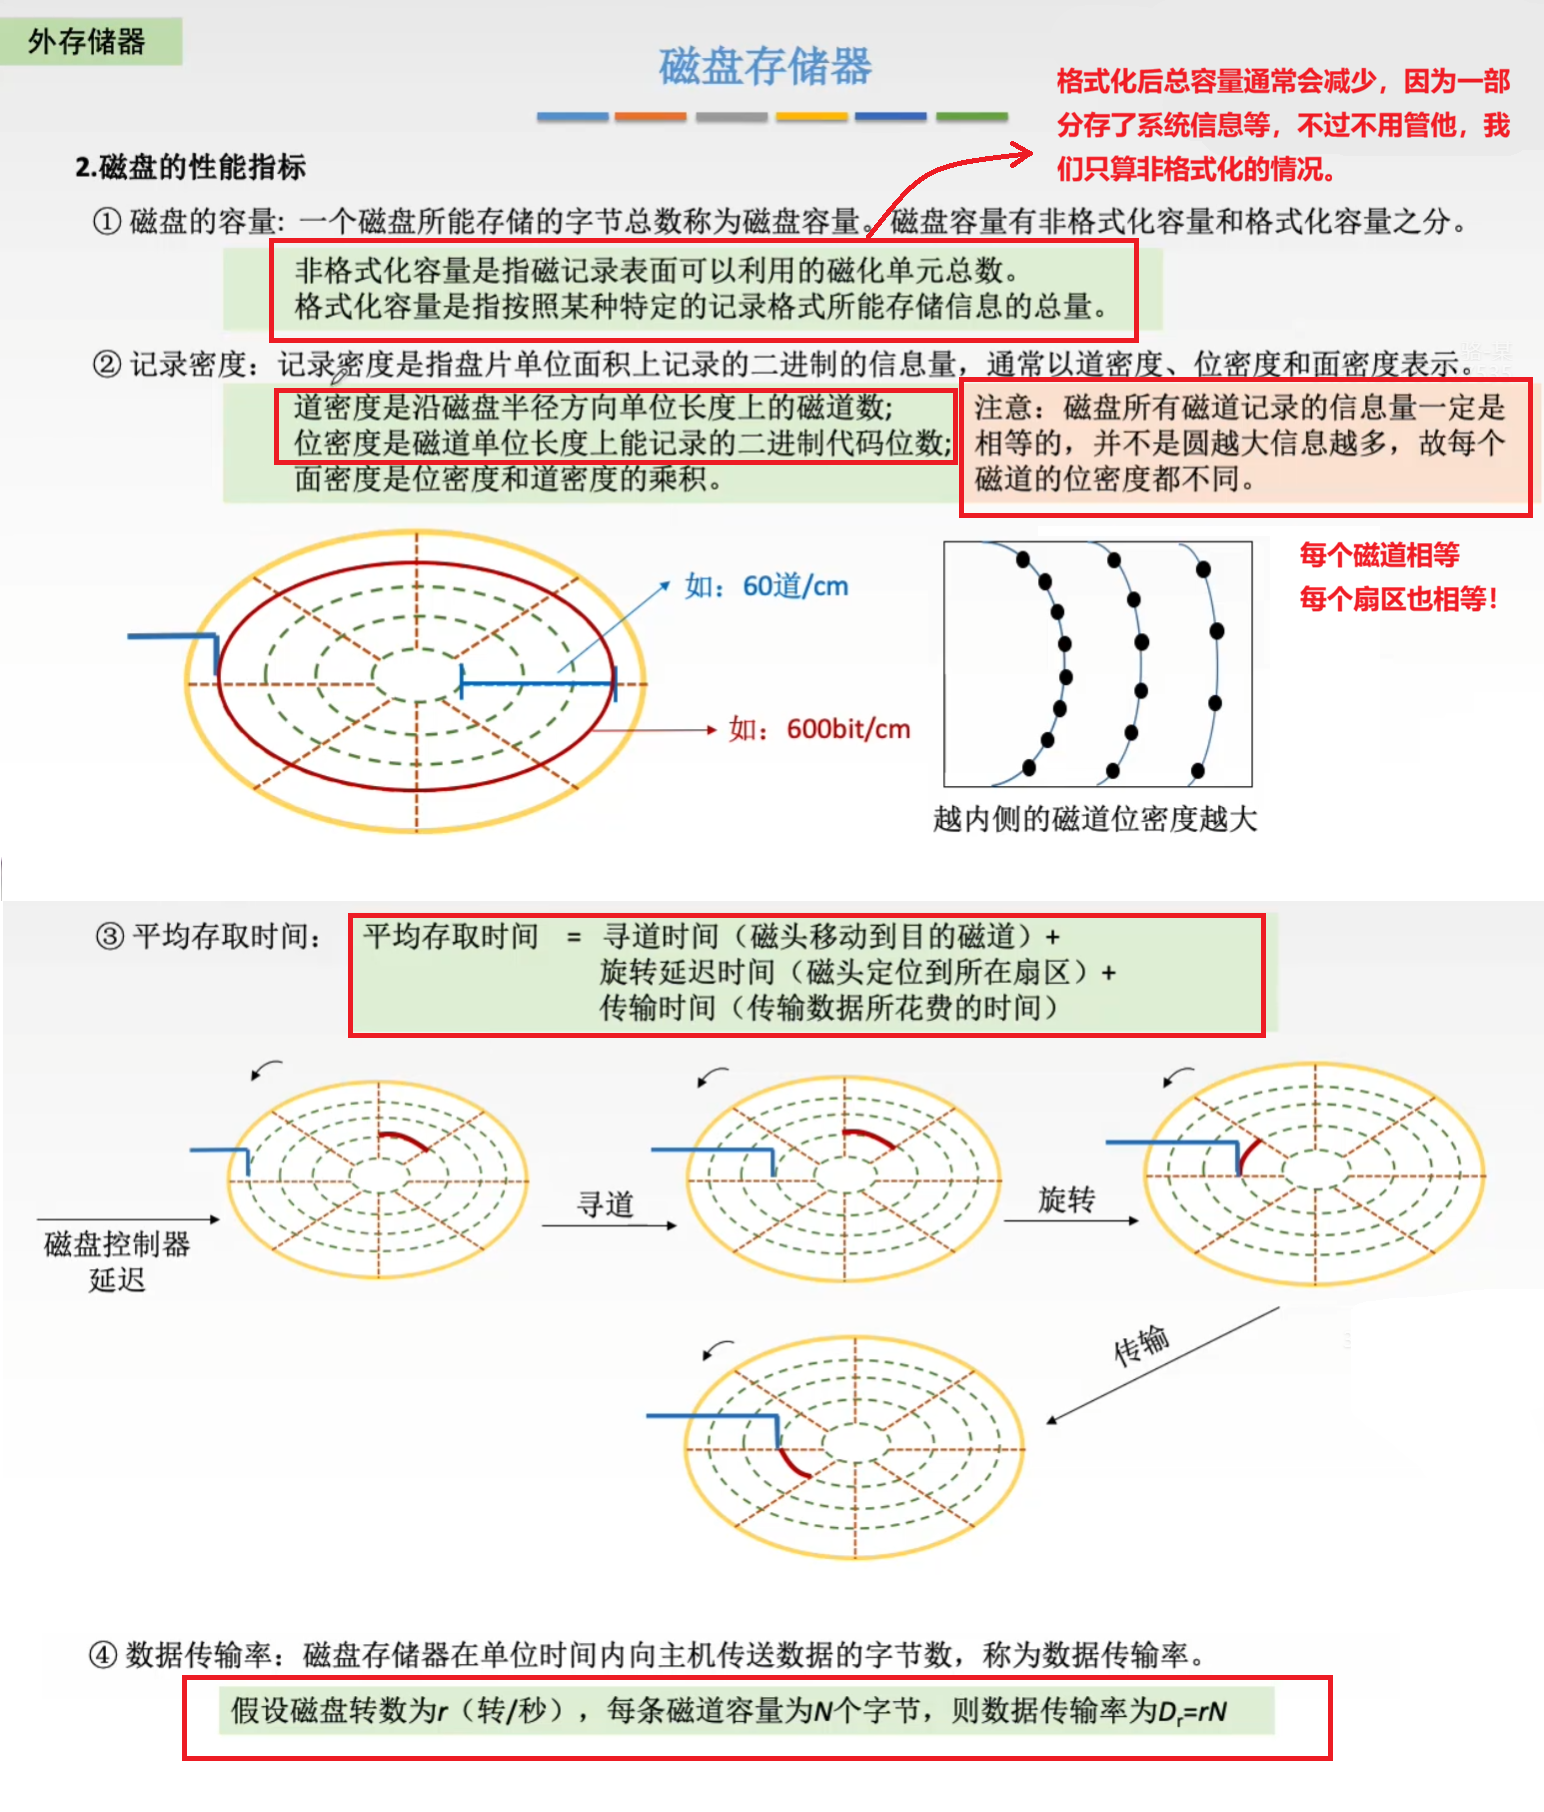 磁盘的响应时间包括:排队时延 + 控制器时延 + 寻道时间 + 旋转等待时间 + 数据传输时间。其中 寻道时间 + 旋转等待时间 + 数据传输时间 又称 存取时间。
平均存取时间 = 平均寻道时间 + 平均旋转等待时间 + 平均数据传输时间
- 平均寻道时间:最大寻道时间的一半(从最外道到最内道时间的 1/2)。
- 平均旋转等待时间:磁盘旋转半周的时间。
- 平均数据传输时间:给了数据传输率就直接算,磁头“扫过需要读取的那一段数据区域”所花的时间。
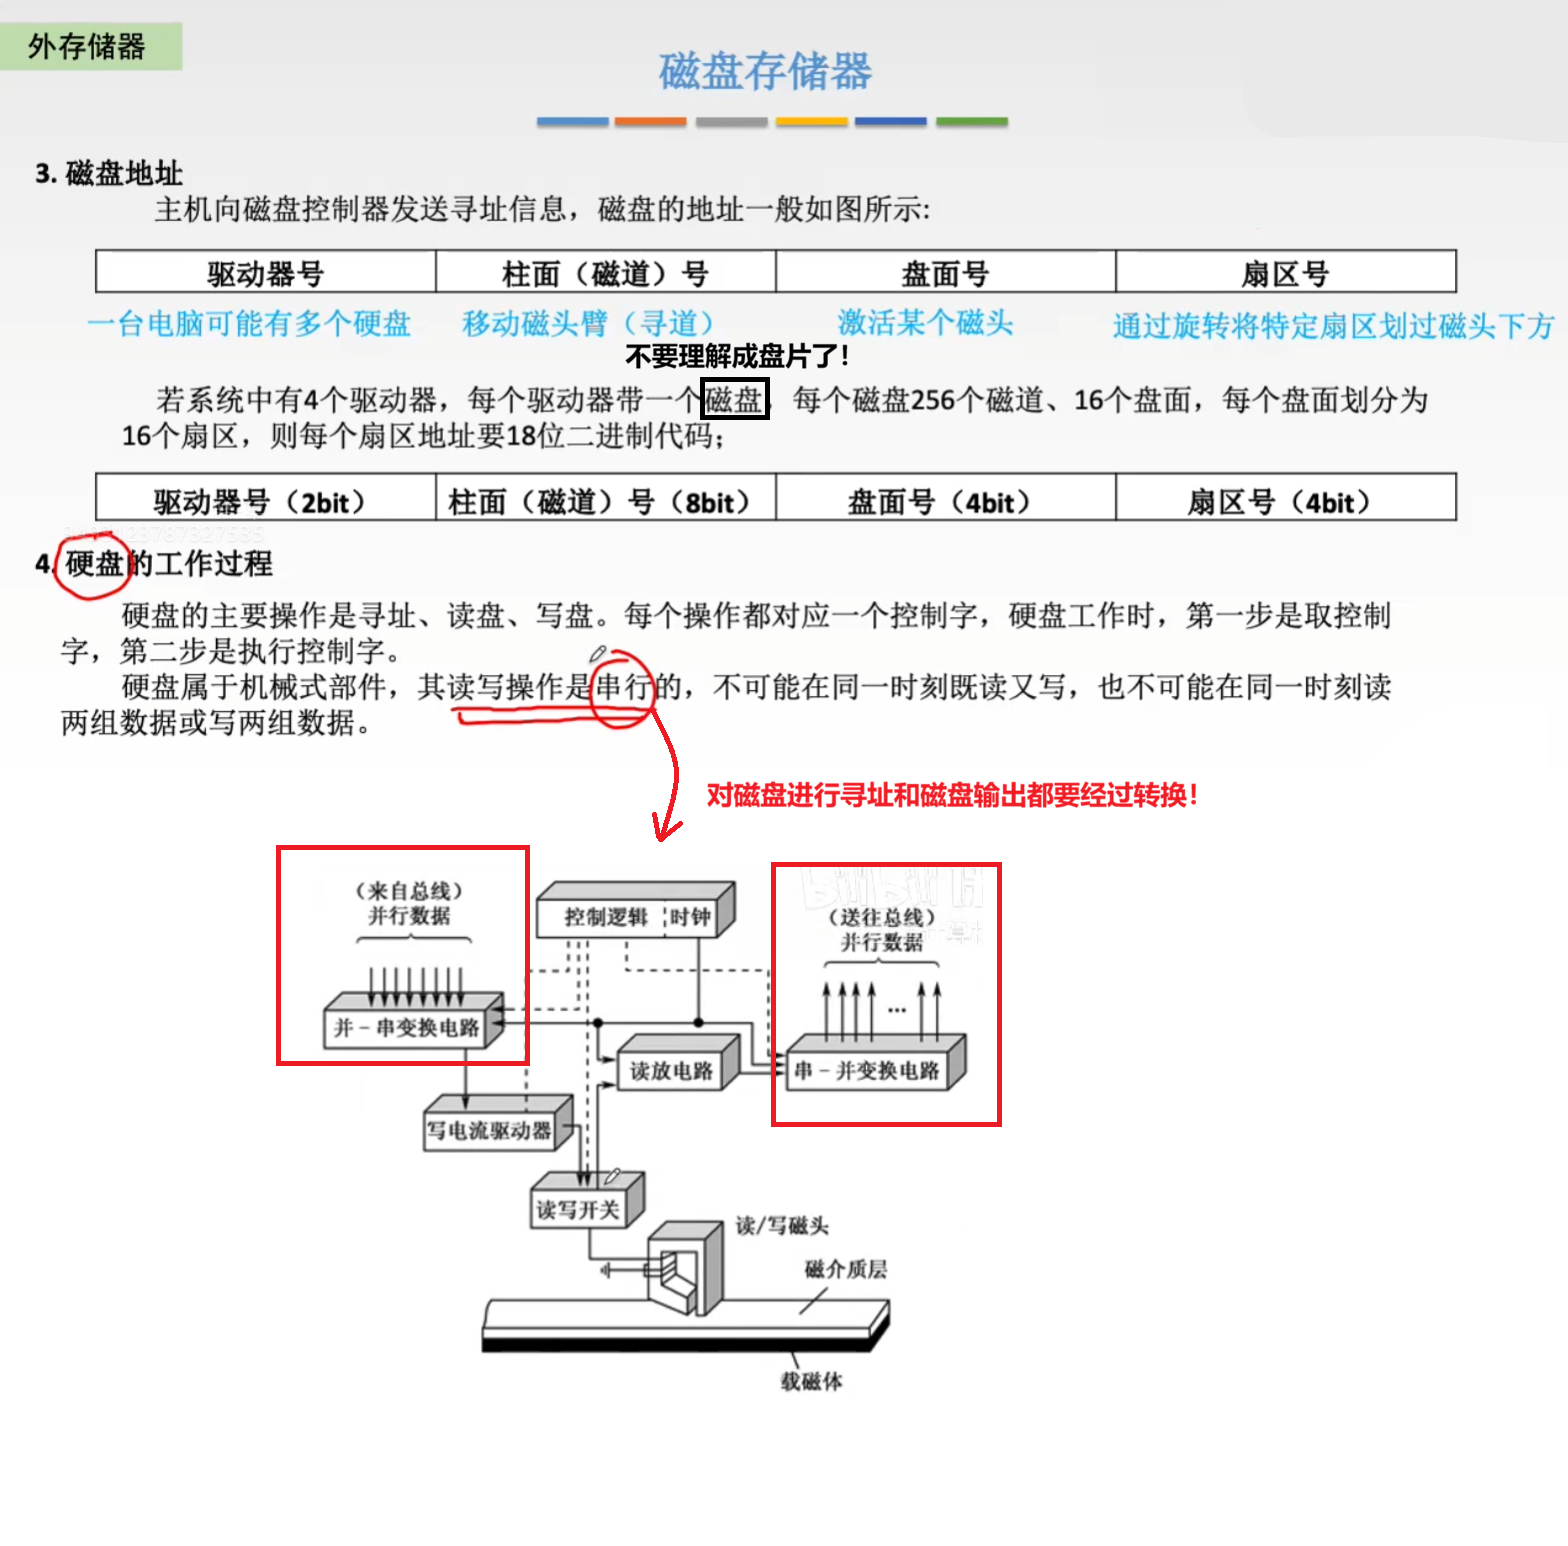
3.4.1.3 磁盘地址
主机向磁盘发送寻址信息,磁盘地址组成如下图所示:
3.4.1.3 磁盘阵列
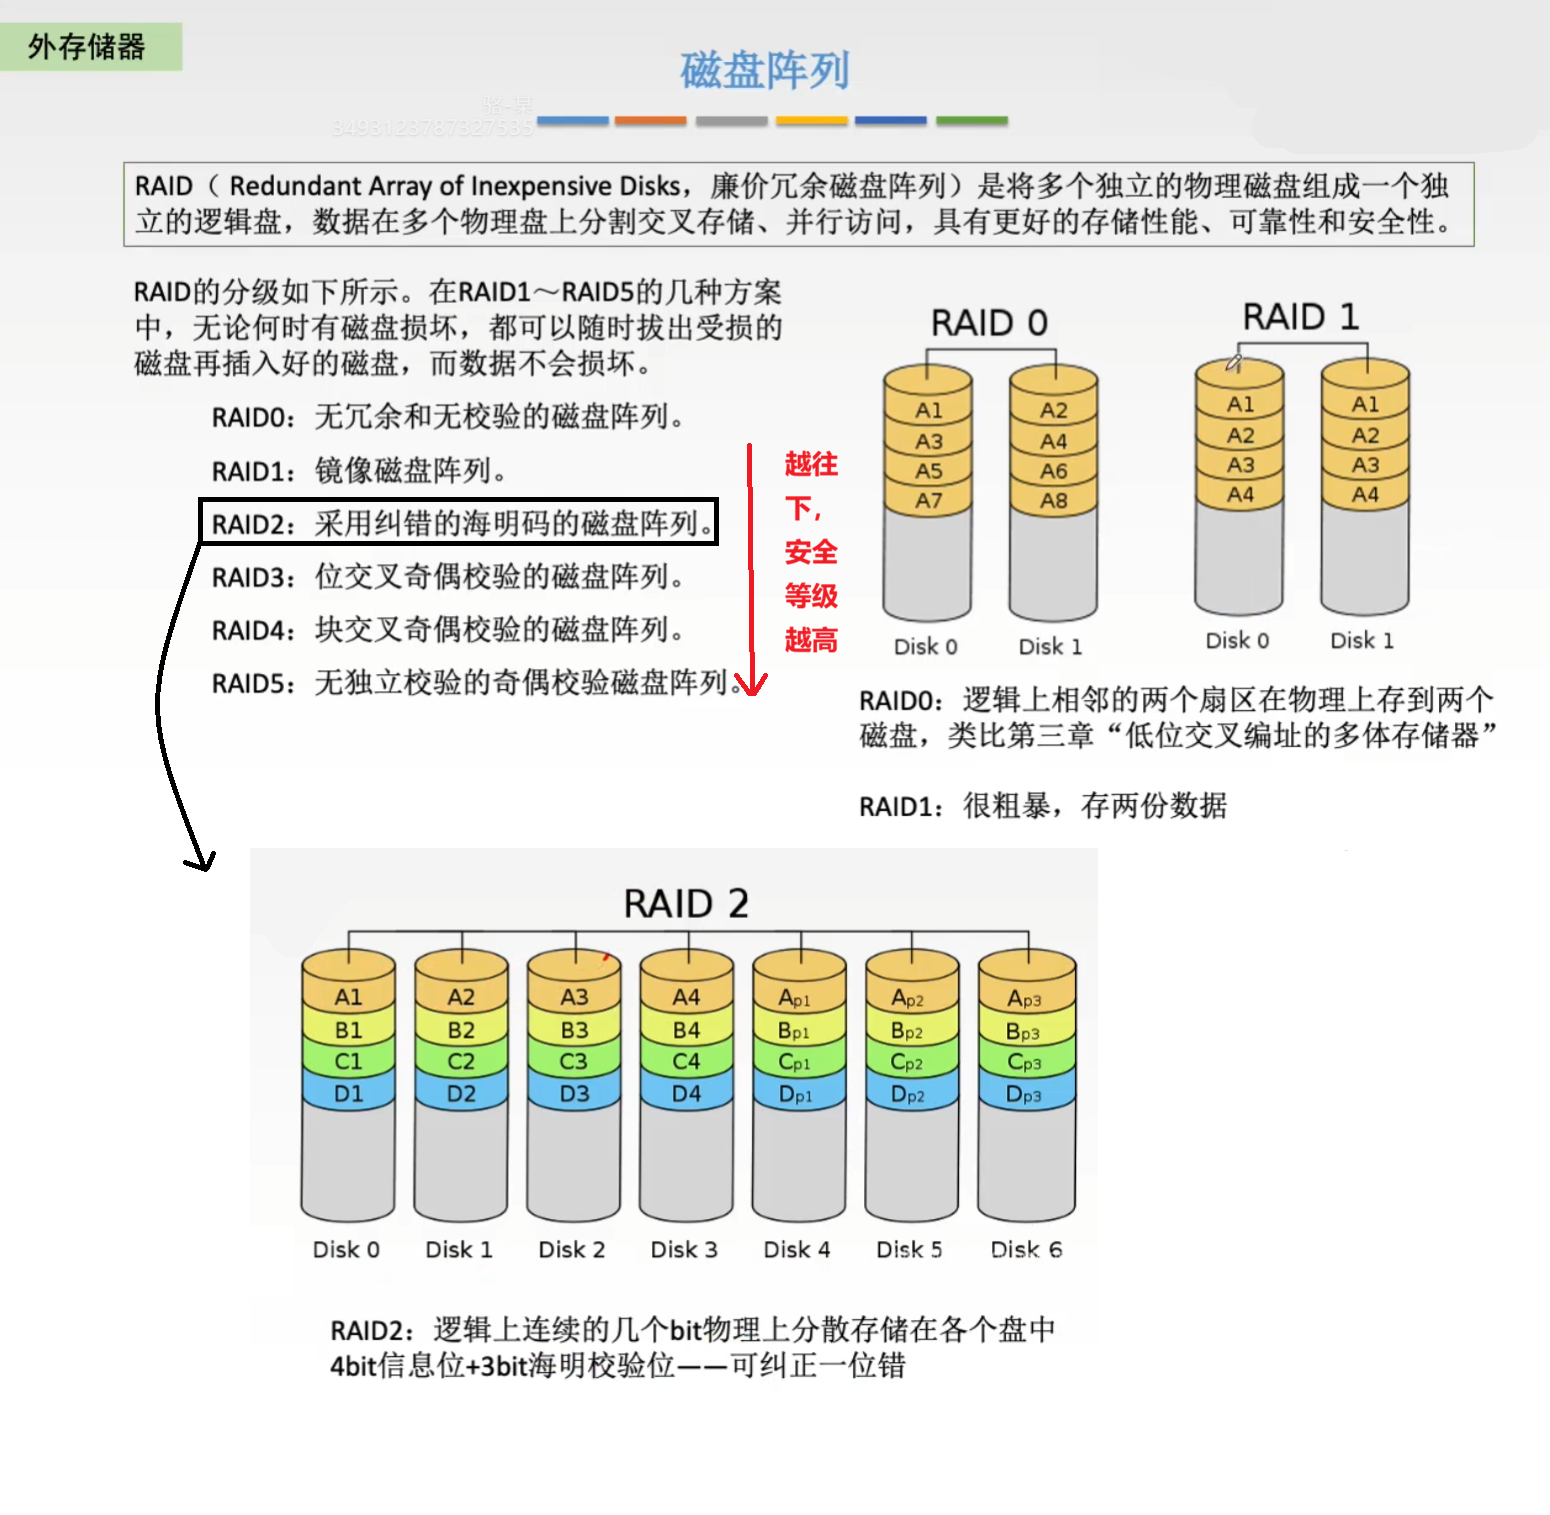
RAID(独立冗余磁盘阵列) 是指将多个独立的物理磁盘组合成一个逻辑磁盘,数据在多个物理盘上交叉分割存储并访问,从而获得更高的存储性能、可靠性与安全性。
RAID 的分级如下图所示,考研只需要详细了解前三个等级即可:
3.4.2 固态硬盘
本小节思维导图如下:
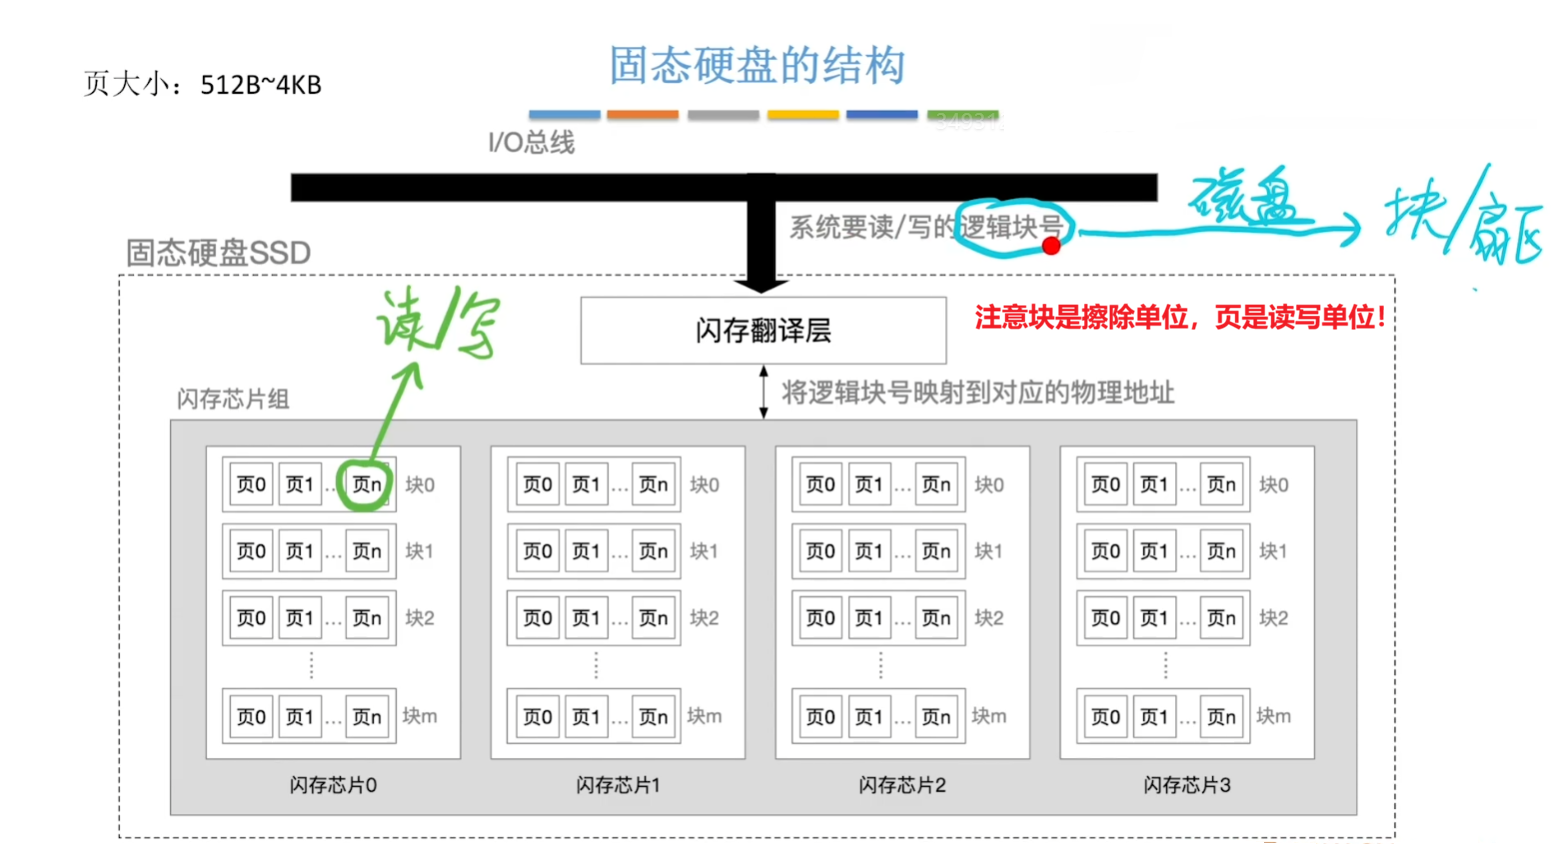
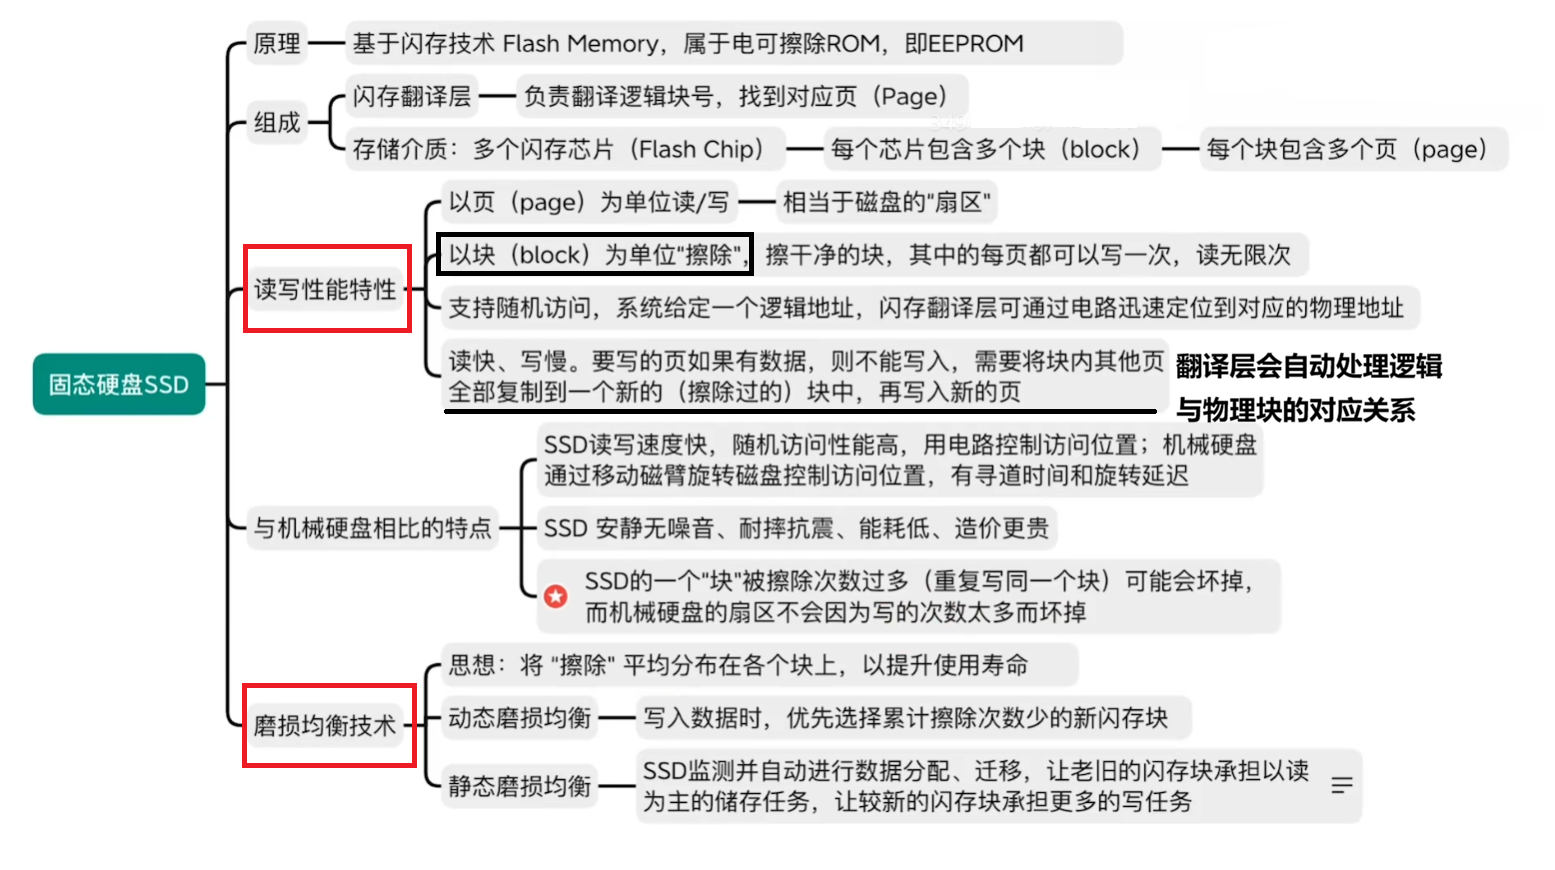 固态硬盘(SSD)是一种基于闪存技术(前面讲过的 ROM)的存储设备。其存储介质与 U 盘 类似,但容量更大,存储性能更优。
而固态硬盘具体长下面这个样子,由于 “块、页” 等术语经常会在 408 中的不同地方出现,注意进行区分,可以把块看成磁盘中的磁道,页看成磁道对应的扇区。
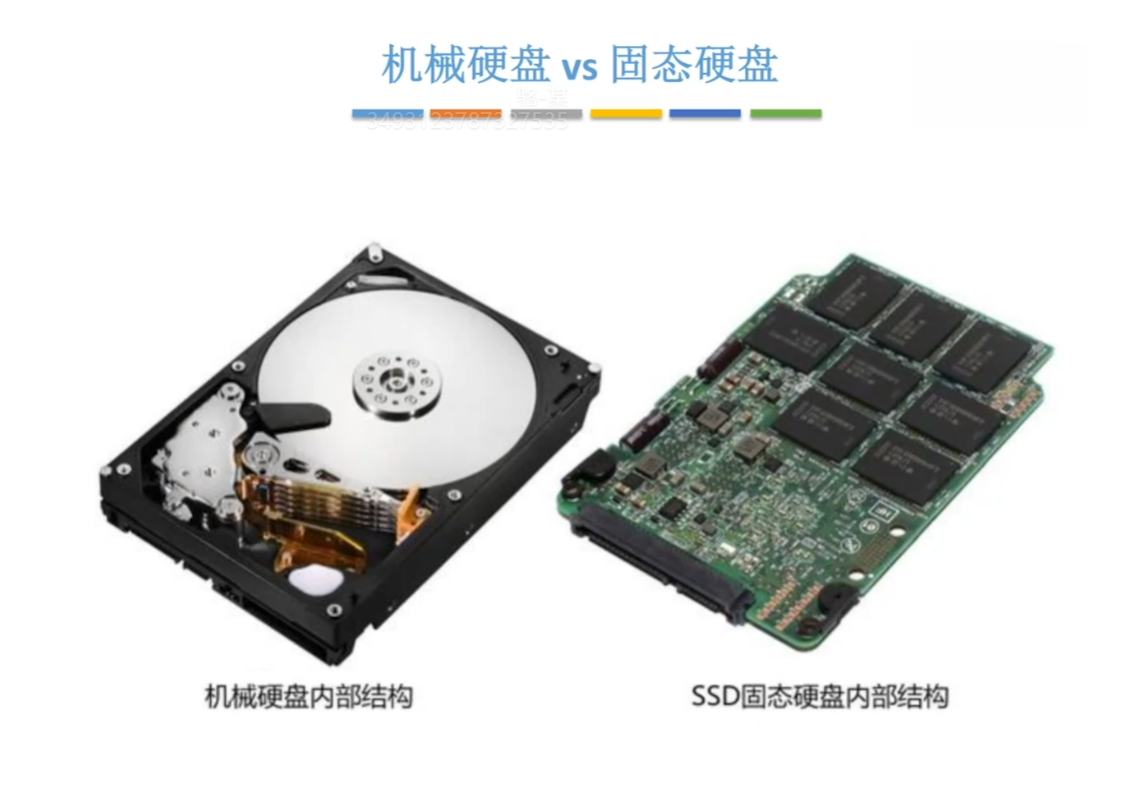
 最后放个图,机械硬盘(磁盘)和固态硬盘的真实样子:
3.5 高速缓存存储器
3.5.1 Cache 工作的基本原理
高速缓存用于缓解 CPU 与主存之间的速度不匹配,通过利用程序的局部性原理,提高存储访问效率。至于为什么不将主存全部替换成高速缓存,当然是因为成本问题。
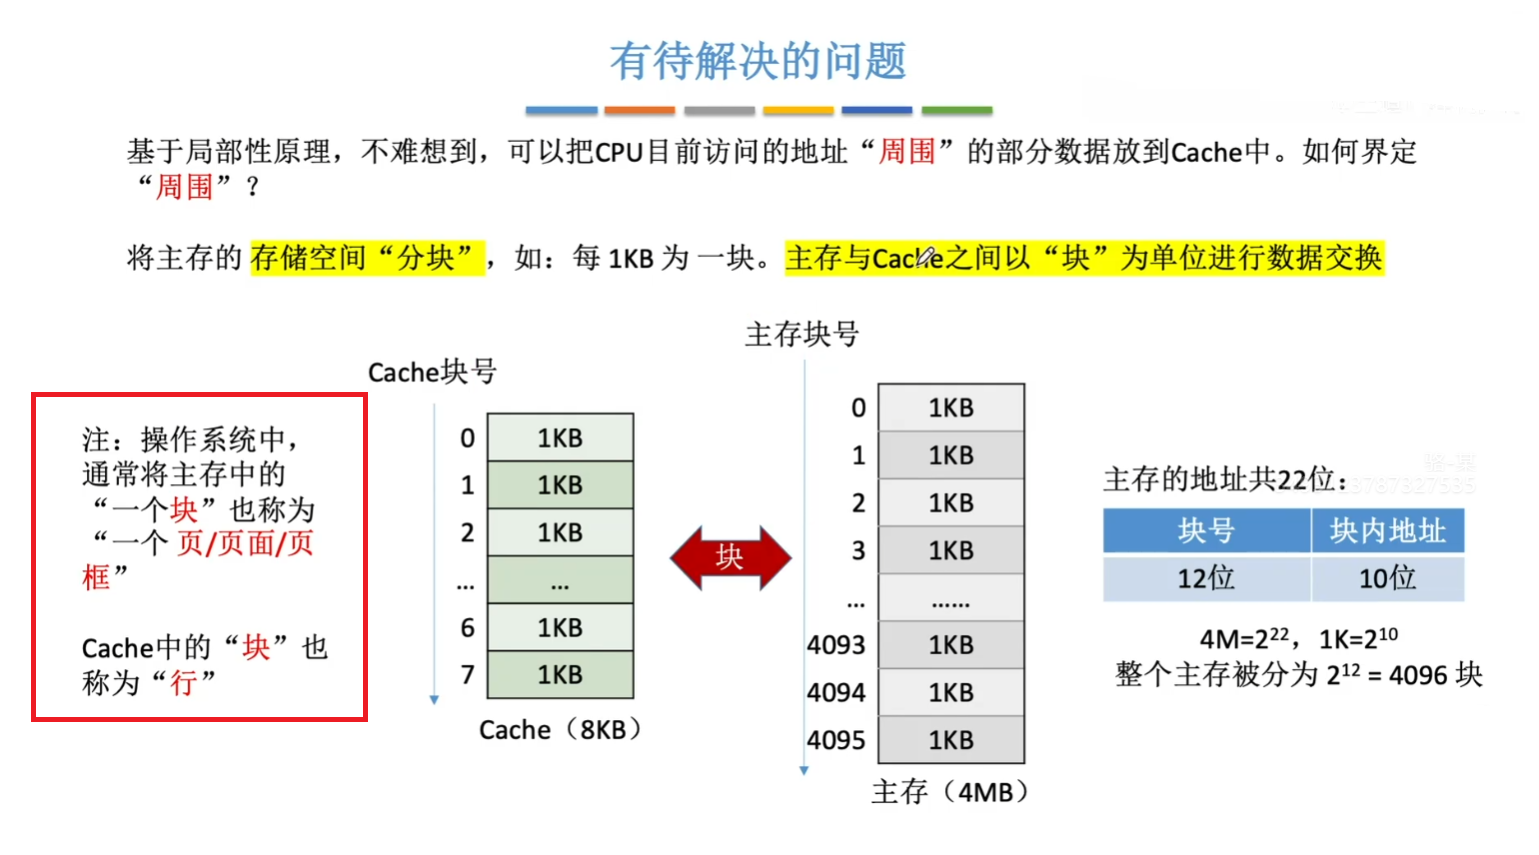
为了方便 Cache 和 主存之间交换信息,Cache 和 主存都被划分为大小相同的块。注意,在操作系统和计算机组成原理两门课中,有很多地方有 “块、行、页” 等的称呼,注意区分:
3.5.1.1 局部性原理
这样引出一个疑问,哪些东西会提前放到 Cache 里?首先需要引入局部性原理的概念,如下图所示:
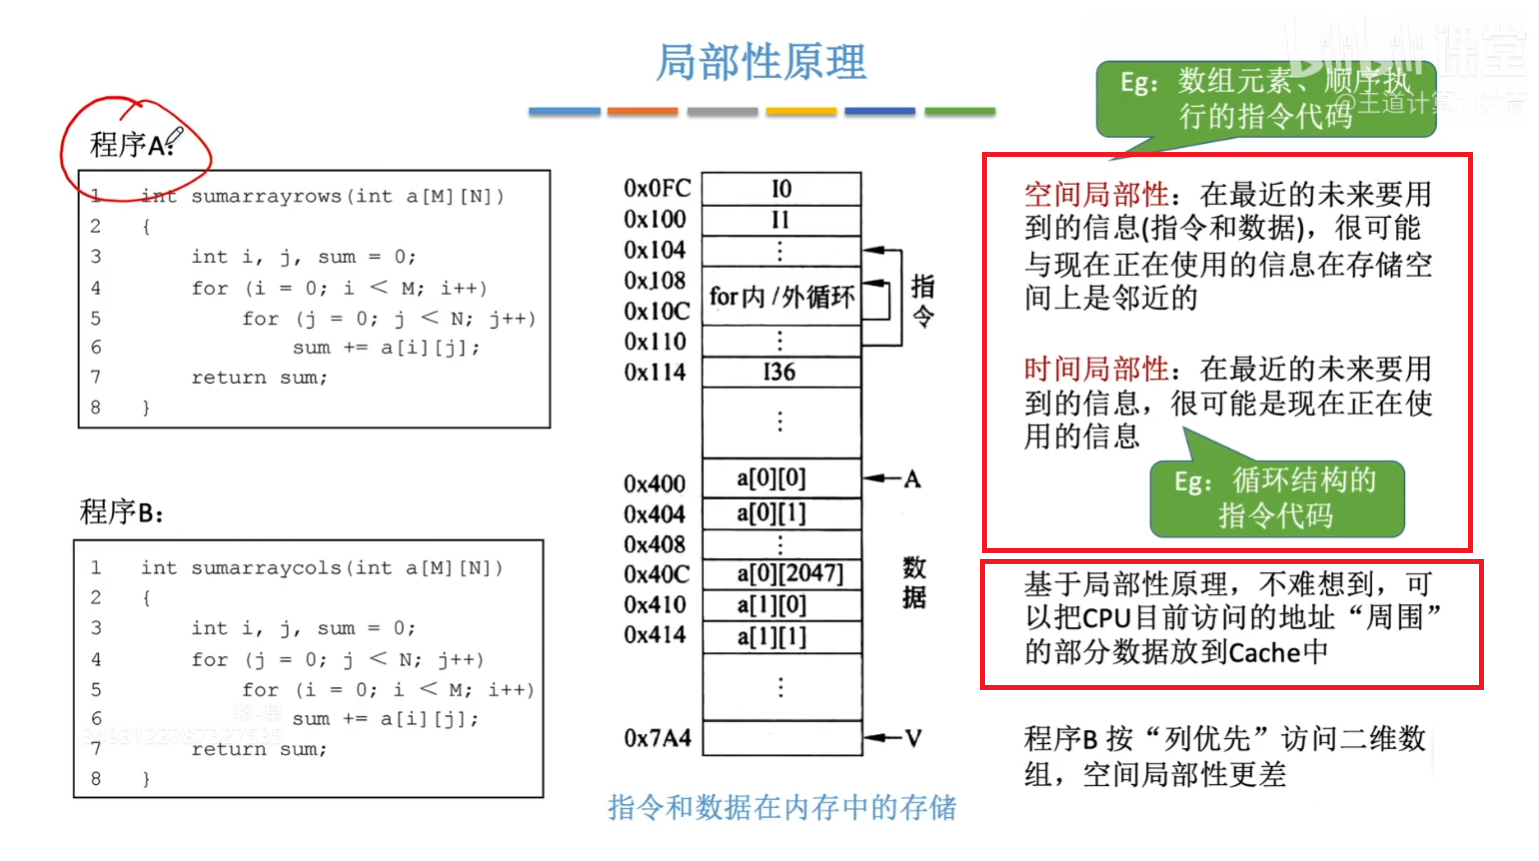 时间局部性指一个内存位置被重复引用,空间局部性是指若一个内存位置被引用,则他附近的位置也会很快被引用。
3.5.1.2 性能分析
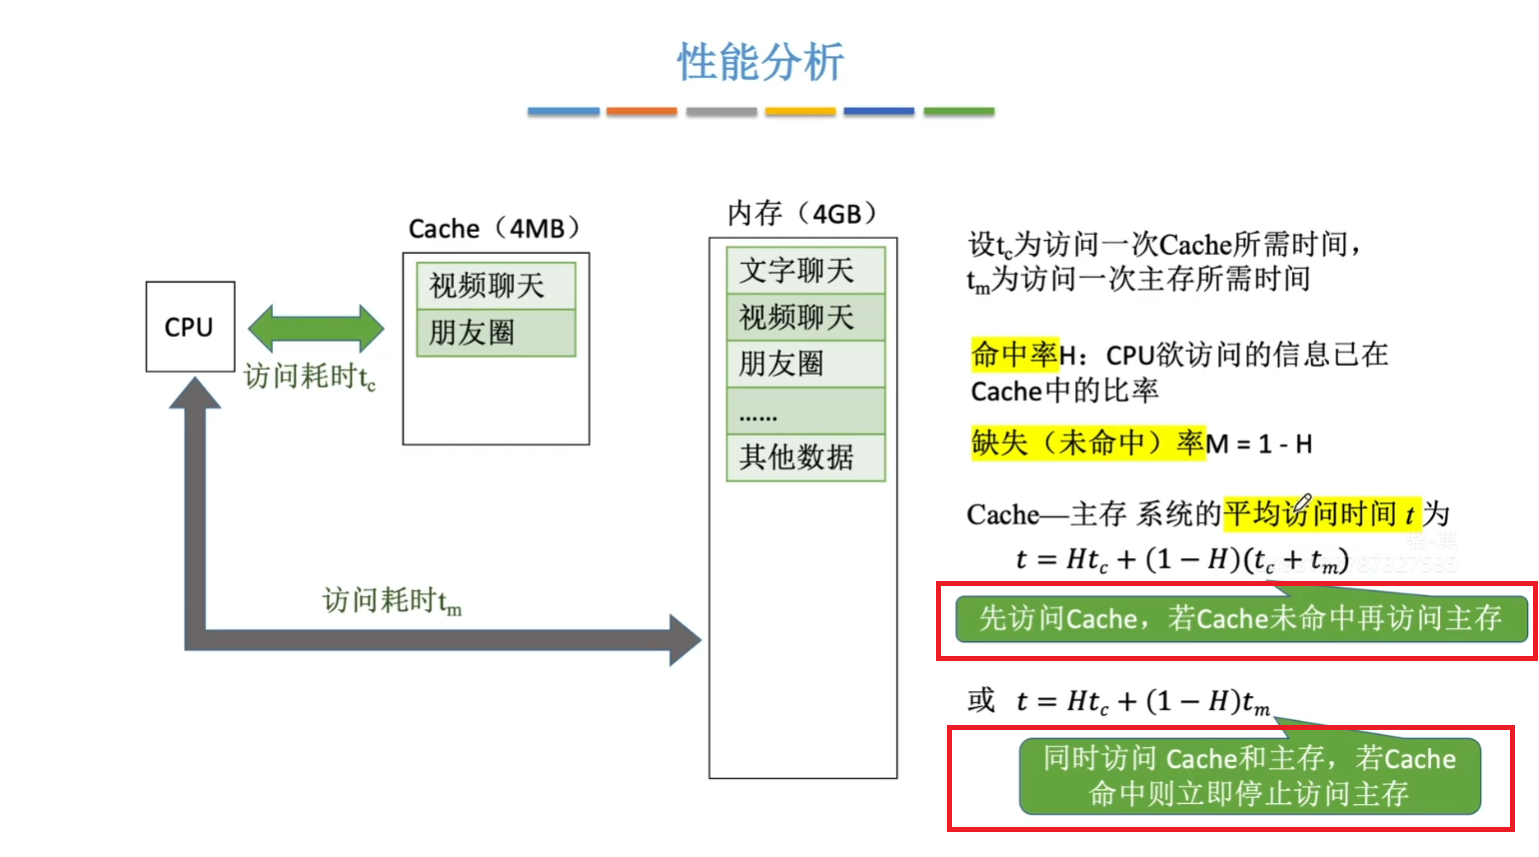
CPU 所需访问的信息已在 Cache 中的概率被称为 Cache 命中率,而访问 Cache 和主存的方式分为两种,假定 Cache 命中率为 h,则这种方式的访问平均时间为:
- 先访问 Cache,未命中再访问主存:
$$ T=hT_{\text{访问Cache}}+(1-h)\left(T_{\text{访问Cache}}+T_{\text{访问主存}}\right) $$
$$ =T_{\text{访问Cache}}+(1-h)T_{\text{访问主存}} $$
- 同时访问 Cache 和主存:
$$ T=hT_{\text{访问Cache}}+(1-h)T_{\text{访问主存}} $$
如下图所示:
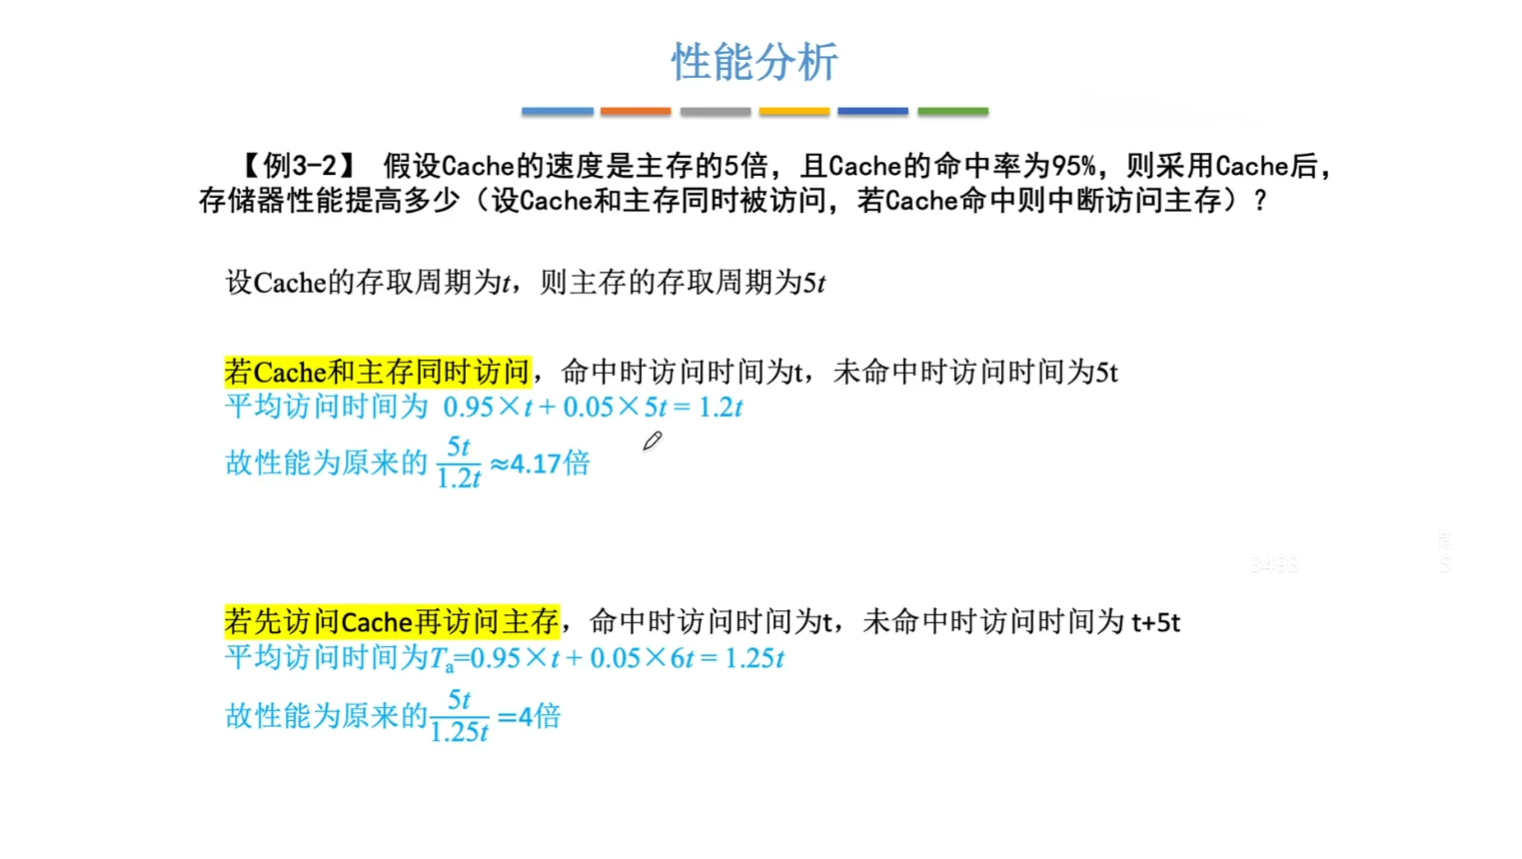
 这两种方式的计算在考研中经常会考察,以一个简单的题目为例说明:
3.5.2 Cache 和主存的映射方式
本小节思维导图及总览如下:
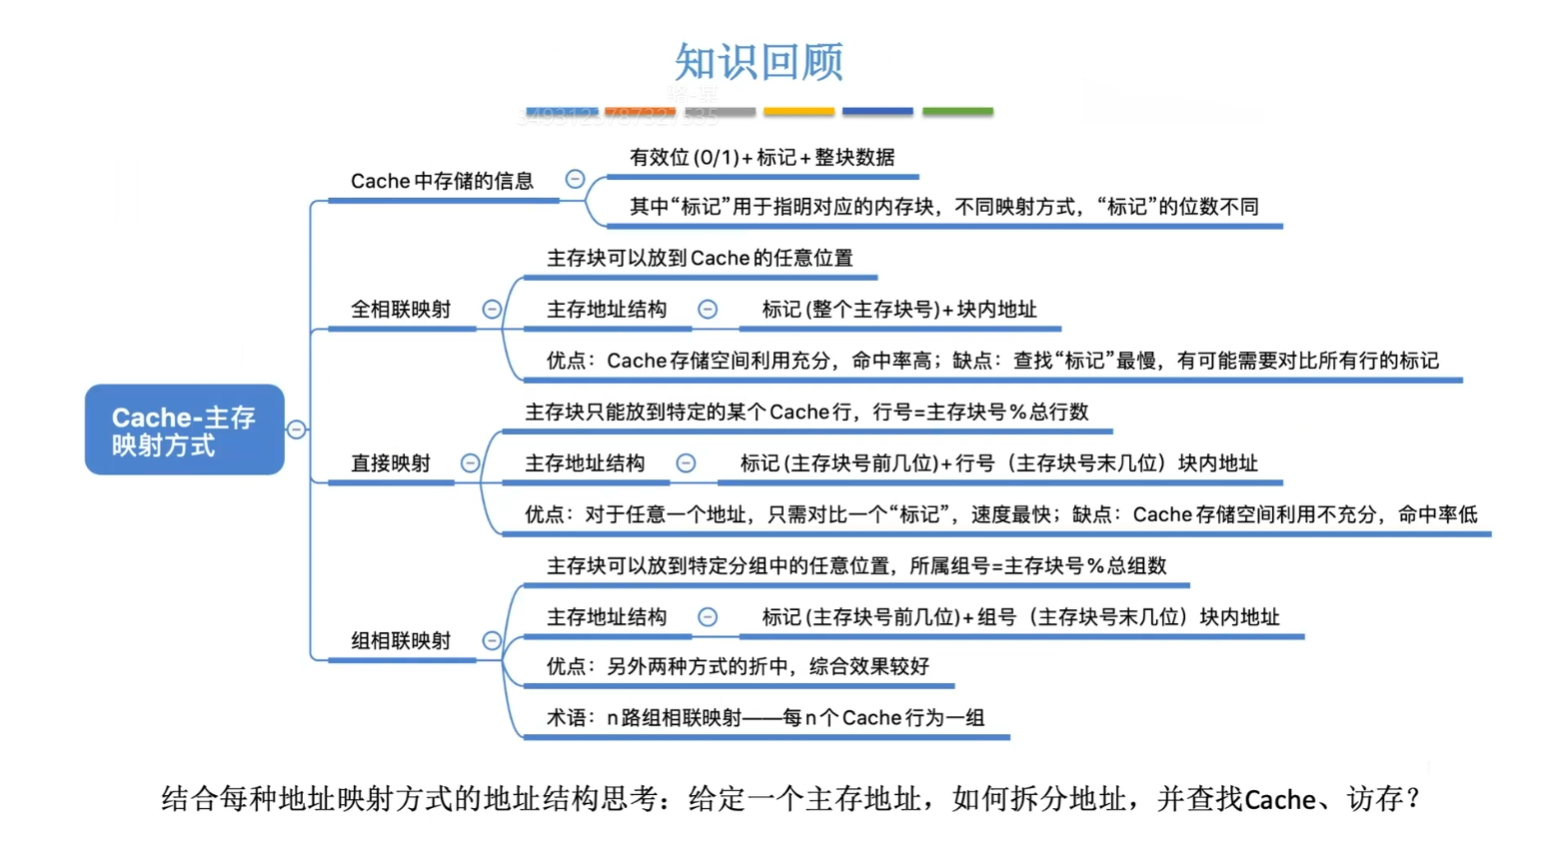
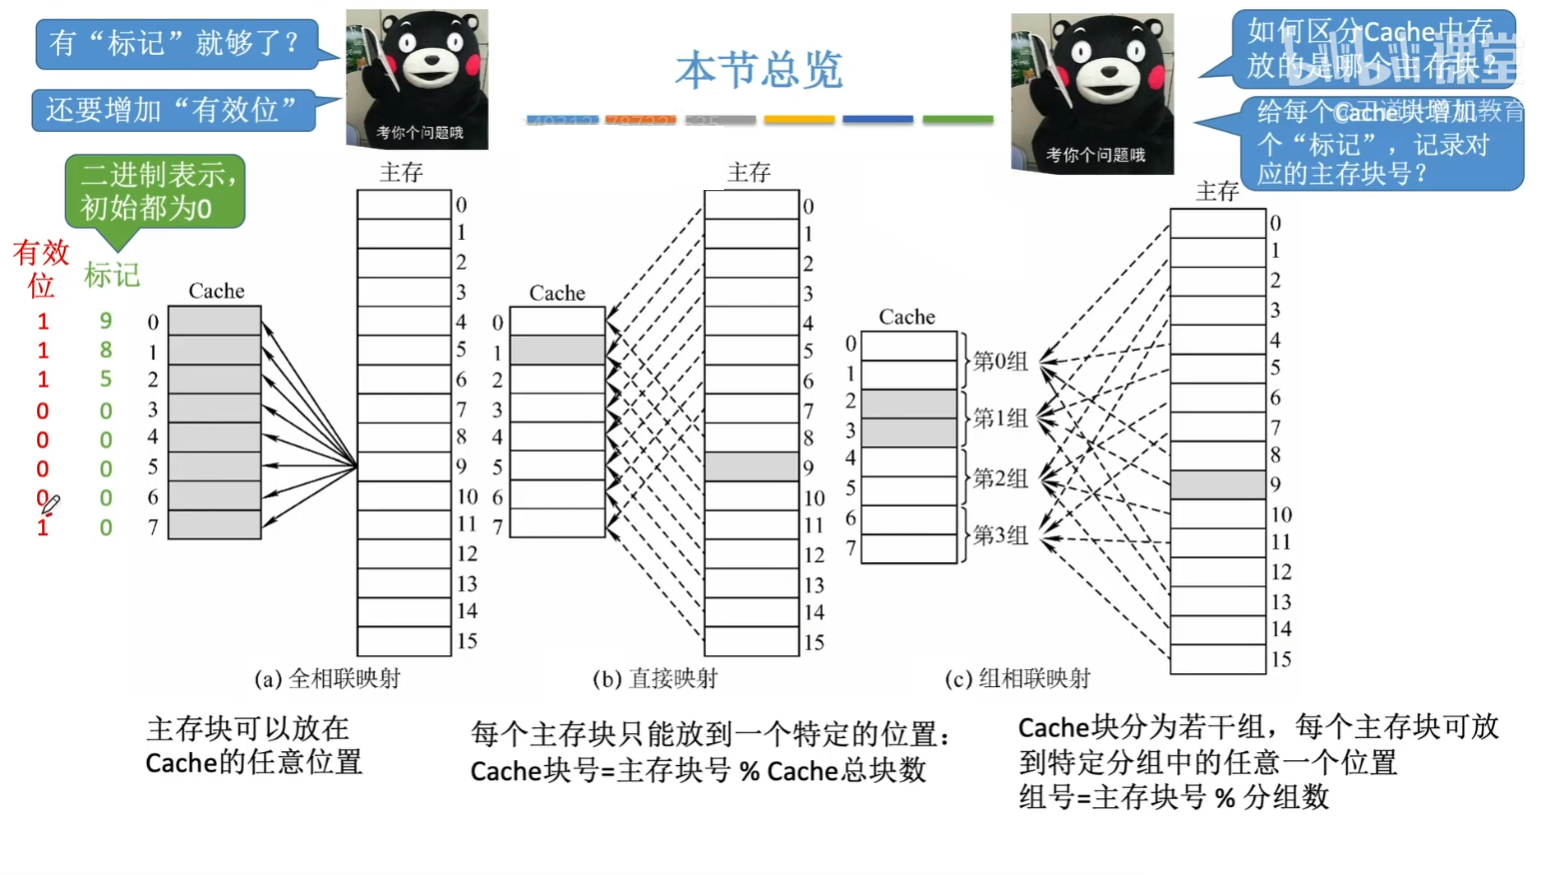
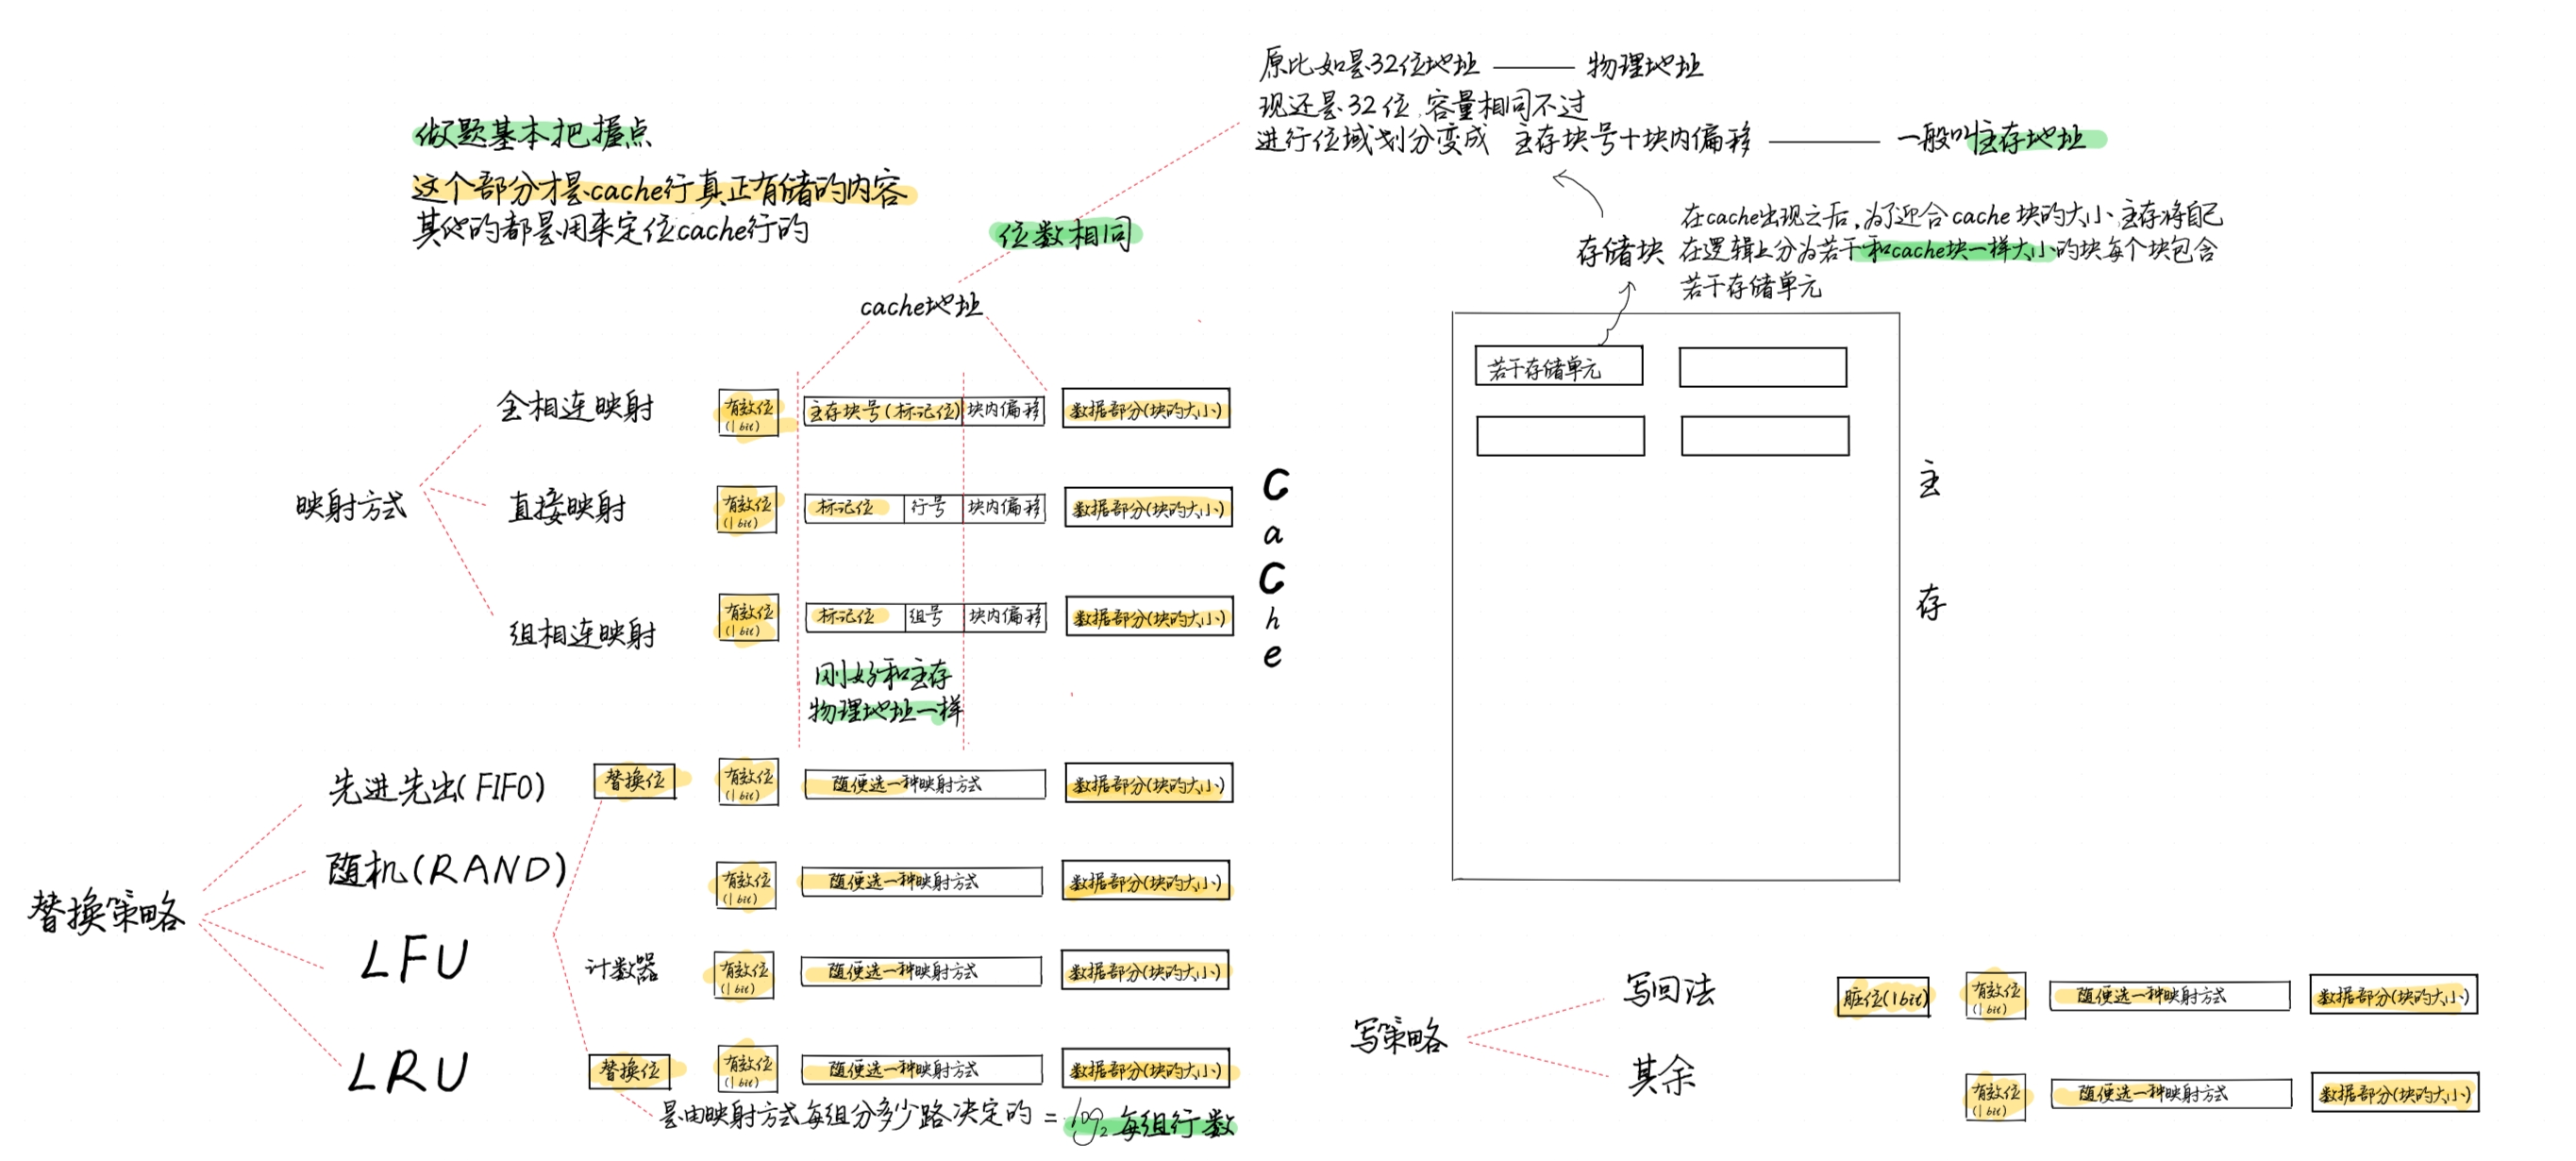
Cache 容量 的计算:
$$ \boxed{Cache容量 = 行数 \times 每行标记位数} $$
每行标记位数包括 写回法的脏位,LRU、FIFO 的替换位,固有的有效位,标记位,数据位。
3.5.2.1 全相连映射
全相连映射,主存中的每一块可以装入 Cache 中的任何位置,如下图所示:
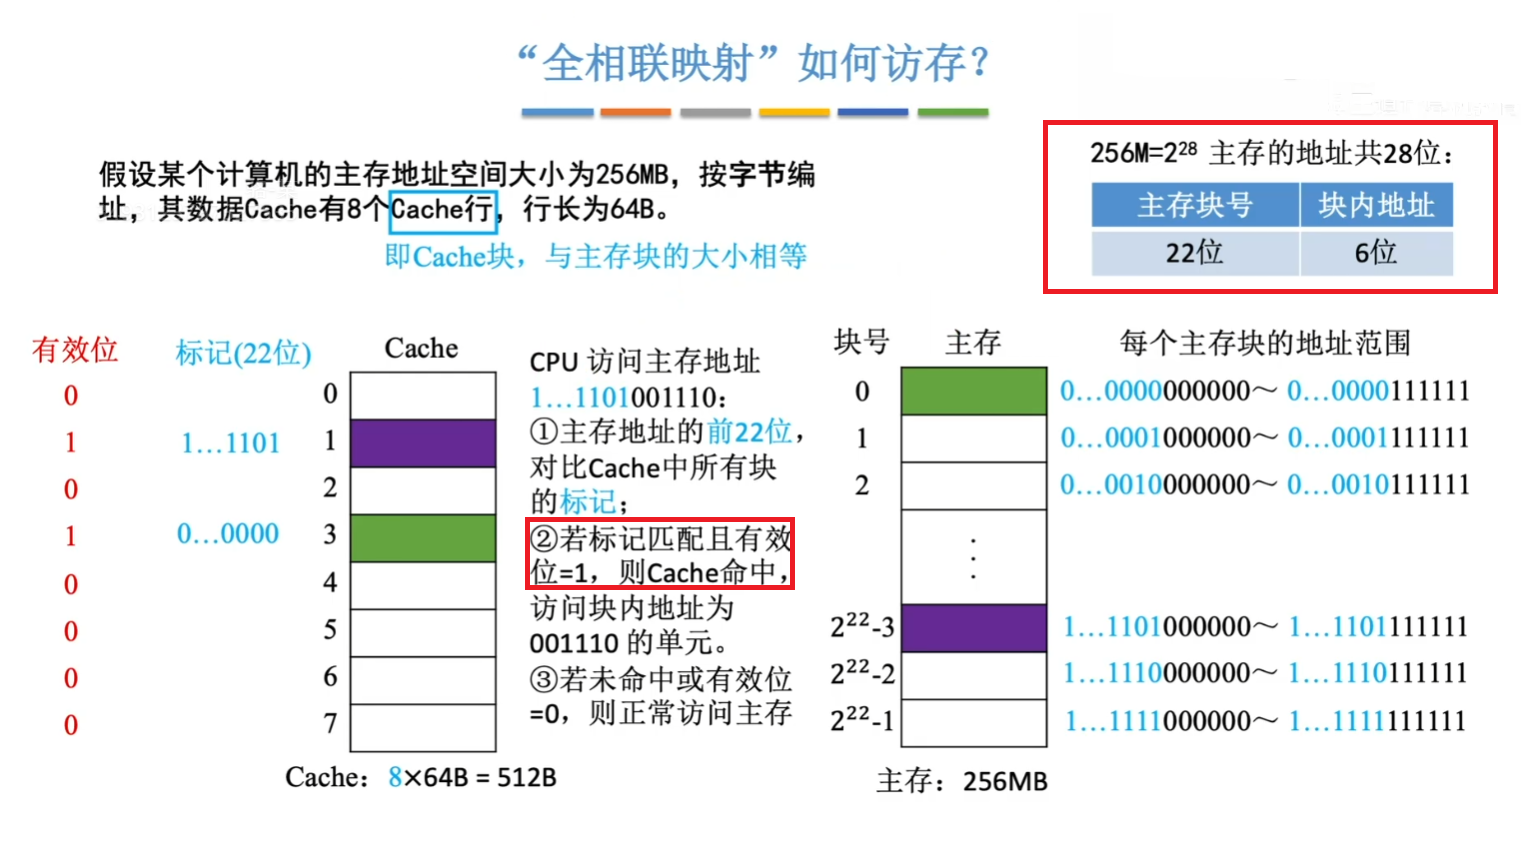
3.5.2.2 直接映射
直接映射,主存中的每一块只能装入 Cache 中的固定 Cache 行,如果出现冲突,会被无条件替换,如下图所示:
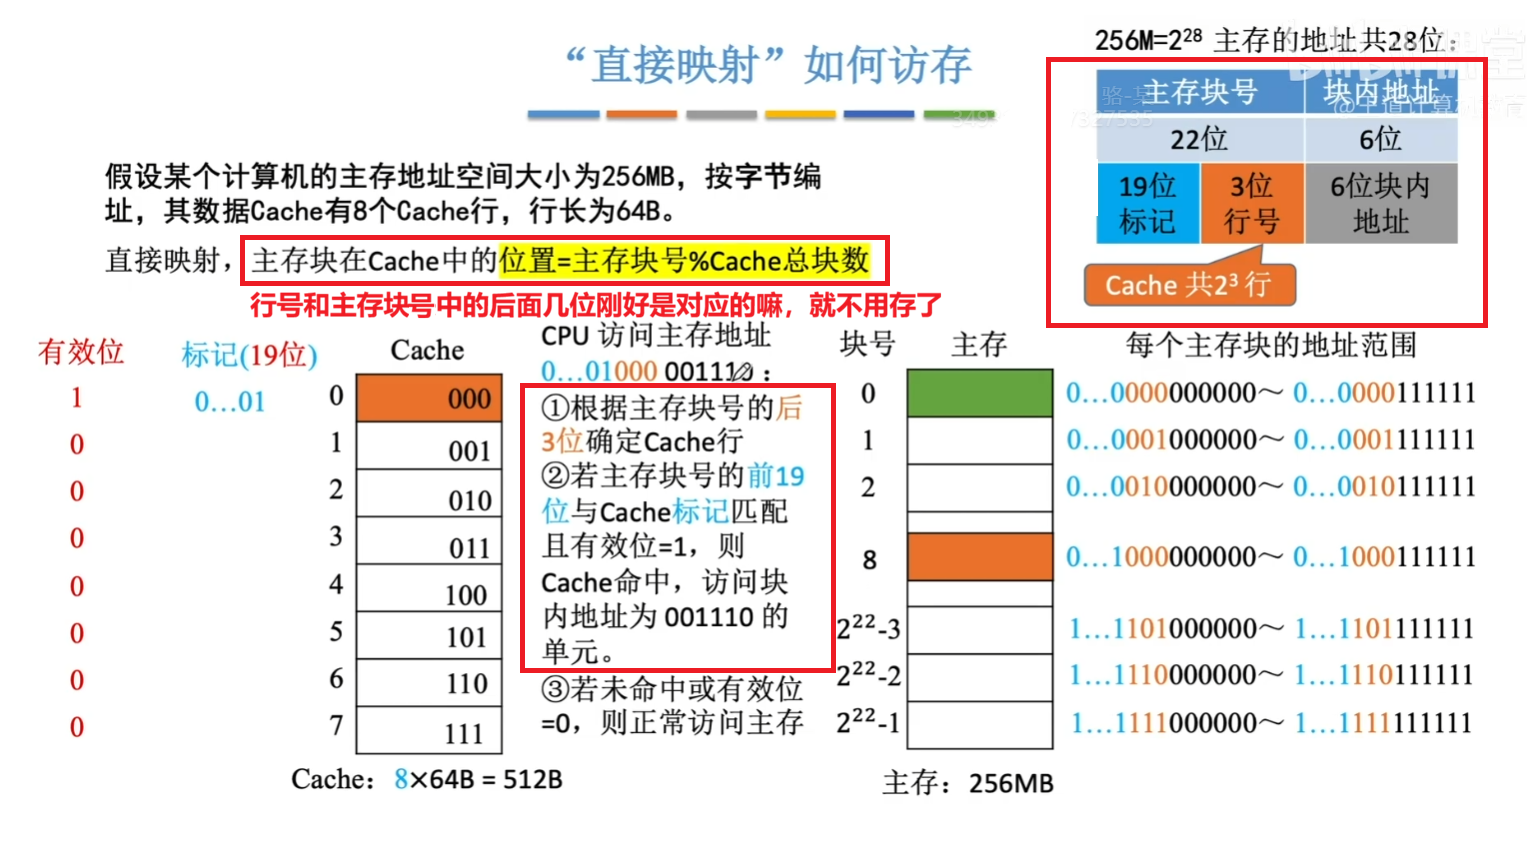
3.5.2.3 组相连映射
组相连映射,主存中的每一块只能装入 Cache 中的固定组的任意一行。如下图所示:
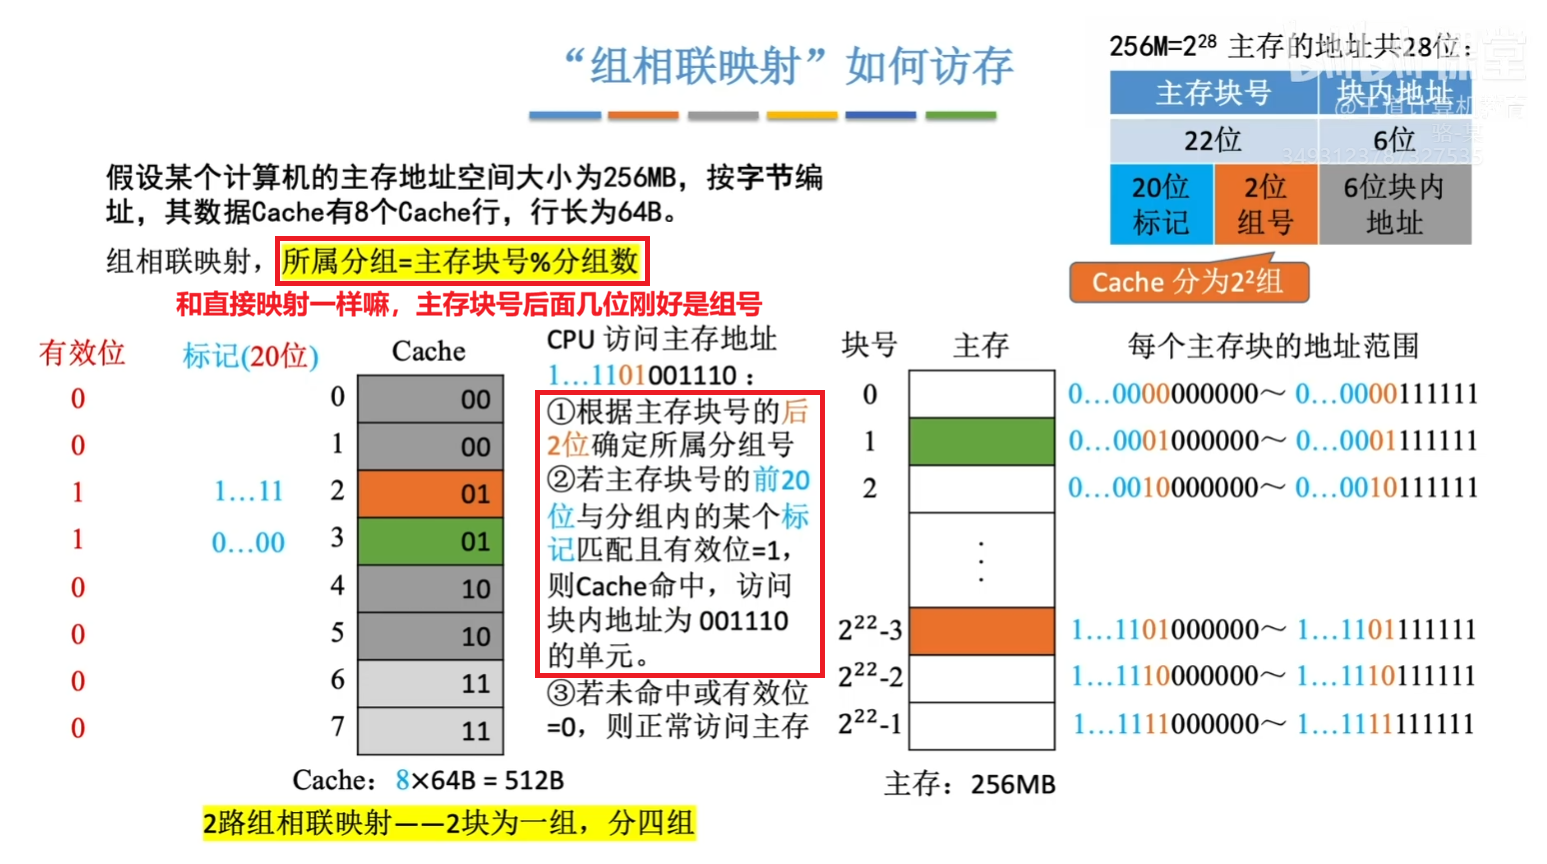
3.5.3 Cache 的替换算法
在采用 全相连映射 或 组相连映射 方式时,当向 Cache 传送一个新主存块而 Cache(或组,组相联映射的替换只在“组内”进行) 已满,就需要使用替换算法选择被替换的 Cache 行。注意,在 直接映射 这种方式中,出现冲突,新块直接覆盖旧块,无需替换算法。
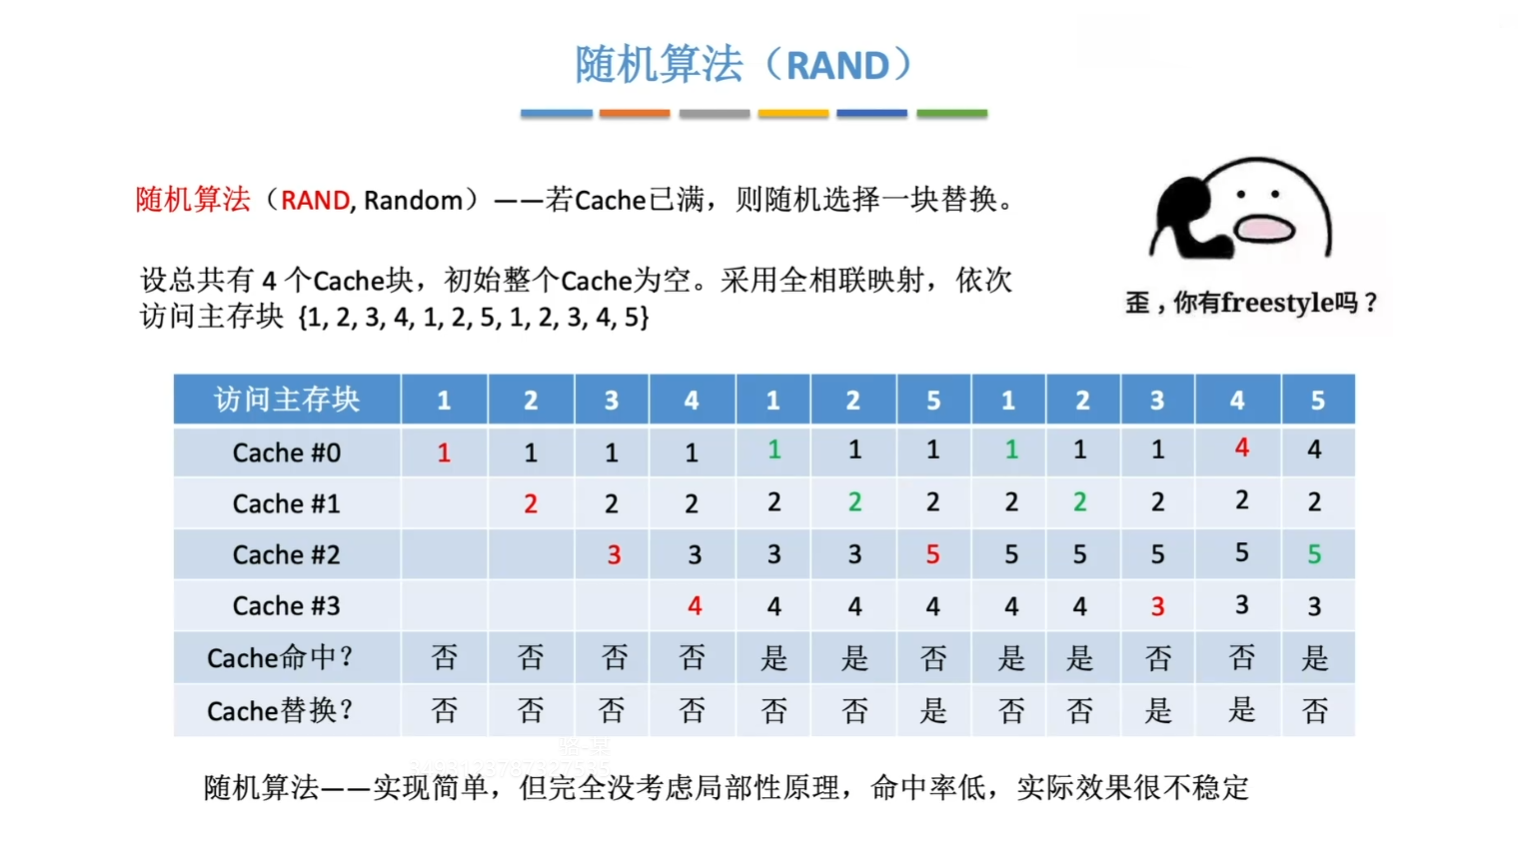
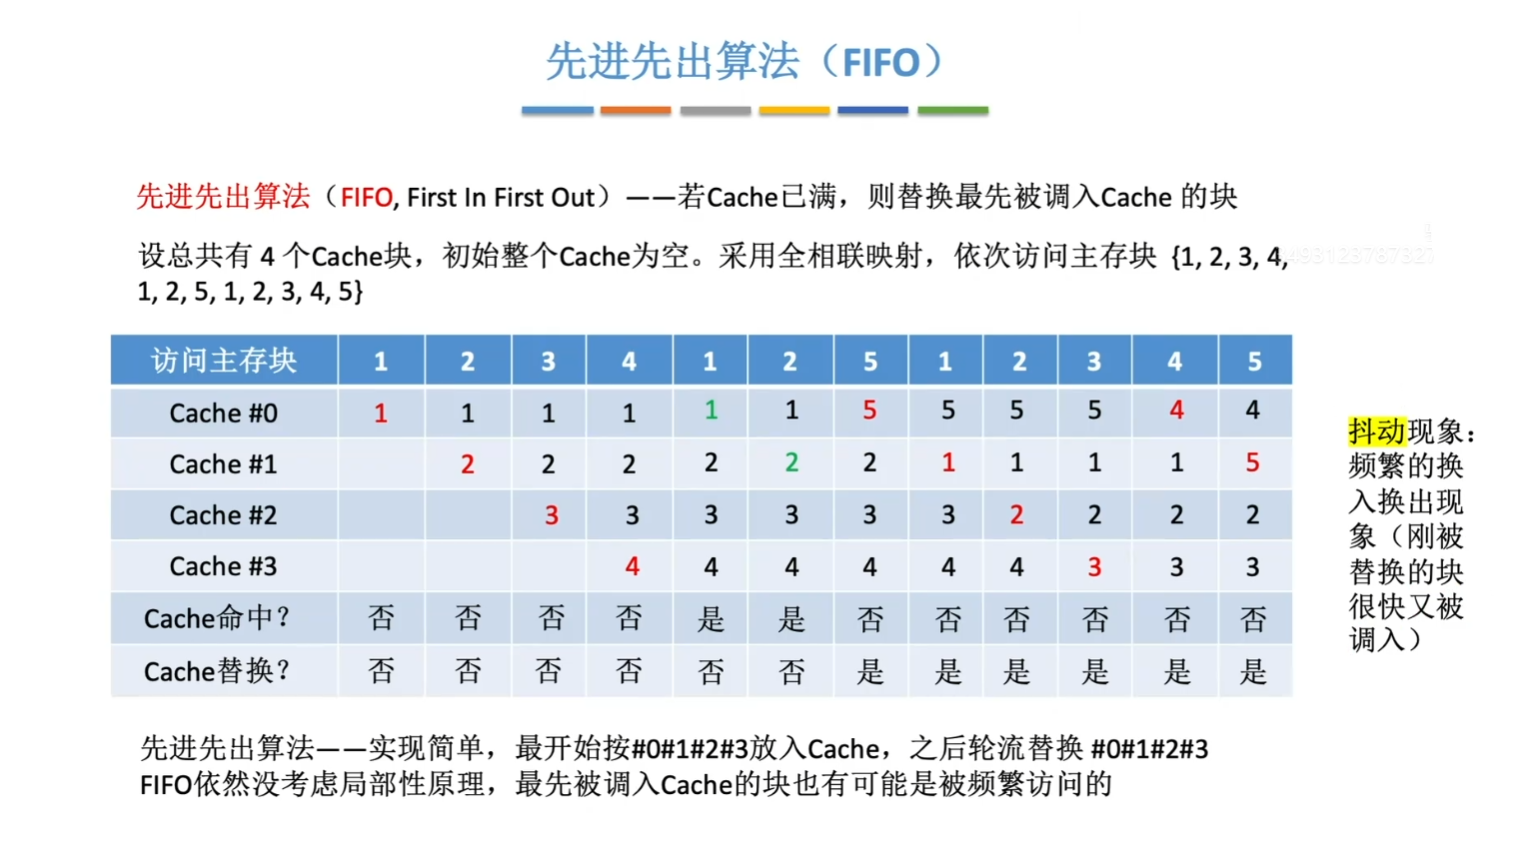
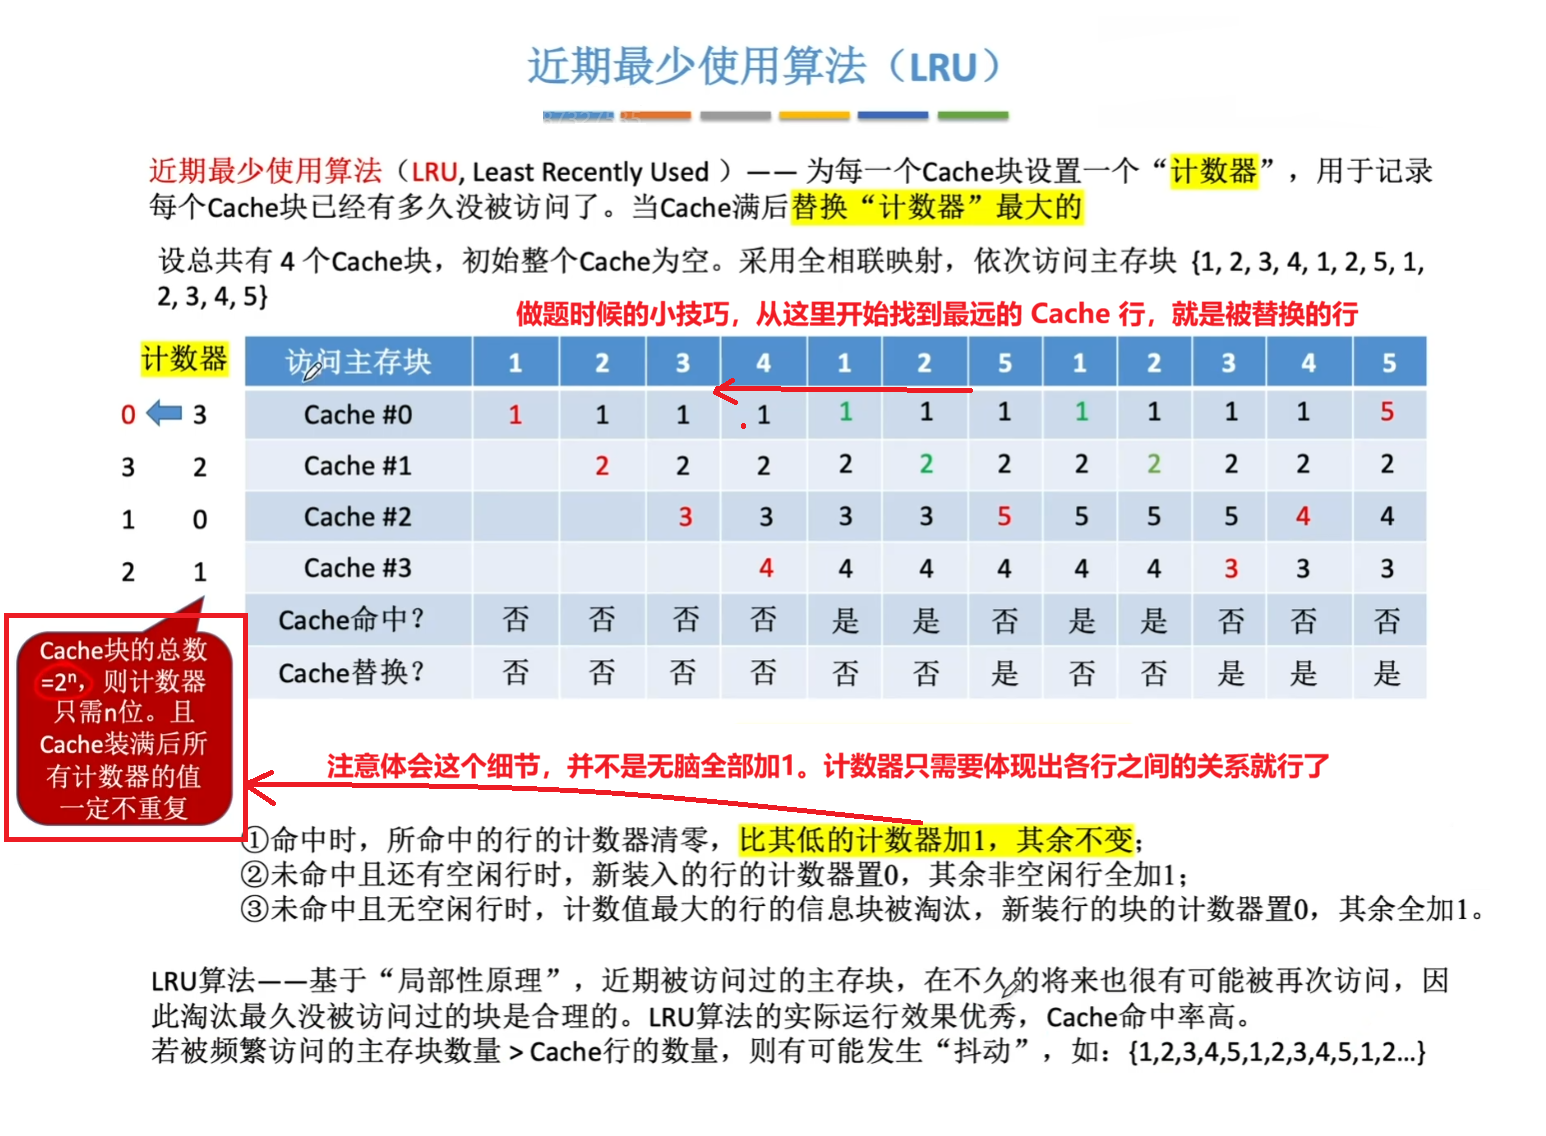
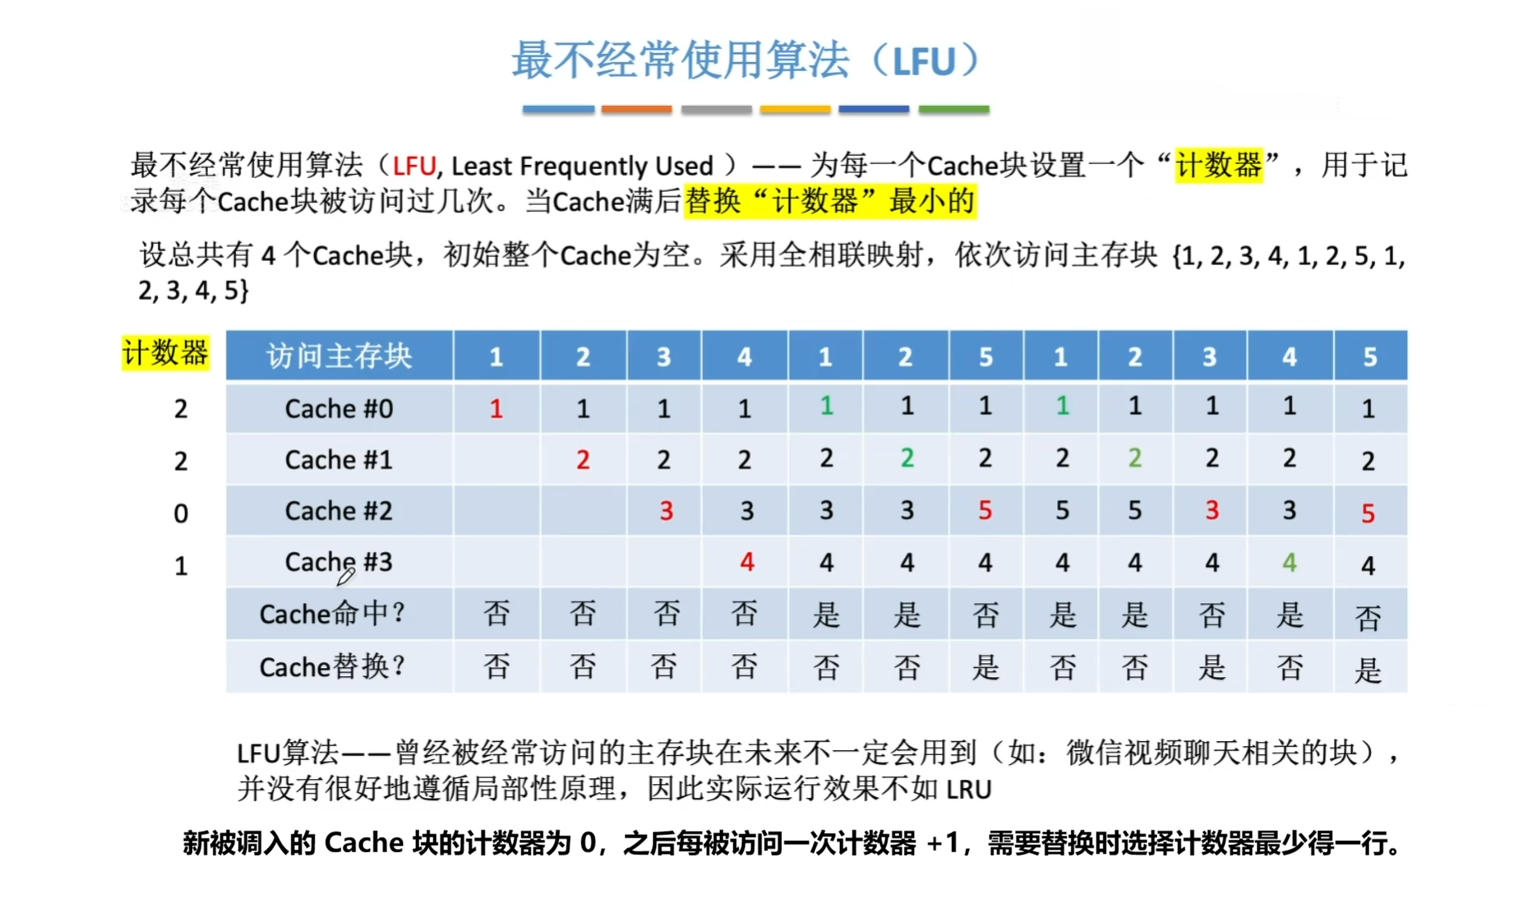
替换算法分为四种:随机算法(RAND),先进先出算法(FIFO),最近最少使用算法(LRU),最不经常使用算法(LFU)。
3.5.3.1 随机算法(RAND)
随机选择一个 Cache 进行替换。实现较为简单,但未利用程序访问的局部性原理,命中率通常较低。
如图所示:
3.5.3.2 先进先出算法(FIFO)
顾名思义,替换最早装入的 Cache 行。实现较为容易,但未考虑局部性原理,最早进入的块可能仍然是当前热点数据,命中率较低。
如图所示:
3.5.3.3 最近最少使用算法(LRU)
基于程序访问的局部性原理,优先替换最近最久未被访问的 Cache 行。在四种替换算法中表现出的性能最优。
如图所示:
3.5.3.4 最不经常使用算法(LFU)
最不经常使用算法,替换一段时间内累计访问次数最少得 Cache 行。没有很好的遵循局部性原理。
如图所示:
3.5.4 Cache 的写策略
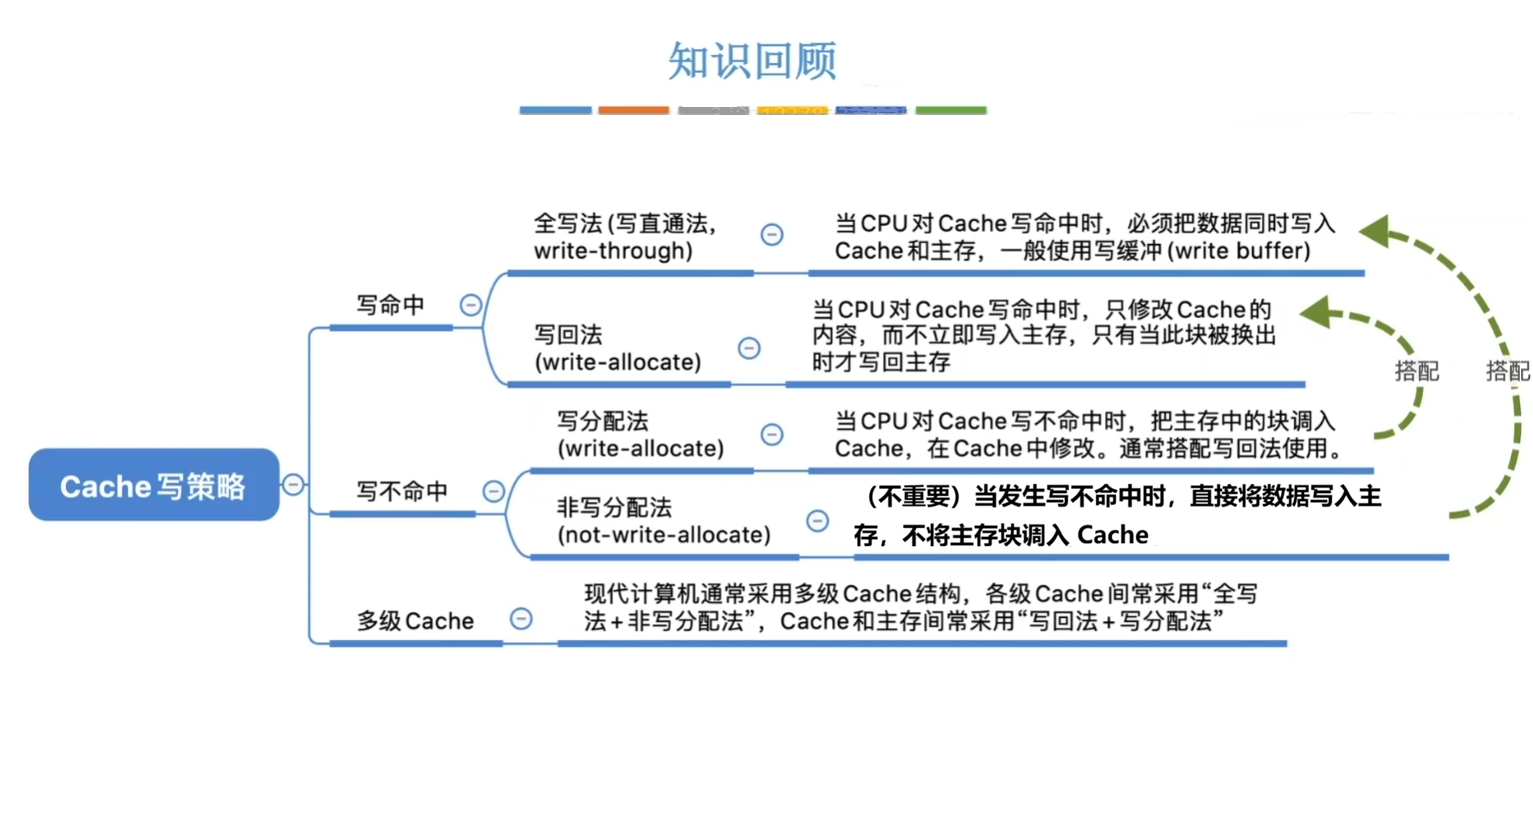
Cache 的写策略主要在于解决 Cache 和主存数据的一致性问题。
本小节思维导图如下:
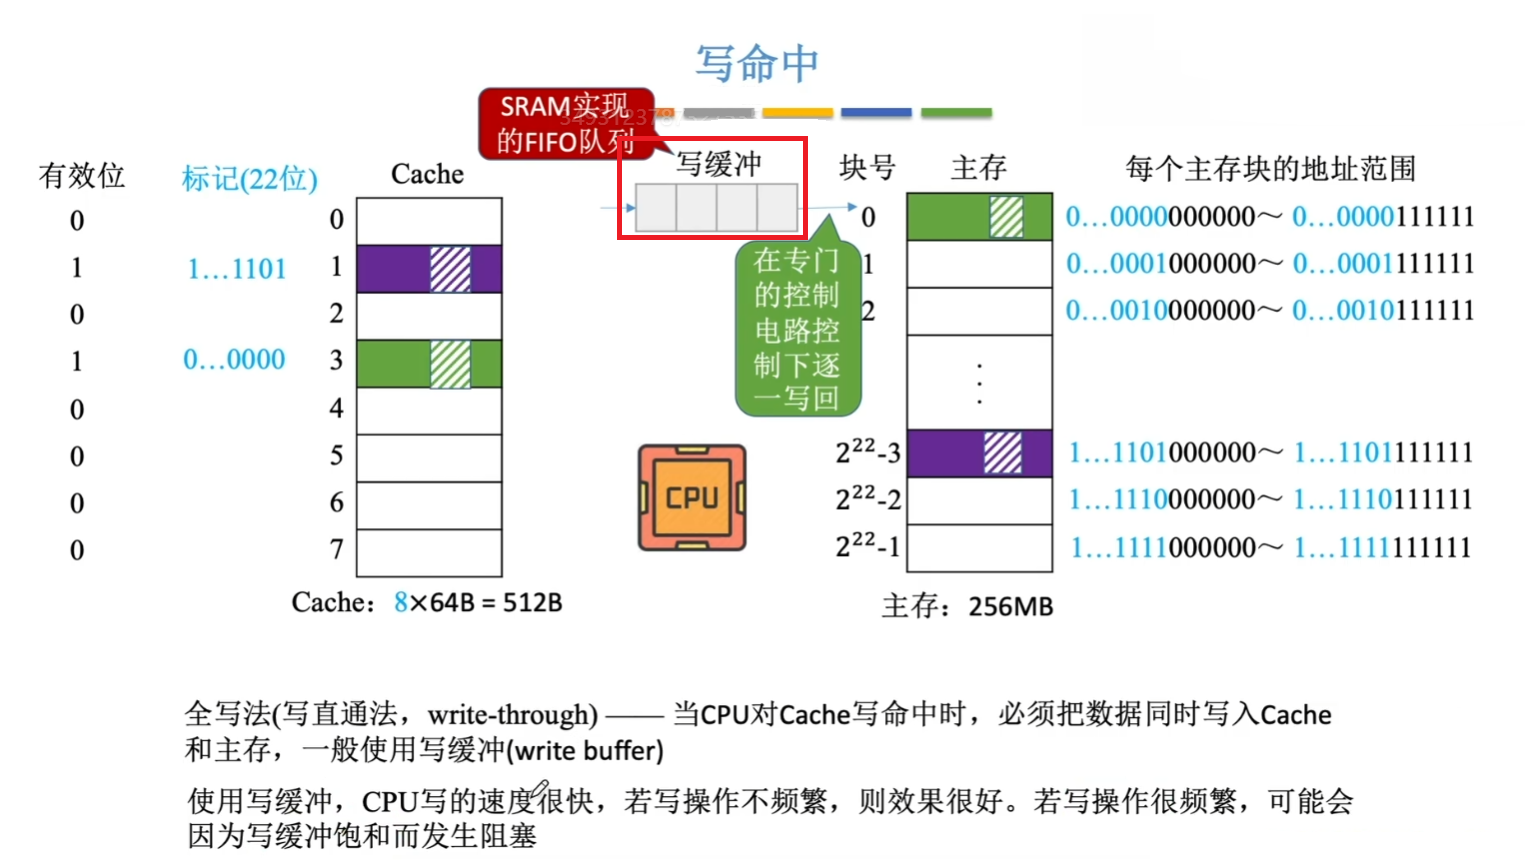
 关于 全写法,顾名思义就是主存和 Cache 都要修改。通常会设置一个 写缓冲,用来缓解性能开销,如图所示:
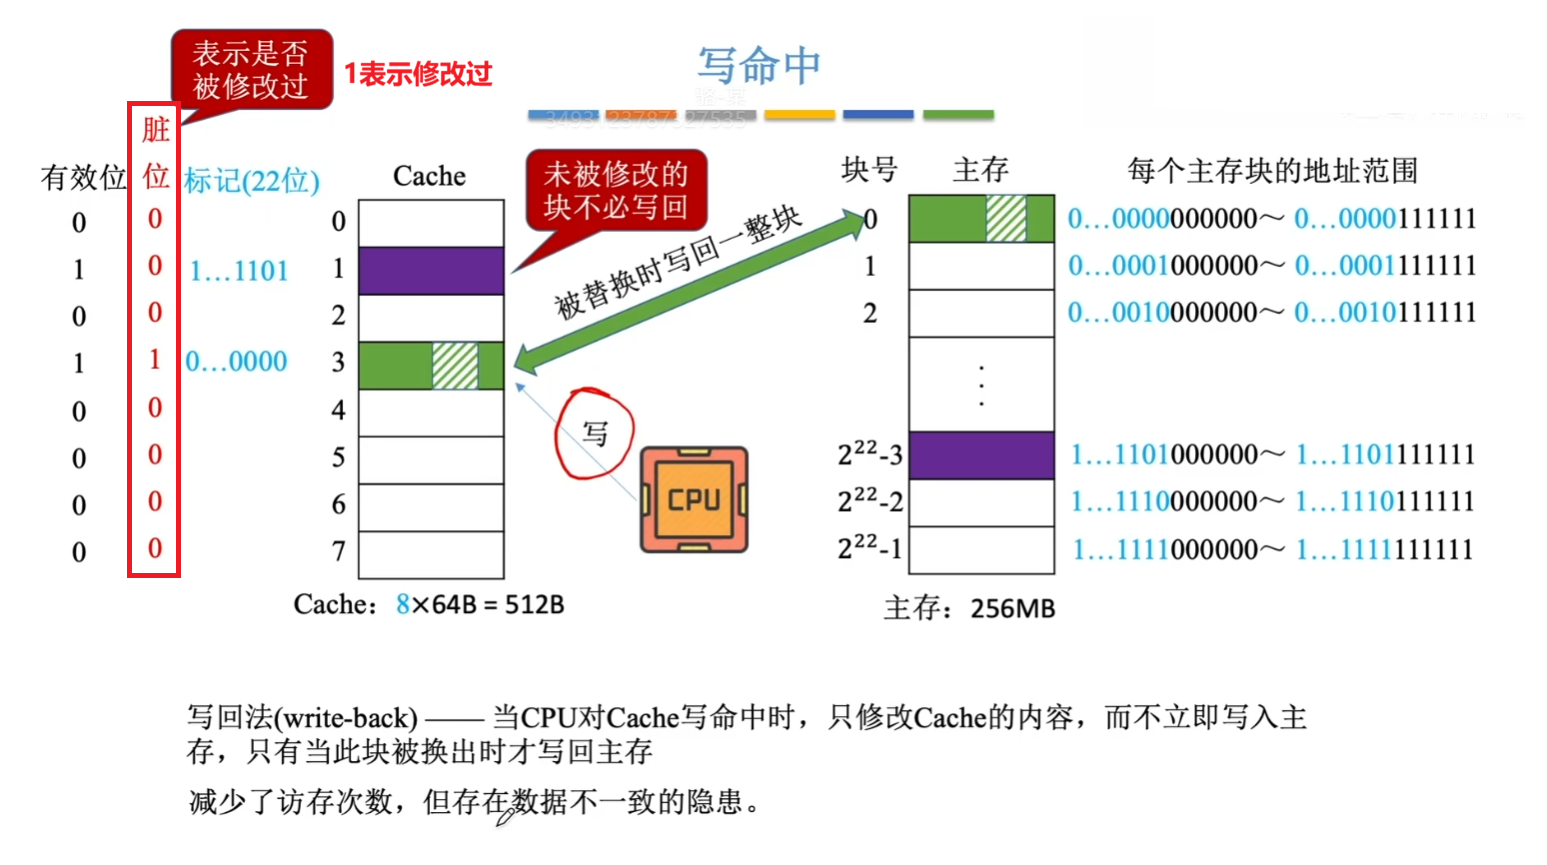
 关于写回法,为了避免不必要的写回操作,通常会在每行加一个修改位(又称脏位),脏位用于表示 Cache 中的该块是否修改过,若为 1 表示修改过,在被替换的时候就需要写回主存。如图所示:
 而关于 写分配法,貌似存在争议,有的书说是在内存中修改了之后放进 Cache,有的说是放进 Cache 再进行修改。
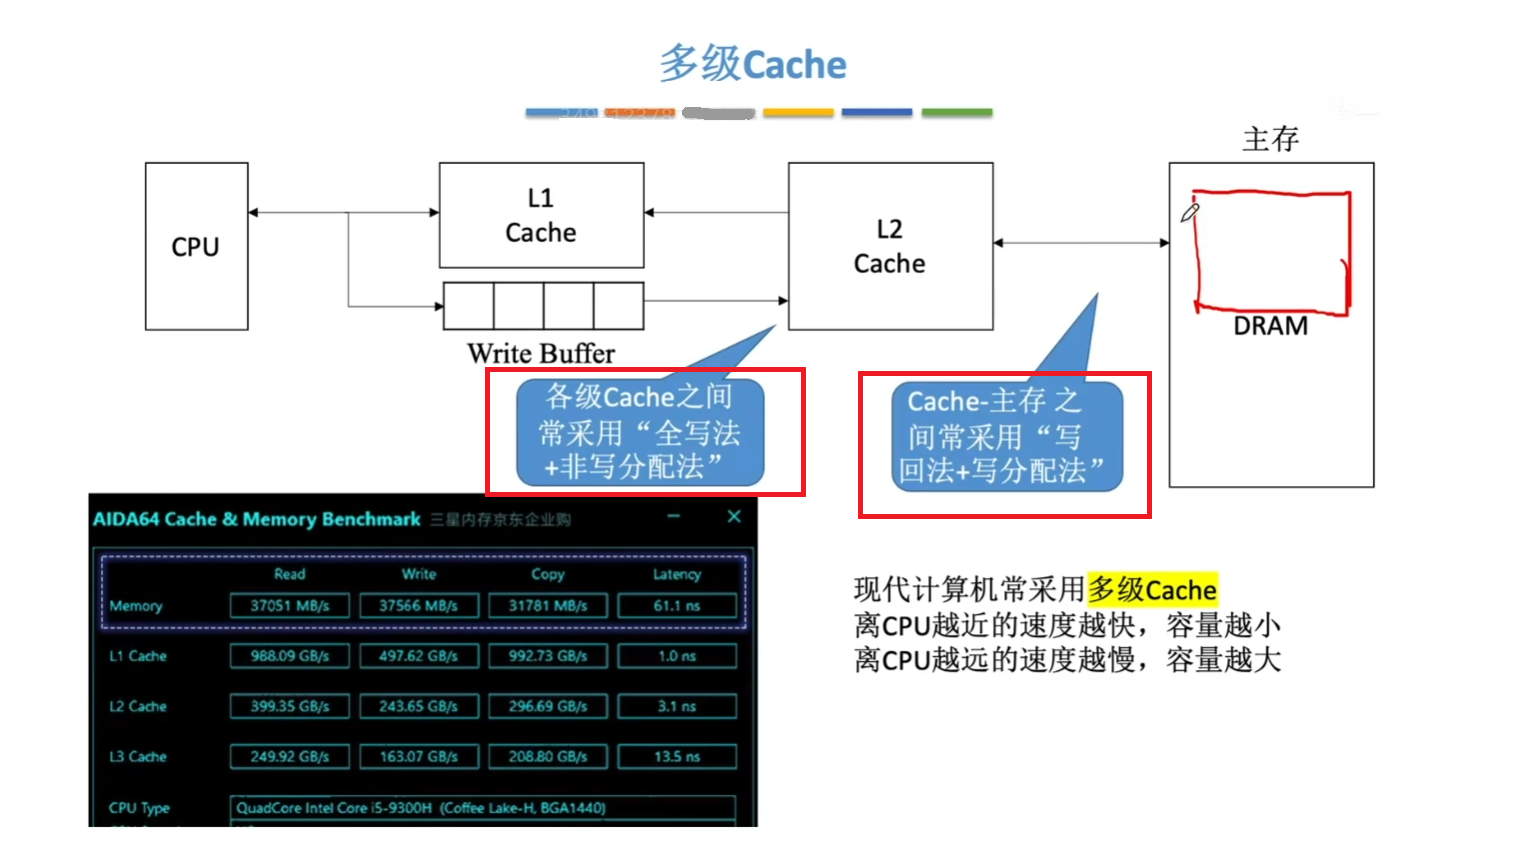
现代计算机采用的多级 Cache 结构如图所示: